[マウムジギ 開発日誌 #18] 推論トークン拡張と2次ファインチューニング結果比較
· 約2分

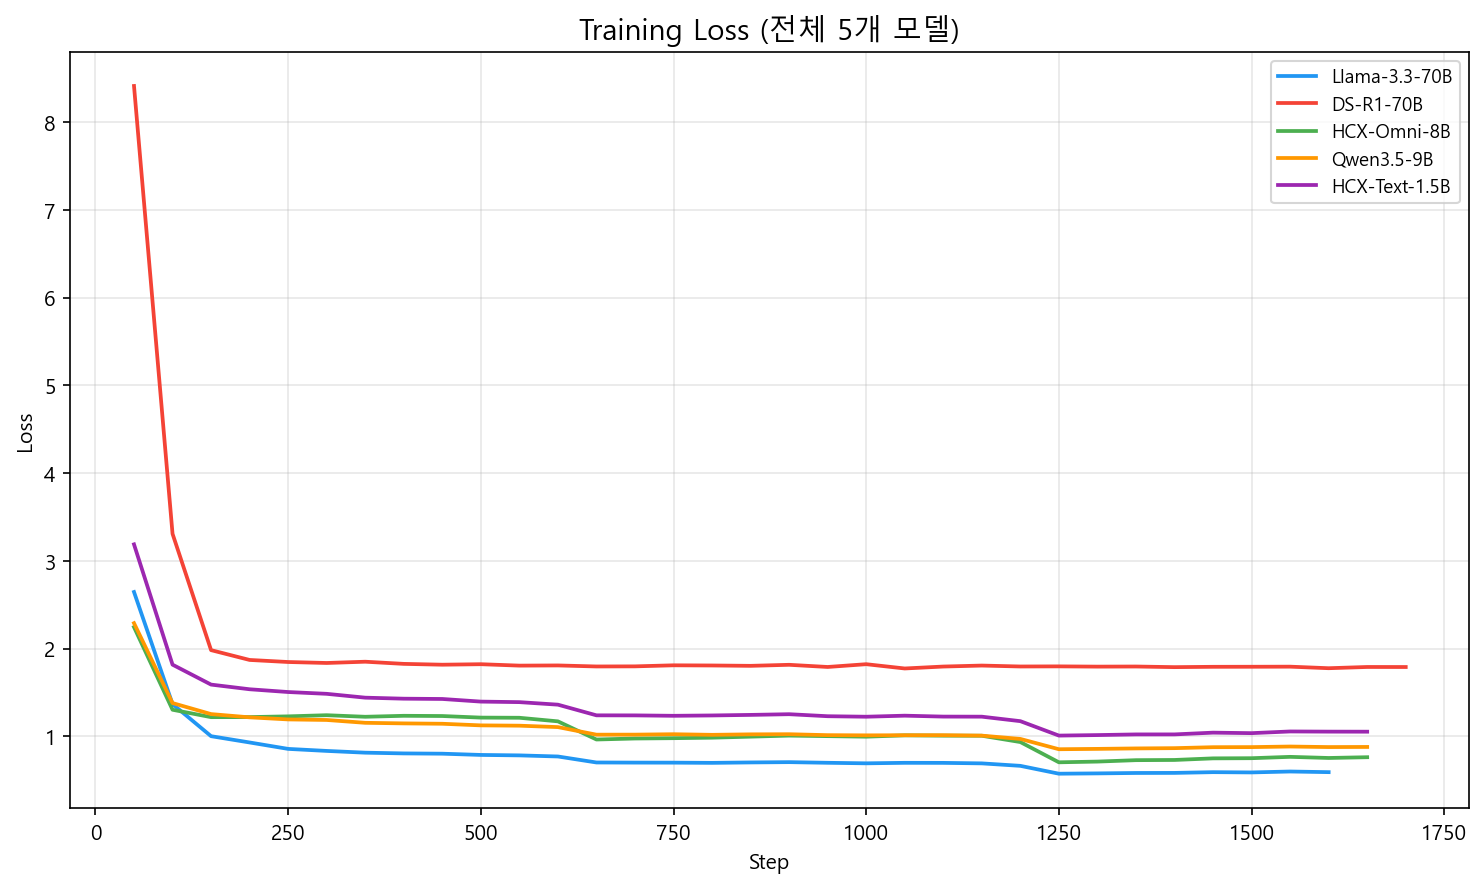
昨日発見したハードコーディングのバグをすべて修正し、ついにまともな2次ファインチューニングモデルの推論(Inference)テストを再開した5月13日です。
短い回答の原因、トークンの長さを増やせ!
推論結果を一つ一つ紐解いていたところ、Llama33-70B_a8モデルが出した回答が相変わらず妙に短く、硬いことに気がつきました。
「これはLlama33-70B_a8の回答の一つです。max_seq_lengthとmax_new_tokensが少なすぎると感じます。増やしたいです。VRAMの現状を見ると、どれくらい増やせますか?」
人工知能(AI)とVRAMの空き容量(当時39.8GB)を計算した末、生成できる最大単語数であるmax_new_tokensを384に思い切って上方修正しました。結果は大成功でした!
単にトークンの許容量を増やしただけなのに、モデルが文脈を最後まで維持し、はるかに深く温かい共感の文章を注ぎ出し始めました。限られたトークン数に閉じ込められ、モデルが自ら言葉を出し惜しんでいたのです。
Alpha値の比較分析(a=8 vs a=16)
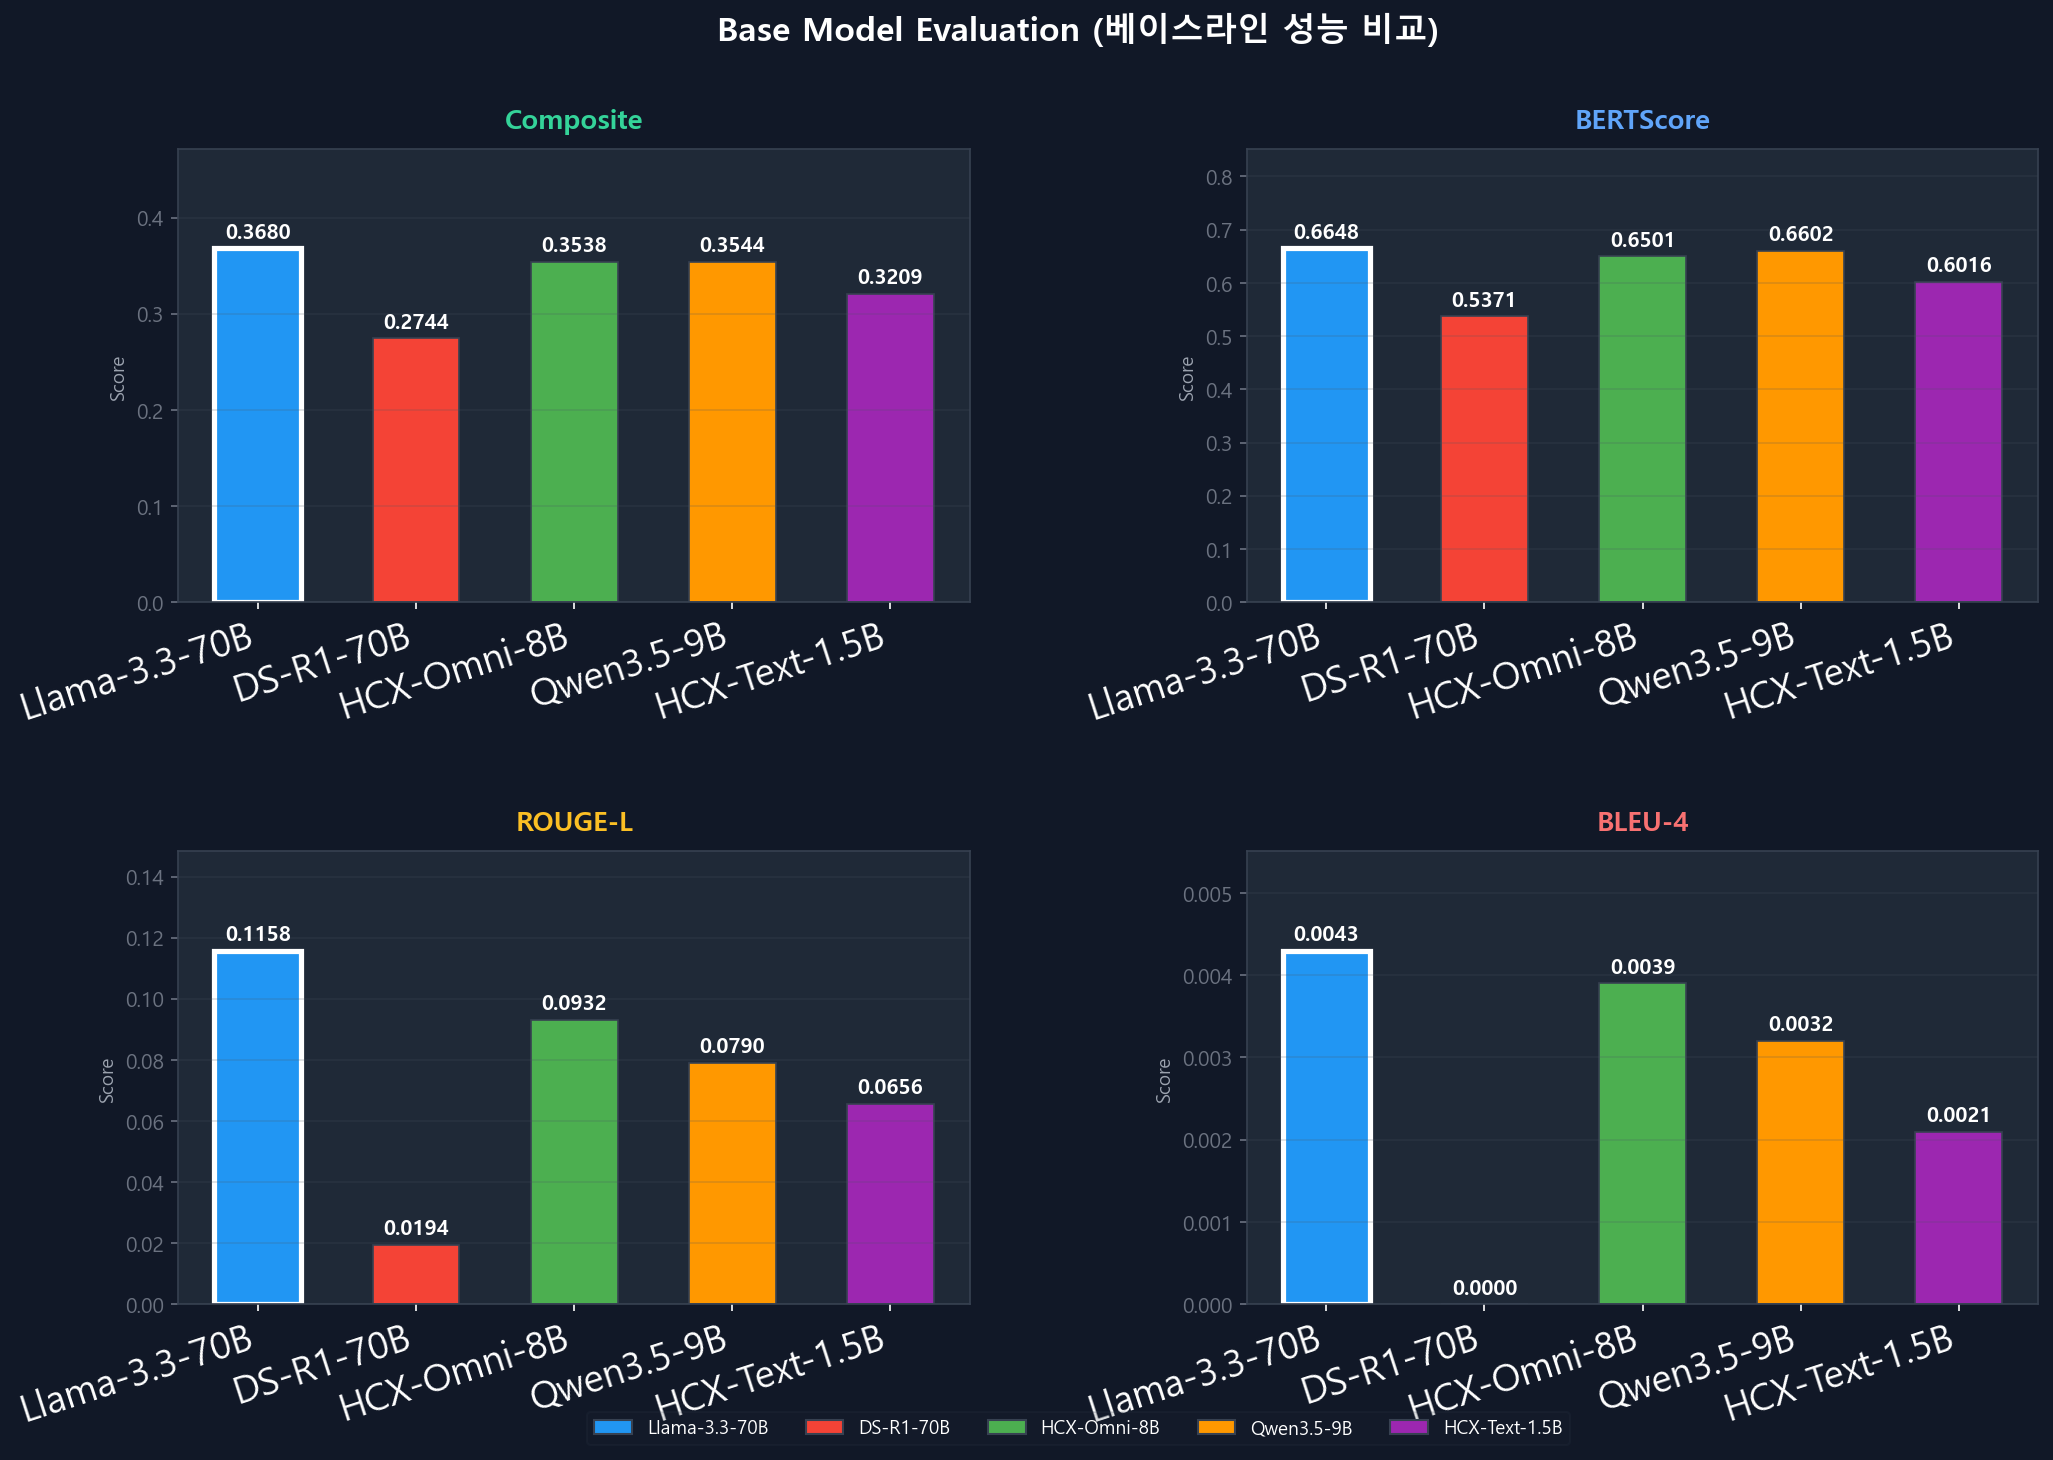
2次ファインチューニングの最大の目的であったLoRAハイパーパラメータalpha値による性能差の結果も出ました。ログを分析して05_alpha_comparison_daily.pngなどのグラフを生成しました。rank=16に固定された状態でalpha=8を与えた時とalpha=16を与えた時で、モデルの過学習(Overfitting)の様相と最終回答の質がどう変わるのかを明確に視覚化することができました。
結果として、正しいハイパーパラメータと十分なトークンの長さを与えられたモデルたちは、ついに私たちが当初企画していた「真のマウムジギ」の姿に近づいていました。中間発表の準備がとても順調に終わりそうです!