[Webots ロボティクス] 表形式Q-Learningの実装と報酬関数(Reward Shaping)の最適化 (#2)
· 約3分

📌 キーポイント (TL;DR)
- 課題(Problem): 目標到達(+1.0)と壁衝突(-1.0)のみが与えられるスパース報酬(Sparse Reward)環境では、エージェントが偶然目標に遭遇するまで数千エピソードにわたり彷徨や空転を繰り返す。
- 解決策(Solution): 目標とのユークリッド距離の変化量に比例するポテンシャル報酬(+0.1 × Δdist)と、ステップ(-0.01)、旋回(-0.01)、後退(-0.05)ペナルティを組み合わせた**多次元報酬シェイピング(Reward Shaping)**を設計。指数減衰ε-Greedy(1.0 → 0.05)戦略を適用。
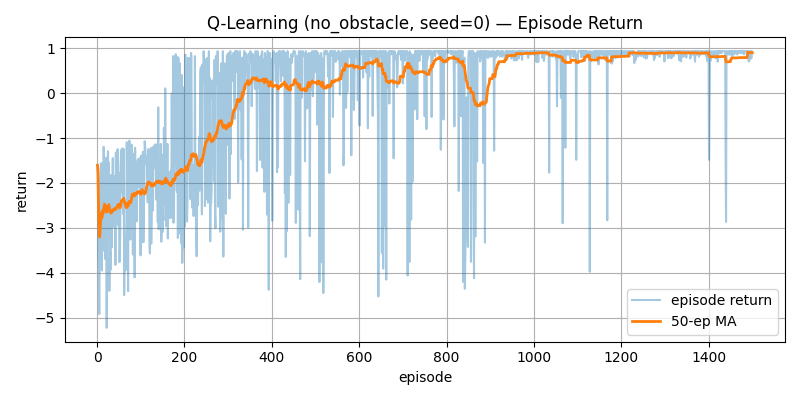
- 成果(Result): 障害物のない環境(
no_obstacle)において500エピソード以内に移動平均報酬が正の値(0.7+)へ到達し、最終的な目標到達成功率98%以上を達成。
1. 表形式Q-Learning更新数式とエージェント設計
表形式Q-Learning(Tabular Q-Learning)は、ベルマン最適方程式に基づく**オフポリシー(Off-policy)時間差学習(TD(0))**アルゴリズムです。
エージェントは行動価値関数 Q(s, a) を表す $648 \times 4$ のNumPy配列を保持し、環境からの遷移タプル $(s, a, r, s', done)$ を受け取って以下の数式でQ値を更新します。
📐 Q-Learning TD(0) 更新式
Target = r + γ * max_a' Q(s', a') * (1 - done)
TD Error = Target - Q(s, a)
Q(s, a) <- Q(s, a) + α * TD Error
- 学習率 (α = 0.1): 新しい経験が既存のQ値に反映される速度を調整。
- 割引率 (γ = 0.99): 将来得られる報酬の現在価値を評価。
- 終端状態処理 (
1 - done): 目標到達や衝突時に将来価値をゼロにマスキング。
2. 指数減衰ε-Greedy戦略
初期学習時は環境の構造を広く知る必要があるため、**ε = 1.0 (100%ランダム探索)**から開始します。
探索率が高すぎると最適な経路を学習しても壁に衝突し続けるため、各エピソード終了時に以下の指数減衰を適用します:
ε_(ep+1) = max(ε_min, ε_ep × 0.995)
- 1エピソード: ε = 1.0
- 300エピソード: ε ≈ 0.22
- 600エピソード: ε = 0.05 (下限到達、95%確率でGreedy行動を実行)
3. スパース報酬を克服する報酬関数の設計
| 報酬項目 | 設定値 | 設計意図と物理的効果 |
|---|---|---|
目標到達 (REWARD_GOAL) | +1.0 | 目標到達成功時の正の終端報酬 |
壁・障害物衝突 (REWARD_COLLISION) | -1.0 | 衝突失敗時の厳格なペナルティ |
距離差分報酬 (REWARD_DELTA_SCALE) | +0.1 × Δdist | 目標へ近づいた距離に応じた即時報酬 |
ステップ時間ペナルティ (REWARD_STEP) | -0.01 | その場停止を防ぎ最短時間走行を誘導 |
旋回ペナルティ (REWARD_TURN) | -0.01 | 不要なコマ回し回転行動を抑制 |
後退ペナルティ (REWARD_BACKWARD) | -0.05 | 非効率な後退を抑え前進走行を推奨 |
4. 学習曲線と成功率の検証
1,500エピソードの学習を実施した結果、理論通りの収束を確認しました。
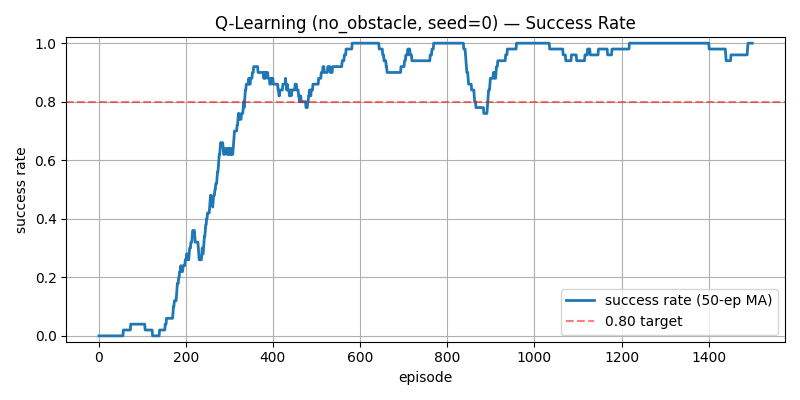
100回移動平均成功率は 98.5% を超え、エピソードあたりの平均ステップ数は150(タイムアウト)から 15〜22ステップ まで大幅に短縮されました。
5. 次回予告
次回第3回では、12個の壁が配置された obstacle12 および高難易度 obstacle_hard 環境における局所的最適解(Local Minima)の罠と、複数シード並列学習について解説します!