Stanford CS329A (第11回): Agent Memory — 長短期記憶とOS型階層メモリ (MemGPT, Cartridges, CacheBlend)

自律型AIエージェントを長期的な開発パートナーや自律エンジニアとして実務に導入すると、誰もが次の3つの深刻な構造的ボトルネックに直面します:
- 「昨日時間をかけて議論し決定した重要なアーキテクチャ方針を、今朝のセッションで完全に忘れてしまう。」
- 「10万行の大規模コードベースを100万トークンのコンテキストウィンドウに丸ごと投入すると、途中の重要コードを見落とし(Lost-in-the-Middle現象)、1ターンごとに数ドルのAPIコストが吹き飛ぶ。」
- 「RAGエージェントが検索した複数ドキュメントのチャンク(Chunk)をプロンプト内で結合すると、プレフィックスKVキャッシュが無効化され、最初のトークン生成時間(TTFT)が数秒単位で遅延する。」
人間の脳は物理的に限られた作業記憶(わずか4〜7個のチャンク)しか持たないにもかかわらず、数十年前の記憶を瞬時に引き出し、新たな領域の知識を認知麻痺なく統合することができます。
Stanford CS329A: Self-Improving AI Agentsの**Part 3: エージェントエンジニアリング(Agent Engineering)**第2弾となる本講義では、Agent Memory Architectureを探求し、自律システムに永続的かつ階層的な記憶力を与える3つの主要な抽象化レイヤーを解説します:
- ソフトウェア制御層 (MemGPT, UC Berkeley 2023): OSの仮想メモリページングを模した階層型メモリ管理
- ニューラル表現層 (Cartridges, 2025): 自主学習(Self-Study)を通じて大量文書を小型かつモジュール化された連続KVベクトルに蒸留
- システムインフラ層 (CacheBlend, EuroSys 2025): チャンク間クロスアテンションを選択的に再計算しTTFTを3.3倍短縮するKVキャッシュ融合
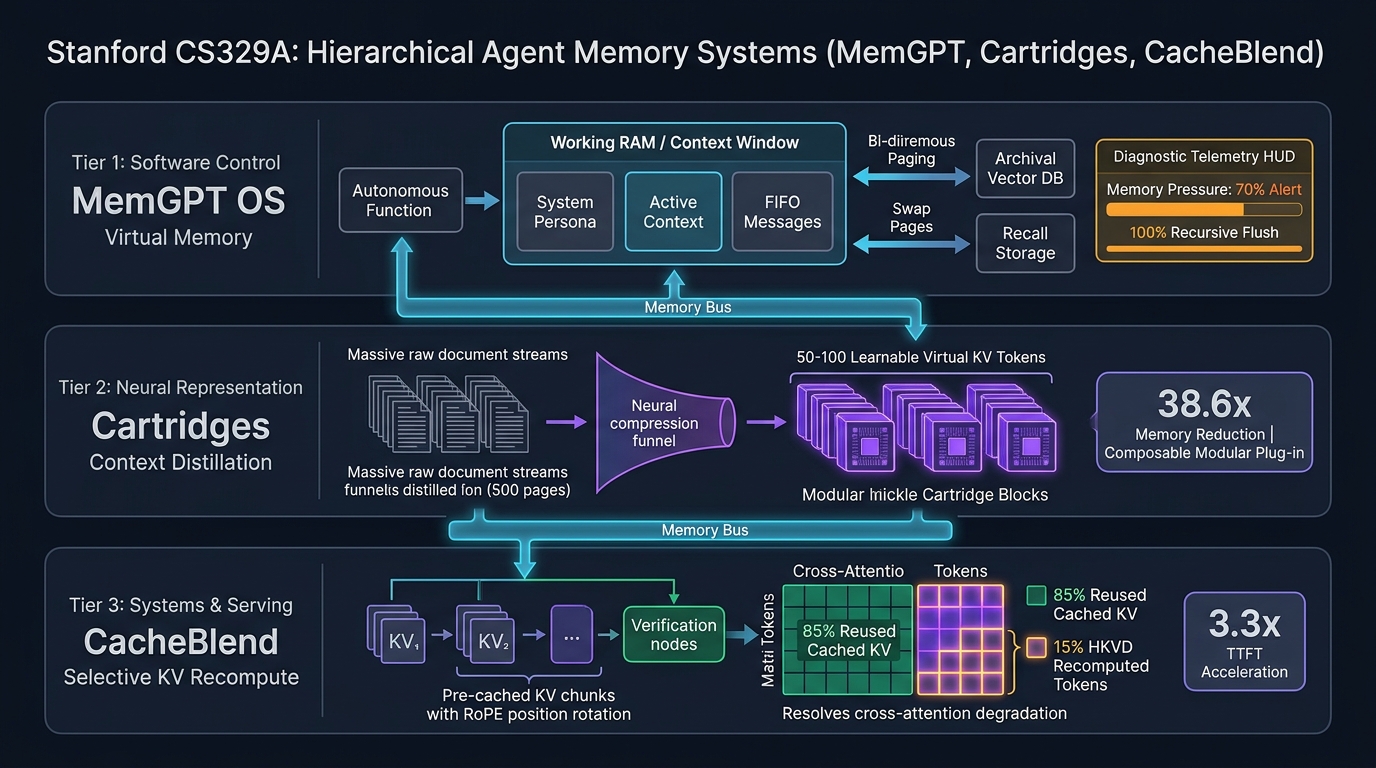
1. 長期コンテキストのジレンマと階層メモリの必然性
LLMの物理的なコンテキストウィンドウ(例:8kから1M+トークンへ)を単純に拡張するだけでは、エージェントの記憶問題は解決できません。力任せのウィンドウ拡張は、次の3つの根本的な限界を生み出します:
- 注意の散乱とLost-in-the-Middle: トランスフォーマーのセルフアテンションは長大コンテキストにおいて注意分布が平坦化し、プロンプト中央に埋もれた微細な情報を容易に見落とします。
- 経済的持続不可能性: 毎ターンごとに数十万トークンのプロンプトを繰り返し送信することは、APIコストを天文学的に膨張させます。
- 静的揮発性: セッションが終了すると活性化状態(Activation)は消滅するため、エージェントが自律的に自己の同一性や知識を蓄積できません。
これらを克服するため、最新のエージェント構造は高速な作業コンテキスト(Working Context)と大容量の長期ストレージ(Long-Term Storage)を明確に分離するHierarchical Context Managementを採用しています。
┌─────────────────────────────────────────────────────────────────────────┐
│               エージェント記憶システムの3大抽象化スタック                │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│   ソフトウェア制御層     │  │     ニューラル表現層     │  │    システムインフラ層    │
│         (MemGPT)         │  │       (Cartridges)       │  │       (CacheBlend)       │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • OS型仮想ページング     │  │ • Self-Study知識蒸留     │  │ • 複数チャンクRAG結合    │
│ • メインコンテキスト(RAM)│  │ • 連続型KV埋め込み       │  │ • 選択的KV再計算 (15%)   │
│ • 外部ベクトルDB (Disk)  │  │ • メモリ消費量 38.6倍削減│  │ • RoPE回転変換補正       │
│ • 自律的退避と再帰的要約 │  │ • スループット 26.4倍向上│  │ • TTFT遅延を3.3倍短縮    │
│ • 深層記憶想起(DMR) 92%  │  │ • レゴ型モジュール結合   │  │ • F1正解率誤差 < 0.01    │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. ソフトウェア制御層: MemGPT (UC Berkeley 2023)
コンピュータのOSは、限られた物理RAMを持ちながら、MMU(メモリ管理ユニット)を通じてハードディスクとの間でページを交換(Swap-in / Swap-out)することで、無限の仮想メモリ空間を実現してきました。
UCバークレー校の研究チームが発表したMemGPT Long-Term Memoryは、このOSの知恵を言語モデルに直結させました:
「LLMのプロンプトウィンドウは物理RAMである。外部のベクトルDBやSQLログはハードディスクである。モデル自身が関数呼び出し(Function Calling)を通じて不要な記憶をディスクへ退避させ、必要な記憶をRAMへ呼び出せばよい。」
    ┌────────────────── [Main Context (RAM: 8k〜128kトークン制限)] ────────────────┐
    │ 1. System Instructions : コアアイデンティティとメモリ操作マニュアル (Read-only)│
    │ 2. Working Context     : ユーザー情報・ペルソナ要約 (Read/Write)             │
    │ 3. FIFO Message Queue  : 直近の会話キュー + 先頭の再帰的過去要約ブロック      │
    └─────────────────────────────────────────────────────────────────────────────┘
                               ▲                      │
               (スワップイン / Search)                 │ (スワップアウト / Evict & Flush)
                               │                      ▼
    ┌───────────────── [External Context (Disk: 無制限ストレージ)] ────────────────┐
    │ 1. Recall Storage   : タイムスタンプ付き全会話履歴DB (PostgreSQL)            │
    │ 2. Archival Storage : 数百万件の大規模文書ベクトル埋め込みDB (HNSW)          │
    └─────────────────────────────────────────────────────────────────────────────┘
自律型ページング機構
外部スクリプトによる強制的なコンテキスト切り捨てではなく、モデル自身が自律的に記憶を管理します:
- メモリ逼迫警告(70%しきい値): 会話が蓄積しメインコンテキストの70%に達すると、システム割り込みが静かに通知されます:
「警告: メモリ使用量が70%に達しました。退避前に重要な情報は
working_context.replace()で永続化してください。」 - 自動フラッシュと再帰的要約(100%上限):
- 100%に達するとFIFOキューマネージャーが最も古い50%の会話を切り出します。
- 単に消去するのではなく、既存の要約と切り出されるメッセージを統合し、**新たな再帰的要約(Recursive Summary)**を作成してキュー先頭に配置します。切り出された生のメッセージは
Recall Storageへ移管されます。
- 自律的心拍想起(Heartbeat Chaining):
- ユーザーが数か月前の会話について質問すると、モデルは自ら
recall_storage.search()を呼び出し、request_heartbeat=trueを設定してディスクからRAMへ記憶を読み出し、途切れることなく連鎖推論を行います。
- ユーザーが数か月前の会話について質問すると、モデルは自ら
ベンチマーク結果: 深層記憶想起(DMR)
数十セッションにまたがる長期記憶ベンチマーク(DMR)において:
- 静的コンテキストの通常GPT-4は正解率**32.1%**に低迷しましたが、
- MemGPTはセッション数が増加しても92.5%の高精度を維持しました。
- 複数ホップのキーバリュー連鎖探索(Nested KV Retrieval)でも、標準モデルが3ホップ以上で正解率0%に崩壊する中、MemGPTは100%の追跡能力を発揮しました。
3. ニューラル表現層: Cartridges (2025)
MemGPTは強力ですが、テキストトークンを外部DBと頻繁にやり取りする点に制約があります。500ページの財務諸表や巨大なコードベース全体を毎回数万トークンずつ読み込めば、推論遅延とコストは許容できません。
2025年に発表されたCartridges Modular Agent Memoryは、これに対して革新的なアプローチを提示しました:
「なぜ知識をテキストトークンのまま保持するのか? モデル自身に500ページの文書をオフラインで自主学習(Self-Study)させ、わずか50〜100個の学習可能な連続KVキャッシュベクトル(Cartridge)に凝縮し、レゴブロックのように差し込んで使えばよいのではないか!」
[500ページの大規模ドキュメント / コードベース]
             │
             ▼ (Self-Study パイプライン)
1. 多様な合成対話生成 (構造要約, 深層質疑, 境界条件, 応用設計)
             │
             ▼
2. KLダイバージェンスによるコンテキスト蒸留:
   教師モデル (500ページ本文丸ごと + 質問) ──► P_Teacher(y)
                                                 │ (D_KL損失)
   生徒モデル (カートリッジZ [50個のKV] + 質問) ─► P_Student(y)
             │
             ▼
[着脱可能なCartridge Z (50〜100個の連続KVベクトル)]
(メモリ消費量38.6倍削減, スループット26.4倍向上, モジュール型結合性)
次トークン予測(NTP)が失敗した理由
研究チームが当初、文書に対して単純な次トークン予測(NTP)でKVキャッシュを訓練した際、モデルは**「丸暗記症候群」**に陥りました。本文を一言一句違わず暗誦することはできるものの、その文書に関する応用的な質問には一切答えられなかったのです。
Self-Studyとコンテキスト蒸留の仕組み
- 合成対話の自動生成: モデル自身に文書を与え、5つの原型(構造要約、深層質問、境界テスト、創造的応用など)に基づき大量のQ&Aペアを生成させます。
- コンテキスト蒸留(Context Distillation):
- 教師モデル: 500ページの全テキストをコンテキストに入力して推論。
- 生徒モデル: 本文の代わりにわずか数十個の圧縮された**カートリッジパラメータ $Z$**のみを入力。
- 生徒の出力確率分布が教師の分布と一致するように、カルバック・ライブラー(KL)ダイバージェンス損失を用いてカートリッジ $Z$の重みのみを更新します:
========================================================================================
Cartridge コンテキスト蒸留の損失関数:
========================================================================================
min_Z  Σ  D_KL( F( · | Document ⊕ x )  ||  F_Z( · | x ) )

ここで:
  • F( · | Document ⊕ x ) : 全文を入力した教師モデルの出力ロジット
  • F_Z( · | x )          : カートリッジZのみを入力した生徒モデルのロジット
  • Z                     : 各層に挿入される連続KVキャッシュテンソル
========================================================================================
ベンチマーク結果とレゴブロック型結合
- 38.6倍のメモリ削減: 長文ベンチマーク(LongHealth, QASPER)において、全文入力(ICL)と同等の精度を保ちながらメモリ消費量を38.6倍削減しました。
- 26.4倍のスループット向上: Prefill段階の長大トークン処理が消失し、推論処理能力が26.4倍に急伸しました。
- ゼロショット・モジュール結合性: AMD社の10-K報告書カートリッジとペプシコ社のカートリッジを並列に差し込むだけで、再学習なしに両社の財務比較分析を完璧に遂行しました!
4. システムインフラ層: CacheBlend (EuroSys 2025)
次に、RAGエージェントのサービングインフラにおける致命的ボトルネックに迫ります。
エージェントが検索した10個の異なる文書チャンクを1つのプロンプトにまとめて推論する際、従来のサービングシステムは深刻なジレンマを抱えていました:
- プレフィックスキャッシング (vLLM): プロンプトの先頭チャンクのみキャッシュを再利用でき、途中の順序が変わると後続のキャッシュが全て無効化され、数秒間のPrefill再計算が発生します。
- 全キャッシュの単純結合 (PromptCache): 各チャンクの事前計算KVキャッシュをそのまま結合すると、チャンク間の相互作用(クロスアテンション)が無視され、推論精度が50%以下に低下します。
EuroSys 2025で発表されたCacheBlend KV Cache Mergingは、**選択的KV再計算(Selective KV Recompute)**によってこの課題を解決しました:
[検索された文書チャンク A, B, C の事前計算KVキャッシュ]
                           │
                           ▼
┌─────────────────────────────────────────────────────────────────────────┐
│              CacheBlend レイヤー別選択的再計算パイプライン              │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. 上位15%のトークン選定: チャンク間クロスアテンション偏差大 (HKVD)     │
│ 2. 選定された15%の重要トークンのみアテンションを新規再計算               │
│ 3. 残り85%のトークンは事前計算キャッシュをそのまま結合                  │
│ 4. RoPE回転行列を乗算し新たな絶対位置オフセット座標を瞬時に補正         │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
      [超高速Prefill完了: TTFT 3.3倍短縮, 正解率低下 ΔF1 < 0.01]
アテンションのスパース性(疎性)に着目したブレイクスルー
研究チームはトランスフォーマーのアテンションマップを解析し、重要な事実を発見しました:
「複数の文書チャンクを結合した際、周囲のチャンクの影響を受けてアテンション値が大きく変化するトークンは全体の15%未満である。残り85%以上のトークンは独立した意味表現を保っている!」
- 高偏差トークンの抽出(HKVD): 各レイヤーにおいて、クロスアテンションの変動が大きい上位15%のトークンのみを特定して再計算し、85%はキャッシュをそのまま再利用します。
- I/Oレイテンシの隠蔽(Latency Hiding): GPUが15%のトークンを再計算している数ミリ秒の間に、バックグラウンドの非同期I/OスレッドがSSDから次レイヤーのキャッシュテンソルを先読みします。計算待ち時間をデータ転送時間の中に完全に隠蔽したのです。
- RoPE位置補正の数学的復元: チャンク結合によって変化した絶対位置は、Keyテンサに2Dギブンス(Givens)回転行列を乗算するだけで、わずかマイクロ秒単位で完全に整合性を回復します。
性能測定結果
- TTFT 3.3倍短縮: 複数チャンクRAG環境で、初動トークン生成時間が3,450msから1,050msへ大幅削減。
- サービングスループット5倍向上: 同一GPUクラスタ内で処理可能な同時エージェントクエリ数が5倍に拡大。
- 精度完全維持: 全トークンをゼロから再計算した場合と比較して、F1精度の誤差は0.01未満でした。
5. メモリパラダイム間の構造比較表
=============================================================================================================
比較項目              MemGPT (UC Berkeley)          Cartridges (2025)             CacheBlend (EuroSys 2025)
-------------------------------------------------------------------------------------------------------------
抽象化レイヤー        ソフトウェア制御 / OSページング ニューラル知識表現            サービングインフラシステム
基本処理単位          テキストトークン & JSON呼び出し 連続型仮想KVベクトル          事前計算済みKVキャッシュ
記憶容量限界          外部DB連携により実質無制限    文書あたり50〜100トークン     動的マルチチャンクRAG
メモリ更新方式        自律関数呼び出し & 再帰要約   Self-Study KL蒸留学習         選択的再計算 (上位15% HKVD)
主なハードウェア効果  コンテキスト溢れの解消        VRAM消費量 38.6倍削減         TTFT 3.3倍短縮
モジュール結合性      リレーショナル検索結合        レゴブロック型テンソル結合    RoPE回転座標補正結合
=============================================================================================================
6. 技術深層Q&A
Q1: MemGPTでは、モデルが「いつ外部記憶を検索すべきか」をどのように自律判断しているのですか?
MemGPTは、メインコンテキスト最上部に常駐する**システム指示(System Instructions)**と厳密なFunction Callingスキーマにより自律的判断を行います:
「あなたは長期記憶を持つ自律型知能である。過去の出来事やユーザーの詳細が作業コンテキストに存在しない場合、推測したり謝罪したりせず、必ず
recall_storage.search()を最初に呼び出さなければならない。」
モデルが欠落した情報を必要とするプロンプトを処理する際、アテンション機構がシステム指示を参照し、通常のテキスト出力よりも検索関数JSONの生成を最高確率パスとして選択します。システムがrequest_heartbeat=trueシグナルを受けて即座に検索結果をコンテキストへ差し戻すため、人間の介入なしに完全な自律想起ループが実行されます。
Q2: 異なる位置のKVキャッシュを結合してもRoPE位置埋め込みが崩れないのはなぜですか?
従来の絶対位置埋め込みでは、トークンのインデックスが変わると埋め込みベクトル全体を再計算する必要があります。
しかし現代のトランスフォーマーが採用する**RoPE (Rotary Position Embedding)は、QueryとKeyの内積がトークン間の相対距離 $(m - n)$**にのみ依存する2次元回転行列構造を持ちます:
K_new = R_Theta(p_new - p_old) * K_cached
したがってCacheBlendは、事前計算されたKeyテンサに位置差分 (p_new - p_old) 分の2D回転行列を乗算するだけで、マイクロ秒単位で完全な位置情報を復元できます。モデルの重みを変更することなく、純粋な線形代数演算のみで数学的整合性が担保されます。
まとめと次回講義の予告
エージェントの真の自律性は、永続的な記憶基盤なしには成立しません。MemGPTを通じてOSページングによる無限の作業記憶制御を学び、Cartridgesを通じて大量文書をモジュール型連続ベクトルへ凝縮する手法を確認し、CacheBlendを通じて選択的再計算による3.3倍の高速化を実証しました。
次回Lecture 12では、Part 3(エージェントエンジニアリング)の総決算として、自律システムの真の知能と経済価値を測定する評価体系を学びます:《Agent Evaluation & Long Tasks: 長期課題評価と経済的価値ベンチマーク (Measuring Long Tasks, GDPVal, DeepScholar-Bench)》。
今回の重要ポイント
- 階層型メモリ分離: 高速な作業記憶(RAM)と大容量長期ストレージ(Disk)を分離することが、コンテキスト制約を突破する鍵です。
- テキストから連続ベクトルへの蒸留: 500ページの文書を50〜100個のCartridgeに蒸留することで、メモリを38.6倍節約しながらモジュール結合を実現できます。
- アテンションの疎性を利用した超高速Prefill: 複数チャンクRAGでは上位15%の高偏差トークンのみを再計算することで、精度を損なわずTTFTを3.3倍短縮できます。