Stanford CS329A (第12回): Agent Evaluation & Long Tasks — METR時間地平線, OpenAI GDPval, DeepScholar-Bench

エンジニアリングチームが自律コーディングエージェントを開発し経営陣や投資家に報告する際、「MMLUテストで92点を獲得しました」と説明してもビジネスの実態には響きません。現場から突きつけられる問いは極めて現実的で冷徹です:
- 「この自律エージェントは、人間の介入なしに数時間に及ぶ複雑な業務を最後までやり切れますか?」
- 「人間のシニアエンジニアが8時間かけて行うリファクタリングや財務分析レポートを、このエージェントは同等品質で代替できますか? その経済的純価値は一体何ドルですか?」
従来の選択式ベンチマーク(MMLU, GSM8K, HumanEval)は軒並み90%を超えて飽和(Saturation)し、Webクローリングによるデータ汚染(Contamination)によって単なる丸暗記テストへと形骸化しました。何より、5秒で解ける4択クイズと、**数時間で数百ステップに及ぶ状態変化を伴う意思決定を継続する長距離課題(Long-Horizon Agent Tasks)**とは全くの別物です。
Stanford CS329A: Self-Improving AI AgentsのPart 3: エージェントエンジニアリング(Agent Engineering)の最終講となる今回のLecture 12では、Agent Evaluation Benchmarks — AIの知能を無意味なパーセンテージではなく、**人間の時間(Human Time)と経済価値のドル($)**という現実の物理尺度で測定する3大革新フレームワークを徹底解剖します:
- 人間の時間尺度知能 (METR, 2025): 50%成功率の時間地平線(
h_agent)と7ヶ月周期の倍加の法則。 - 実戦的経済価値評価 (OpenAI GDPval, 2025): 米国GDP 9大産業44の専門職ブラインド評価と「修正コスト(Try-n-then-fix)」の経済学。
- 汚染のないリアルタイム学術リサーチ評価 (DeepScholar-Bench, 2025): 3次元7大指標とLLMジャッジの位置バイアス相殺技術。
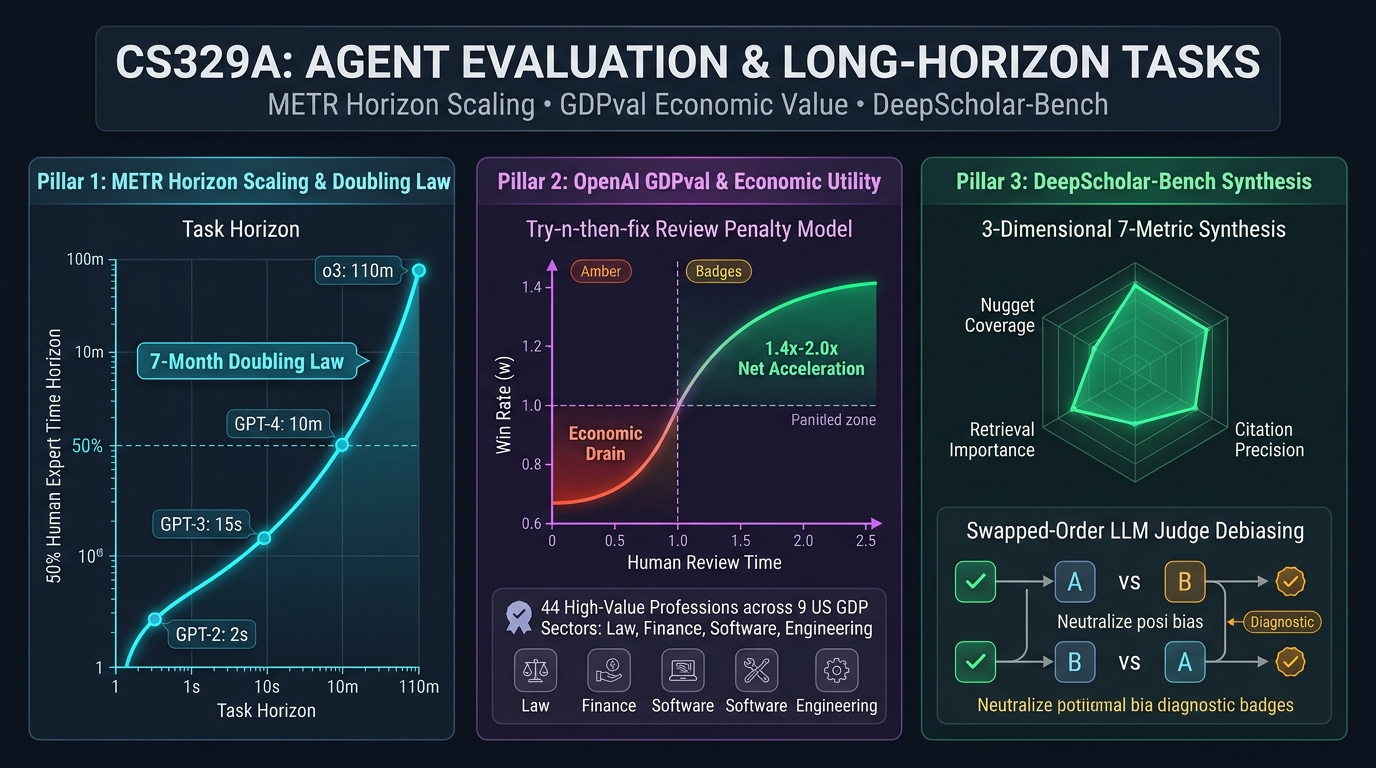
1. 評価の危機: 選択式ベンチマークの限界と実戦タスクの本質
過去5年間、AI界隈は静的な質問応答データセットに依存してきました。しかし自律エージェントの実装過程において、このアプローチの致命的な欠陥が露呈しました:
- 飽和と汚染: フロンティアモデルがMMLUで90%超を達成したものの、インターネット上に流出した問題文を事前学習で丸暗記したことによる見せかけの性能でした。
- 時間地平線の欠如: 4択問題はわずか2秒、1ステップで終わります。しかし本番環境のソフトウェア開発は、数時間にわたる100回以上の連続ツール呼び出しと内部状態の維持を要求します。
- 現実の「泥臭さ(Task Messiness)」の欠如: 試験問題は不備のない綺麗な文章で与えられます。しかし現実の業務は、曖昧な要求、リアルタイムに変化するネットワーク状態、不親切なエラーログ、やり直しの利かない破壊的コマンドなど、あらゆる不確実性に満ちています。
そのため最先端のAI研究所は選択式テストを破棄し、時間と資本を軸とした連続的な物理測定へと完全に舵を切りました。
┌─────────────────────────────────────────────────────────────────────────┐
│               現代自律エージェント評価の3大主要ピラー                   │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│     METR 時間地平線      │  │    OpenAI GDPval ($)     │  │    DeepScholar-Bench     │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • 単位: 人間の作業時間 t │  │ • 単位: 米ドル実額 ($)   │  │ • 単位: 3次元7大指標    │
│ • 50% 成功地平線 h_agent │  │ • 44の高所得デジタル職種 │  │ • 毎週arXiv論文を収集   │
│ • 7ヶ月倍加の法則        │  │ • Try-n-then-fix 経済学  │  │ • 事前データ汚染ゼロ     │
│ • タスクの泥臭さ(Messy)  │  │ • 14年目ベテランブライン │  │ • ナゲットカバレッジ39%  │
│ • 2秒(GPT-2) -> 110分(o3)│  │ • 勝率40%の損益分岐点    │  │ • 順序入替バイアス相殺   │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. 知能を時間で測定する: METR (2025)
「このモデルはベンチマークで88点です」という言葉は、エージェントがどれほど自律的に稼働できるかを何も示していません。AI評価研究機関**METR (Model Evaluation and Threat Research)**は、最も直感的で強力な指標を提示しました:
「テストのパーセンテージを捨てよ。代わりに『熟練した人間の専門家が $t$ 時間かけて行うタスク』をエージェントが何%の確率で成功できるかを測れ。そして50%の確率で完遂できる人間の所要時間(
h_agent)を、そのモデルの知能尺度と定義せよ!」
    [170の複合ソフトウェア/MLエンジニアリング課題 (数秒〜8時間難易度)]
                               │
                ┌──────────────┴──────────────┐
                ▼                             ▼
       [人間の専門家基準時間 t]       [AIエージェント実測成功率 p]
                │                             │
                └──────────────┬──────────────┘
                               ▼
        [項目応答理論 (IRT) ロジスティック回帰フィッティング]
           p = σ( (log h_agent - log t_task) × β_agent )
                               │
                               ▼
    [モデル別50%時間地平線 h_agent: GPT-2 (2秒) ──► OpenAI o3 (110分)]
時間地平線ロジスティックモデルの定式化
METRは心理測定学の項目応答理論(IRT)を応用し、モデルの成功確率 $p$ を人間の作業時間 t_task とモデルの時間地平線 h_agent の関数として定式化しました:
========================================================================================
METR 時間地平線成功確率の数式定義:
========================================================================================
p_success(agent, task) = σ( (ln(h_agent) - ln(t_task)) * β_agent )

ここで:
  • t_task  : 熟練した人間の専門家がタスクを完了するのに要する平均時間
  • h_agent : そのエージェントの50%成功時間地平線 (t_task = h_agent のとき p = 0.5)
  • β_agent : タスク難易度の上昇に伴う成功率低下の傾き
  • σ(z)    : 標準ロジスティックシグモイド関数 1 / (1 + exp(-z))
========================================================================================
7ヶ月倍加の法則 (The 7-Month Doubling Law)
2019年から2025年までにリリースされた16のフロンティアモデルを実測した結果、驚異的な指数関数的トレンドが明らかになりました:
- 2019年 (GPT-2): 時間地平線はわずか 2秒(単純な自動補完)。
- 2021年 (GPT-3): 時間地平線 15秒。
- 2023年 (GPT-4): 時間地平線 10分。
- 2025年 (OpenAI o3): 時間地平線 110分(約2時間)。
- 統計的傾向線: フロンティアAIの50%時間地平線は、正確に7ヶ月(207日)ごとに2倍へと指数関数的に急伸しています!
- 将来展望: この傾向が持続した場合、AIエージェントは2028年から2030年の間に「人間の専門家が1ヶ月(160時間)間フル稼働しなければならない大規模プロジェクト」を50%の確率で一発完遂する水準に達します。
3. 実戦的経済価値を測定する: OpenAI GDPval (2025)
METRが「時間」を測定したのに対し、OpenAIが2025年秋に発表したGDPvalは「本物の経済価値(ドル)」を測定しました。
OpenAIは米国の国内総生産(GDP)を牽引する9大産業(金融、法務、エンジニアリング、IT、医療事務など)から、高所得の44の専門職種を選定しました。そして平均14年の実務経験を持つシニア専門家を起用し、実際の現場で発生する220件の本格的ゴールドタスク(DCF財務モデル作成、特許請求分析、Pythonデータ解析など)を設計しました:
- 1タスクあたり平均人間作業時間: 9.5時間(中央値5.0時間)。
- 1タスクあたり平均市場外注費用: 398ドル(約55,000円)。
ベテラン専門家ブラインド勝率の実態
14年目のシニア専門家たちが、モデルの成果物と同僚の人間の成果物をブラインドで比較審査した結果:
- GPT-4o: 勝率 12.5%(人間の専門家の水準には遠く及ばず)。
- OpenAI o3: 勝率 35.2%。
- Claude Opus 4.1: 勝率 **47.6%(勝利または引き分け)**を達成!
- 最先端の推論モデルは、ベテランの目から見ても人間の成果物と同等以上の品質をほぼ半分の確率で叩き出しています。
単純な「速度300倍」の罠と現実の経済学
AIベンダーは「人間が9時間かかる作業をAIが2分で終わらせたから270倍高速だ!」と宣伝しがちです。しかしGDPvalは、**人間のレビュー・修正時間(Try-n-then-fix)**を考慮した冷徹な現実の経済コストモデルを定式化しました:
========================================================================================
Try-n-then-fix モデルにおける実質所要時間数式:
========================================================================================
E[T_real] = (M_T + R_T) * [ (1 - (1 - w)^n) / w ] + (1 - w)^n * H_T

ここで:
  • M_T : モデルの生成時間 (数分以内)
  • R_T : 人間の専門家がモデルの成果物を細かく監査・レビューする時間
  • H_T : 成果物が不完全なため人間がゼロから作り直す時間
  • w   : モデルのブラインド勝率 (品質合格確率)
  • n   : 人間が諦めて自分で書き直すまでにモデルに許容する試行回数
========================================================================================
経済性の損益分岐点: 赤字から黒字へ
- モデル品質 $w$ が低い場合(GPT-4o, $w=12.5%$): 人間の専門家はモデルの巧妙なハルシネーションの確認に時間を取られ、結局自分でやり直すことになります。その結果、GPT-4oを導入した際の実質作業速度は、人間が単独で行うより13%遅くなりました(0.87倍の経済的赤字)!
- 勝率が**損益分岐点の $w \ge 40%$ を突破した最新モデル(o3, Opus 4.1)**になって初めて、人間の確認コストを相殺し、実質作業速度を1.3倍〜1.4倍加速させる真の経済的黒字へと転換しました。
4. 汚染のないリアルタイム学術リサーチ評価: DeepScholar-Bench (2025)
正解が一つに定まらない学術研究レポートやディープリサーチ(Deep Research)エージェントはどのように評価すべきでしょうか?
2025年8月に発表されたDeepScholar-Benchは、毎週arXivに公開される最新論文をリアルタイムで取り込みベンチマーク問題を自動生成するライブデータパイプラインを構築し、事前のデータ汚染(Contamination)を完全に排除しました。
       [毎週最新のarXiv論文を収集 (データ汚染ゼロ保証)]
                               │
                               ▼
┌─────────────────────────────────────────────────────────────────────────┐
│               DeepScholar-Bench 3次元7大評価指標                        │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. 知識の総合力 (Knowledge Synthesis)                                   │
│    • 構造化と一貫性 (論理構成、可読性、フォーマット品質)                │
│    • ナゲットカバレッジ (必須不可欠な原子的事実の網羅率)                │
│ 2. 検索品質 (Retrieval Quality)                                         │
│    • 関連性比率 (引用論文と研究テーマの近接度)                          │
│    • 文献重要度 (その分野の記念碑的・権威ある原著論文の選定力)          │
│ 3. 検証可能性 (Verifiability)                                           │
│    • 引用精度 (本文中の主張が引用元論文に実際に記述されているか)        │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [順序入替LLMジャッジ: 位置バイアス (Position Bias) の数学的相殺]
幾何平均30.9%が突きつける現実
フロンティア自律リサーチエージェント(OpenAI DeepResearchなど)であっても、7大指標の**幾何平均スコアはわずか30.9%**にとどまりました:
- 流暢な文体と中身の乖離: エージェントは文章の構造や体裁(Organization: 85.7%)では高得点をマークしたものの、必須事実の網羅性(Nugget Coverage: 39.2%)や権威ある基幹論文の網羅(Document Importance: 12.4%)では惨敗しました。
- オラクル実験の教訓: システムに最初から正解論文リストを与えても(Oracle Retriever)、総合スコアは**49%にとどまりました。これはディープリサーチの真のボトルネックが「検索」ではなく、「膨大な文献を読み込み重要洞察を抽出する総合力(Synthesis)」**にあることを証明しています。
5. 現代エージェント評価フレームワーク比較表
=============================================================================================================
比較次元              METR (2025)                   OpenAI GDPval (2025)          DeepScholar-Bench (2025)
-------------------------------------------------------------------------------------------------------------
主要測定単位          人間の作業時間 (時間・分・秒) 実質米ドル ($ USD)            7大多次元品質ベクトル
評価対象タスク        ソフトウェア / ML開発課題     44の高専門ホワイトカラー職務  オープンエンドな学術調査
正解判定方法          決定論的テストスイート通過    14年目シニアブラインド勝率    原子的情報ナゲット照合
汚染防止策            非公開エアギャップタスク群    実企業向け非公開業務PRD       毎週最新のarXiv論文自動連携
レビューコスト考慮    未考慮 (完全自動採点)         Try-n-then-fix 修正数式モデル 順序入替 (Swapped) 偏向除去
現在のフロンティア頂点o3: 110分の時間地平線 (50%)   Opus 4.1: 47.6% ブラインド勝率DeepResearch: 30.9% 幾何平均
=============================================================================================================
6. 技術深層Q&A
Q1: METRの「タスクの泥臭さ(Task Messiness)」とは具体的に何を指し、性能にどう影響しますか?
METRが定義した**タスクの泥臭さ(Task Messiness)**は、現実世界の業務における16の摩擦要因を定量化した指標です:
- 動的環境: エージェントが実行している最中にネットワーク遅延やDBロックが発生するなど、システム状態が刻々と変化する。
- 不可逆的な失敗: 誤ったSQL
DROP TABLEや git push のように、単純なロールバックが不可能な破壊的リスク。 - 能動的情報探索: 入力データが手渡されず、エージェント自らログをgrepして文脈を推測しなければならない。
METRの分析によると、タスクの泥臭さスコアが1点上昇するごとに、エージェントの成功率は約8.1%ずつ低下しました。将来のエージェント研究における真の勝負どころは、小奇麗なコーディングではなく、この「泥臭い現実」に耐えうる頑健性にあります。
Q2: LLMジャッジの位置バイアス(Position Bias)を相殺する「順序入替(Swapped-Order)」の仕組みは?
LLMジャッジに2つの成果物 (A) と (B) を提示して比較させると、内容の優劣にかかわらずプロンプトの前方に置かれた (A) を60〜70%の確率で偏愛する位置バイアスが生じます。
これを数理的に打ち消すため、DeepScholar-Benchは**順序入替平均(Swapped-Order Averaging)**を適用します:
- 1回目の評価:
[A, B]の順で提示し、スコアベクトル $S_1 = [s(A), s(B)]$ を取得。 - 2回目の評価:
[B, A]と完全に順序を逆転させて提示し、スコアベクトル $S_2 = [s(B), s(A)]$ を取得。 - 最終スコア:
S_final(A) = ( S1(A) + S2(A) ) / 2
S_final(B) = ( S1(B) + S2(B) ) / 2
同一の温度(Temperature)条件下で2つの順列の算術平均を取ることで、前方に配置されたことによるバイアスを完全に代数的に相殺します。
Part 3(エージェントエンジニアリング)完結とPart 4予告
本日をもって、私たちはStanford CS329Aの第3の山場である**Part 3 · Agent Engineering (L10〜L12)**を完遂しました!
- Lecture 10: 本物のGitHubバグを修復するSWE-Agentsとプロファイラ主導のKernelBench GPUカーネル最適化
- Lecture 11: 永続的な長短期記憶を授けるMemGPT、Cartridges、CacheBlend
- Lecture 12: 人間の時間(METR)と経済価値(GDPval)でエージェントを厳密に測定する評価学
私たちは今、自律エージェントを設計し、学習させ、階層メモリで武装し、冷徹な現実尺度で検証する全エンジニアリング基盤を手にしました。
Part 4 · Frontiers(フロンティア)へ向けて
次回からは、人工知能が到達しうる最高峰の知的分野である**Part 4 · Frontiers (Lectures 13 through 17)**へと突入します!
その記念すべき幕開けとなるLecture 13のテーマは**《LLM Reasoning: 言語モデル推論の本質と思考の連鎖 (Chain-of-Thought, Self-Consistency, Emergent Cognitive Scaling)》**です。Google DeepMindの碩学デニー・チョウ(Denny Zhou)博士の研究を基礎に、大規模モデルの中で「推論」という神秘的な火花がどのように灯るのか、そのメカニズムを解剖します。
今回の重要ポイント
- 点数ではなく時間を測れ: 真のエージェント知能は50%成功時間地平線(
h_agent)であり、GPT-2の2秒からo3の110分まで7ヶ月ごとに2倍成長しています。 - 修正コストが経済性を左右する: エージェントの勝率が約40%を超えない限り、人間のレビューと手戻りコストによって業務効率はむしろ悪化します。
- 真の壁は検索ではなく総合力: オープンエンドなリサーチにおいて文献検索の課題は小さく、膨大な文献から重要事実を抽出し統合する総合力こそが真の未踏峰です。