Stanford CS329A (Ep 14): AlphaProof & Mathematical Reasoning — 形式検証、Lean 4、AlphaGeometry、Gemini Deep Think

前回の講義では、思考の連鎖(Chain-of-Thought, CoT)プロンプティングと自己無矛盾性(Self-Consistency)デコーディングが、ニューラルネットワーク内部で多段階の因果的推論をいかに点火したかを学びました。しかし、暗号プロトコルの検証、宇宙機の軌道制御ソフトウェア、国際数学オリンピック(IMO)の証明のような極限のミッションクリティカル領域において、自然言語テキストには根本的な脆弱性が存在します:
"言語モデルが生成する自然言語のCoTがいかに流暢に見えようとも、それは確率的なトークン列に過ぎない。微小な符号の反転、循環論法、幻覚(ハルシネーション)に基づく補題が1つ混入するだけで、システム全体が破綻する。厳密な数学の世界において、99%正しい証明は0%正しい証明と等価である。"
Stanford CS329A: Self-Improving AI AgentsのPart 4: フロンティア(Frontiers in Reasoning & Autonomy)第2講となるLecture 14へようこそ。Google DeepMindの研究ディレクターでありAlphaProofの開発を牽引したタン・ルオン(Thang Luong)博士の研究を基盤に、AIが確率的な次トークン予測を超え、100%機械的に検証可能な無欠陥の数学的知能へと到達し、IMOメダルを獲得した歴史的ブレイクスルーを徹底解剖します:
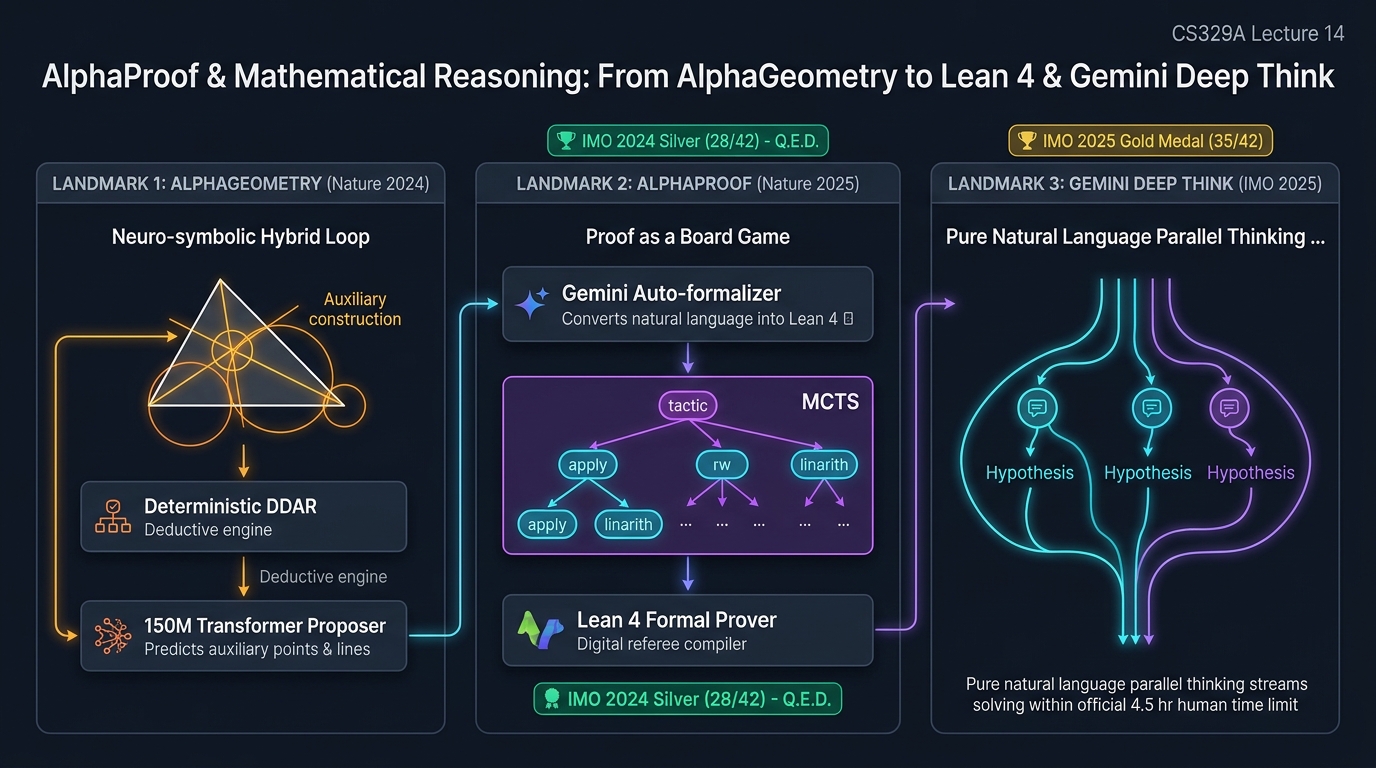
- AlphaGeometry (Nature 2024): 決定論的記号演繹エンジンと生成トランスフォーマーによる補助線生成を融合したニューロシンボリック(Neuro-Symbolic)構造。
- AlphaProof (DeepMind, Nature 2025): 対話型定理証明器Lean 4、自動形式化(Auto-formalization)、テスト時強化学習(TTRL)によって証明をAlphaZeroの盤上ゲームへと再定義したシステム。
- Gemini Deep Think (IMO 2025): 純粋な自然言語推論と並行思考(Parallel Thinking)により、人間の公式制限時間4.5時間内で世界初の公式IMO金メダル(35/42点)を獲得した新世代パラダイム。
- LLM形式検証と数学的推論: コンパイラ検証に基づく厳密な形式カーネルと、自由度の高い自然言語強化学習の比較。
1. 数学:人工知能の知能を測る究極のリトマス試験紙
なぜ数学は、自律型AIエージェントの推論能力を測定する「究極のリトマス試験紙(Litmus Test)」と位置づけられるのでしょうか? コーディングベンチマーク(SWE-bench)や対話型タスクは部分点やヒューリスティックな回避策を許容しますが、形式数学は一切の妥協を排した3つの構造的制約を課します:
┌──────────────────────────────────────────────────────────────────────────┐
│              数学がAI推論の究極のリトマス試験紙である3大理由             │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│  客観的・機械的検証性   │  │   極度の報酬スパース性  │  │   膨大な組合せ探索空間  │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • 形式論理システム      │  │ • 数百手におよぶ推論で  │  │ • 補題空間の分岐係数が  │
│   (Lean 4, Coq, Isabelle)│   終端まで報酬は完全ゼロ  │    実質的に無限 (b -> inf)│
│ • 決定論的型検査コンパイラ│• 最終目標 (Goal Solved) │  │ • 幾何補助線・補助点の   │
│ • ハルシネーション確率0%│   達成時のみ正の報酬付与│    発見には真の創造性が必要│
│ • 真/偽の厳格な二値判定 │  │ • 信用割当の極限難度    │  │ • 単純な総当たり探索不能│
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
- 客観的・機械的検証性(Objective Mechanical Verifiability): 主観的な評価が伴う文章作成や法務分析と異なり、形式数学はLean 4のような決定論的型検査コンパイラによって100%機械的に無欠陥判定が可能です。
- 極度の報酬スパース性(Extreme Reward Sparsity): 数十〜数百ステップにおよぶ証明探索において、エージェントは最終ゴール(
Goal Solved)を閉じるまで一切の正の報酬を得られません。99%完了していても最後の1行で破綻すれば報酬は0です。 - 膨大な組合せ探索空間(Massive Combinatorial Search Space): チェス(平均分岐係数約35)や囲碁(約250)と異なり、数学的定義や補題の選択肢は無限($b \to \infty$)に広がっています。
2. ニューロシンボリック融合:AlphaGeometry (Trinh et al., Nature 2024)
国際数学オリンピックにおけるユークリッド幾何学の問題は、人間の秀才たちをも苦しめる難関です。教科書の公理をいくら暗記していても、図形の中に巧妙な補助線(Auxiliary Construction) — 例えば目立たない3点を通る外接円を描いたり、特定の垂線を下ろす操作 — を閃かなければ、4時間考え続けても1行も進めません。
従来のAI研究は2つの陣営に分断されていました:
- 記号論理エンジン(DDAR): 演繹データベースと代数推論器から構成され、100%正確な論理を展開しますが、創造性が皆無なため公理の適用が尽きると停止します。
- 深層ニューラルネットワーク(Transformers): 直感的な閃きに富むものの、微細な座標誤差や角度の錯覚により証明全体を破綻させるハルシネーションを抱えます。
AlphaGeometryは、この2つのパラダイムを非対称な共生関係として結合しました:
               +-------------------------------------------+
               |            ユークリッド幾何問題の入力     |
               +---------------------+---------------------+
                                     |
                                     v
                        +----------------------------+
                        |   記号論理エンジン (DDAR)  | <---------+
                        |   - 演繹データベース (DD)  │           │
                        |   - 代数推論器 (AR)        │           │
                        +--------------+-------------+           │
                                       |                         │
                         [証明目標は達成されたか?]              │
                           /                   \                 │
                        (成功)                 (未達 / 停止)     │
                         /                       \               │
                        v                         v              │
             +--------------------+    +-----------------------+ │
             | 最終証明の出力     |    | 150M Transformer      | │
             | (人間可読テキスト) |    | 補助図形提案ネットワーク│ │
             +--------------------+    +-----------+-----------+ │
                                                   |             |
                                       [創造的な補助点・補助線 │
                                        候補を予測して注入]    │
                                                   +-------------+
1億件の合成データ生成(Synthetic Data Generation)
AlphaGeometry最大の壁は学習データの不足でした。人類のオリンピック史上、形式化された幾何証明は1,000件にも満たなかったのです。DeepMindは逆転の発想でデータ合成パイプラインを構築しました:
- ランダム幾何グラフの生成: 10億個のランダムな点、線分、円の配置をコンピュータで無作為に生成。
- 前方演繹トラッキング: 記号エンジン(DDAR)が、それらのランダム図形の中から偶然成立する1億件の幾何学定理と証明パスを網羅的に発掘。
- 補助線依存性の抽出: 1億件の定理のうち、特定の補助線を補うことで初めて証明可能となった「必須補助線証明」900万件を特定。
- 教師あり蒸留: 150Mパラメータのトランスフォーマーに対し、記号エンジンが手詰まりになった際にまさにその必須補助線を提案する直感を集中学習させました。
ベンチマーク実績
歴代IMO幾何問題30問のテストセットにおいて:
- 従来の最高峰記号手法(Wu's method)は10問の解決に留まりました。
- AlphaGeometryは公式制限時間内に30問中25問を完全証明し、人間のIMO金メダリスト水準に到達しました。
- 2004年IMO第1問では、出題委員会すら気づいていなかった冗長な前提条件を発見し、定理をより一般的な形へと拡張する快挙を成し遂げました。
3. 証明を盤上ゲームに変える:AlphaProof (Nature 2025)
幾何学は数学の一領域に過ぎません。数論、代数学、組合せ論といった広大な数学領域を攻略するためには、機械検証可能な形式言語による多段階の論理展開が不可欠です。
2024年7月、タン・ルオン博士率いるチームは、定理証明を厳格なコンパイラと戦う盤上ゲームへと変換したAlphaProofを発表しました。
┌──────────────────────────────────────────────────────────────────────────┐
│                   AlphaProof システムアーキテクチャ                      │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Gemini 自動形式化器      │                   │ AlphaZero 証明探索ネットワーク│
├──────────────────────────┤                   ├───────────────────────────┤
│ • 自然言語の数学問題入力 │                   │ • 3B パラメータTransformer│
│ • 1億件の生データ        │                   │ • Lean 4 タクティク方策:  │
│ • 双方向翻訳検証         │                   │   apply, rw, linarith     │
│ • Lean 4形式仕様コード   │                   │ • 価値ネットワーク:       │
│ • 8,000万件の有効な定理  │                   │   終端Q.E.D.までの距離    │
└────────────┬─────────────┘                   └─────────────┬─────────────┘
             │                                               │
             └───────────────────────┬───────────────────────┘
                                     ▼
                      ┌─────────────────────────────┐
                      │    Lean 4 形式カーネル環境  │
                      ├─────────────────────────────┤
                      │ • 厳格な型検査コンパイラ    │
                      │ • 環境フィードバックループ  │
                      │ • 二値判定 (0 または 1):    │
                      │   - タクティクコンパイル成功│
                      │   - 型の居住 (Inhabitation) │
                      └─────────────────────────────┘
Lean 4環境:数学の無限の碁盤
Lean 4は、帰納的構成の計算(CIC)に基づく純粋関数型言語です。カリー=ハワード同型対応(Curry-Howard Correspondence)により:
- **数学的命題(Proposition)は型(Type)**に対応します。
- **数学的証明(Proof)はその型を居住させる項(Term, プログラム)**に対応します。
- Leanコンパイラは無謬の審判となり、証明コードがコンパイルを通過すれば、その定理は100%機械的に真であると証明されます。
エージェントは各ステップで現在のGoalを観測し、induction, ring, rw [mul_comm], linarithなどの形式タクティク(Tactic)を一手ずつ選択して進めます。
自動形式化(Auto-Formalization):8,000万件の定理データセット
Lean 4コードを自在に記述できる数学者は世界に1,000人未満しかいません。DeepMindはGeminiを用いて数千冊の教科書や問題集をLean 4形式に翻訳し、意味論的逆翻訳フィルタを通して8,000万件の形式数学定理ライブラリを構築しました。
テスト時強化学習(TTRL, Test-Time Reinforcement Learning)
IMO 2024最難関の第6問(世界609人のエリート選手中5人しか解けなかった極限の組合せ論問題)に直面した際、AlphaProofの通常モデルは探索に行き詰まりました。DeepMindはテスト時に知能を適応させるTTRLを発動しました:
[IMO 第6問の入力]
         │
         ▼
[Gemini 自動問題合成器]
         │
         ├──> 問題の核心構造を維持した400,000件の類似バリエーション問題を即座に合成
         │    (縮小パラメータ、境界条件、部分補題問題)
         ▼
[数千基のTPU v5eクラスタ投入]
         │
         ├──> 3日間にわたり40万問を解きながらAlphaZero自己対戦を実行
         ├──> 推論時にモデルのシナプス重みを動的・特化的に更新
         ▼
[第6問専用の超知能特化モデルが覚醒]
         │
         ▼
[第6問に対する100%機械検証済みLean 4完全証明を出力!]
AlphaProofは全6問中4問を完全証明し、**28点/42点で公式IMO銀メダル(Silver Medal)**を獲得しました(金メダル基準である29点にわずか1点差)。
4. 純粋な自然言語推論による金メダル制覇:Gemini Deep Think (IMO 2025)
AlphaProofの歴史的快挙の一方で、2つの現実的課題が残されていました:
- 自然言語問題をLean 4コードへ翻訳・形式化する前処理パイプラインの負荷。
- TTRLの実行に3日間の膨大な計算リソースを要し、人間の競技規則である**「1日4.5時間の制限時間」**を超過していたこと。
2025年7月、DeepMindは形式言語への翻訳を一切介さず、純粋な自然言語のみで金メダルを獲得したGemini Deep Thinkを発表しました:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Gemini Deep Think: 並行思考メカニズム                  │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ 仮説パス A (代数置換)   │  │ 仮説パス B (幾何反転)   │  │ 仮説パス C (組合せ不等式)│
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • 4ステップ展開中       │  │ • ステップ3の補題で頓挫 │  │ • 漸近的上限の導出完了 │
│ • 矛盾の自己検証を進行  │  │ • この分岐を即座に枝刈り│  │ • 仮説Aの前提へ統合     │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
Gemini Deep Thinkは単一のトークン列を逐次生成するのではなく、**並行思考(Parallel Thinking)**を展開します:
- 数十本におよぶ異なる代数的・幾何学的仮説を同時に思考空間上で追跡します。
- 一つのパスが行き止まりに達しても全体が崩壊せず、部分的な不変量を抽出して他の有効な並行ブランチへと統合します。
- 人間と同一の4.5時間制限時間内で解答を完成させ、6問中5問を完全解決し、**35点/42点で世界初の「公式IMO金メダル(Gold Medal)」**を獲得しました。
5. アーキテクチャ比較:形式検証 vs 自然言語強化学習
+-----------------------+----------------------------------+----------------------------------+
| 比較軸                | 形式検証路線 (AlphaProof, Lean 4) | 自然言語RL路線 (Deep Think)      |
+-----------------------+----------------------------------+----------------------------------+
| 検証エンジン          | Lean 4 コンパイラ型検査器        | マルチエージェントLLM自己批判    |
| ハルシネーションリスク| 完全に0% (コンパイル成功で保証)  | > 0% (微小な論理飛躍のリスク残存)|
| 探索所要時間          | 数時間〜3日間 (MCTS + TTRL)      | 4.5時間以内 (実時間推論)         |
| 適用ドメイン          | 暗号、スマートコントラクト、数学 | オープンドメイン科学研究、戦略   |
| 基盤インフラ          | Lean 4エコシステム・Mathlib      | 大規模分散強化学習インフラ       |
+-----------------------+----------------------------------+----------------------------------+
6. エンジニアリングの要点と今後の展望
- 合成データがフロンティア推論を切り拓く: AlphaGeometryは、現実のデータが極度に不足していても、決定論的記号エンジンで数億件の証明を合成することでニューラル知能をブートストラップできることを示しました。
- 形式検証はハルシネーションを根絶する: 1つの誤りも許されない極限領域では、エージェントをLean 4のような決定論的コンパイラ環境と緊密に結合させる必要があります。
- テスト時計算量(TTRL)の無限の可能性: AlphaProofは、推論時に数十万件の類似課題を合成し重みを動的に更新するTTRLが、モデルの静的能力を超える切り札であることを証明しました。
- 自然言語の並行思考の到達点: Gemini Deep Thinkは、並行仮説探索によって人間と同じ時間枠の中で金メダル水準の柔軟な知能を実現できることを実証しました。
次回のLecture 15: Autonomous Systems & Reliabilityでは、数学の閉じた世界から現実の複雑なソフトウェア環境へと移行し、自律型エージェントがいかに自己修復(Self-Healing)、サンドボックス防御、安全ガードレールを維持するかを徹底解明します。次回もご期待ください!