Stanford CS329A (Ep 16): Multimodal & Embodied Agents — 物理世界を操作するロボティクス基盤モデル (VLA, RT-2, OpenVLA, π₀)

前回の講義では、隔離された仮想サンドボックス内において、多重境界防護ハーネスとAI Controlプロトコルを用いて自律エージェントの安全性を維持する機構を学びました。しかし、人工知能コミュニティには根本的な問いが残されています:
"コンピュータの画面内でテキストを生成しコードを実行するだけで、真の『汎用人工知能(AGI)』と呼べるだろうか? 我々が暮らす物理現実は仮想端末ではなく、重力、摩擦力、3次元幾何学、そして硬質・柔軟な無数の実体物によって満ちている。"
もし基盤モデルに2つの高解像度カメラの「眼」と、鋼鉄製の7自由度関節アーム(ロボットマニピュレータ)という「身体」を授けたら何が起きるでしょうか?
- 生卵を殻を割ることなく把持してフライパンへ静かに載せる、
- 散らかったリビングの床から子どものおもちゃを色別に識別して専用トレイに分類する、
- 工場の製造ラインにおいて、微細な電子コネクタを0.1ミリメートルの精度で正確に嵌合させる!
Stanford CS329A: Self-Improving AI AgentsのPart 4: フロンティア(Frontiers in Reasoning & Autonomy)第4講となるLecture 16へようこそ。Google DeepMind Robotics出身でありPhysical Intelligenceの創業研究員であるダニー・ドリース(Danny Driess)博士の先駆的研究を基盤に、視覚言語モデル(VLM)がロボットアームの物理モーター神経回路へと直接進化した**視覚・言語・行動モデル(VLA, Vision-Language-Action)**の革命的アーキテクチャを解剖します:
- 行動もまた言語の一種である(RT-2, DeepMind 2023): 7自由度の連続運動信号を256個の離散トークンへと量子化し、55Bの超巨大VLM語彙集へと統合した発想の転換。
- オープンソースと軽量化の勝利(OpenVLA, 2024): SigLIPとDINOv2による二重視覚融合、分位数ビニング(Quantile Binning)、LoRA適応を通じ、単一の民生用ゲーミングGPU上で55Bモデルを凌駕した7Bモデルの革新。
- 連続制御と物理世界フィードバック($\pi_0$): 離散トークン特有の微小な振動を克服し、洗濯物たたみや段ボール組み立てなど柔軟物体の変形操作を制覇したフローマッチング(Flow Matching)拡散ポリシー。
- 身体性AIの2重安全防護機構: ソフトウェアレベルの閾値クリッピングと、ハードウェアレベルの力トルクセンサー反射神経ループ。
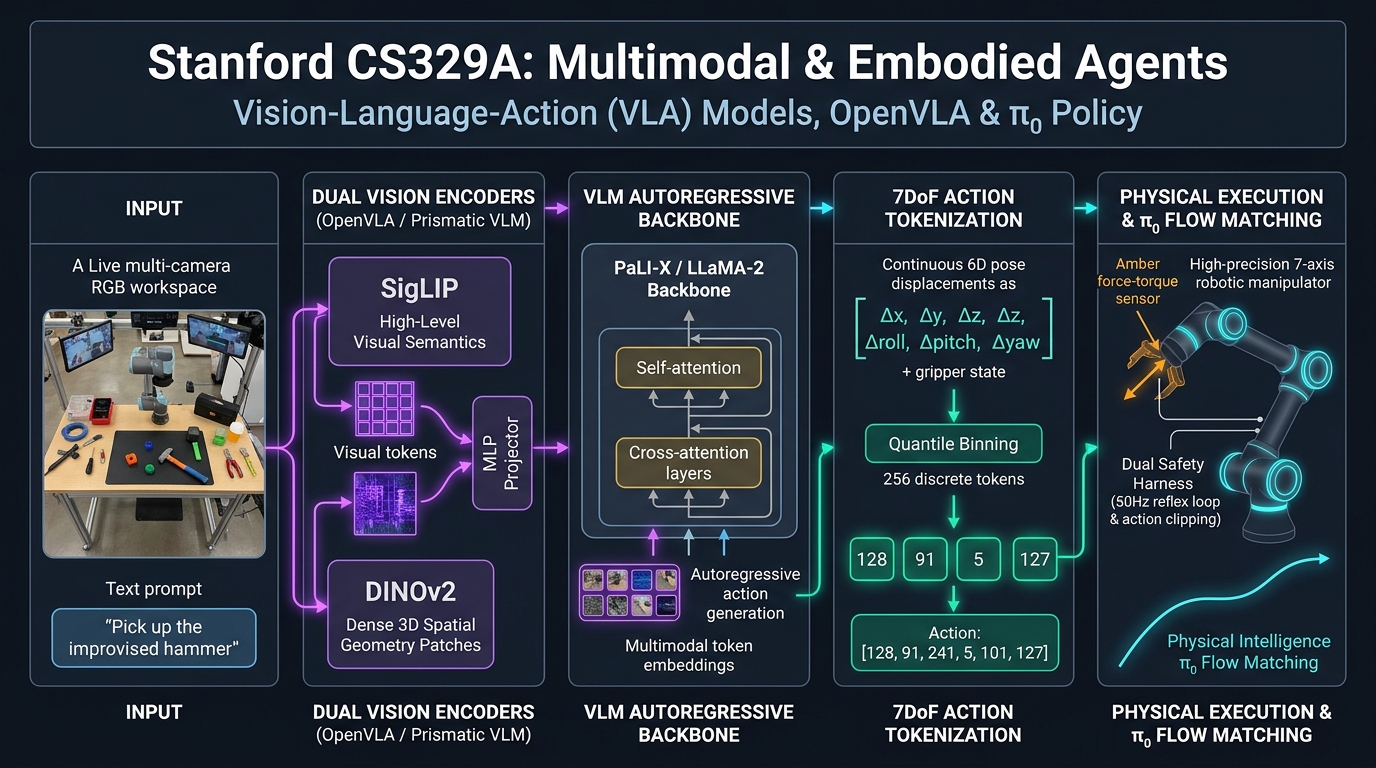
1. 物理世界のフロンティア:ロボティクスにおける「データ飢餓」の打破
数十年間にわたり、ロボット研究は深刻なデータ飢餓に悩まされてきました。自然言語モデルがインターネット上の数兆トークンを吸収して爆発的に進化を遂げた一方、物理空間におけるロボット操作データの収集は極めて過酷でした:
- 物理施設内で実機ロボットを専門オペレータが操縦して収集する必要がある。
- Google研究所が13台のアームを17か月間フル稼働させて集めた軌跡データは、わずか13万件程度に過ぎなかった。
- その結果、閉ざされた実験室データのみで学習した従来のロボットは、部屋の照度が10%変化したり物体の位置が5cmずれただけで、虚空を掴んで失敗した。
ダニー・ドリース博士らDeepMindの研究チームは、ウェブ規模の膨大なマルチモーダル知識をロボット制御へ直結させる画期的なパラダイムシフトを提唱しました:
"狭小なロボットデータのみを用いてゼロから制御ポリシー(Policy)を学習させるな。ウェブ上の数十億の画像とテキストを学習した巨大VLMをそのまま活用し、関節モーターの駆動値を『新たな外国語の単語』として語彙集へ組み込め!"
┌──────────────────────────────────────────────────────────────────────────┐
│              視覚・言語・行動(VLA)モデルへのパラダイム転換             │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────────────┐   ┌──────────────────────────────────┐
│ 従来のロボット制御ポリシー       │   │ VLA (Vision-Language-Action)     │
├──────────────────────────────────┤   ├──────────────────────────────────┤
│ • 実験室データのみで訓練された   │   │ • 7B〜55Bの超巨大マルチモーダル  │
│   小規模CNN/ResNet               │   │ • ウェブ全域の画像知識を事前獲得 │
│ • 意味的汎化能力が実質0%         │   │ • 豊かな常識的物理推論を内蔵:    │
│ • 対象が5cm移動しただけで失敗    │     「石は即席の金槌として使える」   │
│ • タスクごとに個別コード作成     │   │ • 未知の物体や散乱した実環境へ   │
│ • 閉じたタスクサイロ構造         │     ゼロショットで適応可能       │
└──────────────────────────────────┘   └──────────────────────────────────┘
2. 行動を単語に変える:RT-2 (Brohan et al., DeepMind 2023)
2023年7月、Google DeepMindは超巨大マルチモーダル基盤モデル(PaLI-X 55B, PaLM-E 12B)をロボットのエンドツーエンド制御器へと昇華させた**Robotic Transformer 2 (RT-2)**を発表しました。
[入力: RGBカメラ映像] + [指示文:「サッカーボールをメッシ(Lionel Messi)の写真の横へ動かせ」]
                                     │
                                     ▼
     ┌───────────────────────────────────────────────────────────────┐
     │             超巨大VLAバックボーン (PaLI-X 55B)                │
     │  • ウェブ常識知識: リオネル・メッシの顔写真を視覚的に同定     │
     │  • 3次元空間理解: ボールと写真の相対空間座標を計算           │
     └───────────────────────────────┬───────────────────────────────┘
                                     │
                                     ▼ (自己回帰的な次トークン生成)
                   "Action: 1 128 91 241 5 101 127"
                     │       │  │   │   │  │   │   └─ グリッパー把持 (127)
                     │       │  │   │   └──┴───┴───── 3次元回転変化量 (Δroll, Δpitch, Δyaw)
                     │       └──┴───┴──────────────── 3次元位置変位量 (Δx, Δy, Δz)
                     └─────────────────────────────── エピソード継続フラグ
7自由度(7DoF)行動空間と256ビン一様離散化
多関節ロボットアームは、7自由度の連続空間上で運動を記述します:
- 3次元並進変位($\Delta x, \Delta y, \Delta z$): エンドエフェクタの手先位置移動。
- 3次元回転変位($\Delta roll, \Delta pitch, \Delta yaw$): 手首の姿勢変化。
- グリッパー開閉($gripper$): 物体を把持・解放する動作状態。
浮動小数点実数ベクトルをトランスフォーマーの語彙集へ写像するため、RT-2は**一様行動離散化(Uniform Action Discretization)**を採用しました:
- 各運動軸の可動範囲
[a_min, a_max](例:[-30cm, +30cm])を256個の均等な区間(Bin)へと分割します。
\text{bin\_index} = \left\lfloor 256 \times \frac{a - a_{\min}}{a_{\max} - a_{\min}} \right\rfloor, \quad [0, 255] \text{ へクランプ}
- 通常の自然言語生成では滅多に使用されない特殊トークン256個を行動トークンとして再割り当てします。
- 生成時に**出力制約マスク(Output Constraint Mask)**を適用し、ロボット制御モードではこれら256個の合法的行動トークンのみをサンプリングするよう強制します。
常識知識の物理的転移
ウェブ事前学習知識を保持するRT-2は驚嘆すべき知能を示しました:
- 訓練データに「金槌を取れ」という指示が一切存在しなかったにもかかわらず、ロボットの前に石と釘を置き「即席のハンマーとして使える物を拾え」と命じると、躊躇なく石を拾い上げました。
- 「一番疲れていそうな動物のぬいぐるみを指差せ」「空のコーラ缶をゴミ箱へ捨てろ」といった高度な文脈理解を要する作業を達成し、従来の最高峰ロボットモデル(RT-1)と比較して汎化成功率を3倍以上へと押し上げました。
共同微調整(Co-Fine-Tuning):破滅的忘却の防止
数十億のパラメータを持つ巨大VLMにロボット制御データのみを学習させると、過去に学んだ常識的言語知識が失われる**破滅的忘却(Catastrophic Forgetting)が発生します。RT-2は学習バッチに元のウェブ画像・テキストデータを一定比率で混在させる共同微調整(Co-Fine-Tuning)**によりこの問題を克服しました。
3. オープンソースと軽量化の民主化:OpenVLA (2024)
RT-2は偉大な成果でしたが、55Bの巨躯ゆえにGoogleのクラウドTPU環境でのみ動作し、研究コミュニティには非公開のブラックボックスでした。
2024年夏、スタンフォード大学とUCバークレーの研究陣は、大規模ロボットデータセット(Open X-Embodiment、97万軌跡)をベースに開発された世界初の7B級オープンソース汎用VLAモデルであるOpenVLAを公開しました。
               +-------------------------------------------+
               |             RGBカメラ画像入力             |
               +---------------------+---------------------+
                                     |
                       +-------------+-------------+
                       |                           |
                       v                           v
             +--------------------+     +--------------------+
             |   SigLIPエンコーダ |     |  DINOv2エンコーダ  |
             | (高水準の視覚意味) |     | (低水準の3次元空間 |
             |                    |     |  幾何パッチ情報)   |
             +---------+----------+     +----------+---------+
                       |                           |
                       +-------------+-------------+
                                     | (チャンネル軸結合 / Concatenation)
                                     v
                        +----------------------------+
                        |      2層MLPプロジェクタ    |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |   Llama-2 7B 言語基盤      |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |  256個の分位数行動トークン |
                        +----------------------------+
1. 二重視覚融合:SigLIP + DINOv2 (Prismatic VLM)
ロボットマニピュレーションは一般的な画像キャプション生成とは異なります。「コップが存在する」という概念だけでなく、**「コップの取っ手が右側に正確に何ミリメートル突出しているか」**というミリ単位の幾何構造が不可欠です:
- SigLIP(意味エンコーダ): 言語と視覚の高次概念マッピングに優れる。
- DINOv2(空間幾何エンコーダ): 高周波な深度情報とエッジ境界の抽出に優れる。
- 双方の特徴量を結合することで、ロボットの把持精度を単一エンコーダ比で20%以上向上させました。
2. 分位数ビニング(Quantile Binning)
RT-2の一様等分方式には欠点がありました。実世界のロボット軌跡の90%以上は「1ミリ単位の繊細な位置決め」であり、高速に腕を振る大動作は1%未満です。
- OpenVLAは実測された97万件の行動データの累積分布に基づき、分位数(Quantile)に従ってビンを適応的に分割しました:
\text{ビン境界値: } q_k = \text{Quantile}\left(\mathcal{D}_{\text{actions}}, \frac{k}{256}\right), \quad k \in [0, 256]
- 最も頻出する繊細な動作領域にトークン分解能を集中させ、把持ミスを劇的に削減しました。
3. LoRA 1.4%微調整と単一RTX 4090駆動
- 視覚部を固定し、Llama-2バックボーンのわずか1.4%の重みのみをLoRA微調整することで、新しいロボット環境へ15時間以内に適応可能です。
- 4ビット量子化(NF4)によりモデルを7GBのVRAMへ圧縮し、市販のゲーミングGPU(NVIDIA RTX 4090)1枚で6Hzのリアルタイムロボット制御を実現しました。
- その結果、OpenVLAは55BのRT-2-Xよりも7倍軽量でありながら、29の実機ロボットタスクにおいて平均成功率が16.5%上回る圧倒的な性能を記録しました。
4. 連続制御の新地平:Physical Intelligence $\pi_0$ (2024)
RT-2やOpenVLAの成功の一方で、離散トークン方式には物理的な限界が存在します:
- 256分割の量子化誤差が、50Hz以上の高周波リアルタイム制御においてモーターの微小な振動(Jittering)を誘発する。
- 洗濯物をたたむ、段ボール箱を組み立てる、柔軟なケーブルを配線するといった変形物体の操作には、滑らかな多次元連続制御が不可欠となる。
ダニー・ドリース博士が参画するPhysical Intelligenceチームは、最新モデル**$\pi_0$ (pi-zero)においてフローマッチング(Flow Matching)拡散ポリシー**を導入しました:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Physical Intelligence π₀ アーキテクチャ                │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ 高水準VLMプランナー      │                   │ 連続拡散フローマッチング  │
├──────────────────────────┤                   │ ポリシー                  │
│ • 視覚シーンの意味理解   │                   ├───────────────────────────┤
│ • 長期目標の立案         │ ── 潜在目標ベクトル ─► • 50Hz超高速リアルタイム推論│
│ • 多段階サブタスク追跡   │                   │ • 連続ベクトル場の逆拡散  │
└──────────────────────────┘                   │ • モーター振動(Jitter)ゼロ│
                                               └─────────────┬─────────────┘
                                                             │
                                                             ▼
                                               [滑らかな多次元連続軌跡]
                                               (洗濯物たたみ・箱組みを制覇)
$\pi_0$は高水準VLMが目標を指示すると、制御末端において画像生成AIのように滑らかな連続軌跡をノイズ除去プロセスを通じてリアルタイム生成し、人間並みに滑らかな柔軟物体の把持・変形操作を世界で初めて単一ポリシーで実現しました。
5. ロボティクス基盤モデルのアーキテクチャ比較
+-----------------------+----------------------------------+----------------------------------+
| 比較項目              | RT-2 (Google DeepMind)           | OpenVLA (Stanford / Berkeley)    |
+-----------------------+----------------------------------+----------------------------------+
| モデル規模            | 55B (PaLI-X) / 12B (PaLM-E)      | 7B (Llama-2 バックボーン)        |
| 視覚エンコーダ        | 単一ViT                          | 二重融合 (SigLIP + DINOv2)       |
| 行動離散化手法        | 256分割 一様ビニング             | 256分割 分位数ビニング (Quantile)|
| ハードウェア要件      | クラウドTPUクラスタ              | 単一ゲーミングGPU (RTX 4090)     |
| パラメータ効率        | 全結合ファインチューニング       | 1.4% LoRA + 4ビット量子化        |
| オープン性            | 非公開・商用プロプライエタリ     | 100% 重み・コード完全オープン    |
+-----------------------+----------------------------------+----------------------------------+
6. 身体性AIの安全機構:2重反射神経アーキテクチャ
物理的なロボットアームは、誤作動時に器物を破損したり人間に危害を及ぼす危険性があります。実務環境では2重の安全防護機構が必須となります:
[VLAモデルの行動出力: 7自由度モーター指令]
                 │
                 ▼
[第1層: ソフトウェア速度および作業空間クリッピング]
  ├── 最大速度制限: 1ステップあたり ||Δpos|| <= 5cm
  └── 3次元仮想安全フェンス(Bounding Box)の厳守
                 │
                 ▼
[第2層: ハードウェア力トルクセンサー反射ループ (1000 Hz)]
  ├── 外部接触抵抗力 F_contact > 20N を検知した場合:
  └── VLA命令を即時オーバーライド -> 非常停止 / 柔軟追従モードへ強制移行
- ソフトウェア行動クリッピング: VLAが出力した変位量が安全基準を超えた場合、下位モータードライバが強制的に上限値でクリップし、空間境界の逸脱を防ぎます。
- ハードウェア力トルクセンサー反射ループ: 1,000Hzで動作する関節センサーが想定外の接触(人間の腕との衝突など)を検知すると、VLAの指示を即座に破棄して通電を遮断し、衝撃を緩和する反射動作を発動します。
7. 実戦エンジニアリングの要点
- 物理行動は言語の新たなモダリティ: 連続モーター指令を語彙トークンとして扱うことで、ウェブ規模の常識知識をロボット制御へ転移できます。
- 二重視覚融合の重要性: 意味理解のSigLIPと空間幾何理解のDINOv2を統合することが、ミリ単位の作業成功率を左右します。
- 分位数ビニングの優位性: 動作データの実測分布に即したトークン配分が、精緻な手先制御を実現します。
- 連続拡散ポリシーが拓く未来: $\pi_0$のようなフローマッチング手法が離散量子化の揺らぎを排除し、柔軟物体の滑らかな操作を可能にします。
次回の**Lecture 17(GRAND FINALE)では、全17回の講義を総括し、《Future Research Directions: 自己進化エージェントの未来と未解決の難問》**を通じて汎用人工知能(AGI)への壮大なロードマップを完成させます。最終回でまたお会いしましょう!