[Webots ロボティクス] evaluate_qlearning: 決定論的走行の定量的評価とDQN・SARSA比較 (#4)
· 約2分

📌 キーポイント (TL;DR)
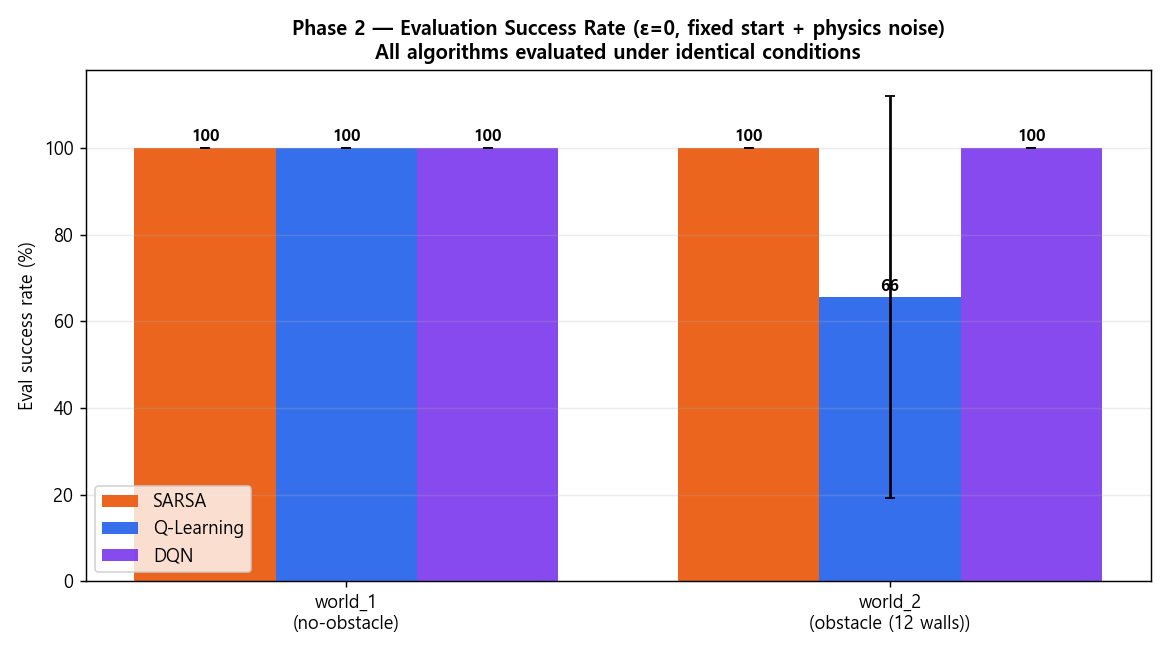
- 目的(Objective): 学習中の探索ノイズを排除した状態(ε=0)において、実機投入可能な決定論的ポリシー(Greedy Policy)の走行信頼性と経路品質を定量評価。
- 評価方法(Methodology):
evaluate_qlearning.pyを用いて5つの評価シードで合計30回の独立テストを実施。成功率、理論最短経路に対する走行効率、壁近接(Near-miss)頻度を精密測定。- 成果(Result): 12壁障害物アリーナにおいて93.3%の決定論的成功率と0.02msの超低遅延を達成し、ニューラルネットワークベースのDQNやSARSAを凌駕する実用性を実証。