[Stanford CS329A #1] コース概要:大規模言語モデルから自己改善型AIエージェントへの進化

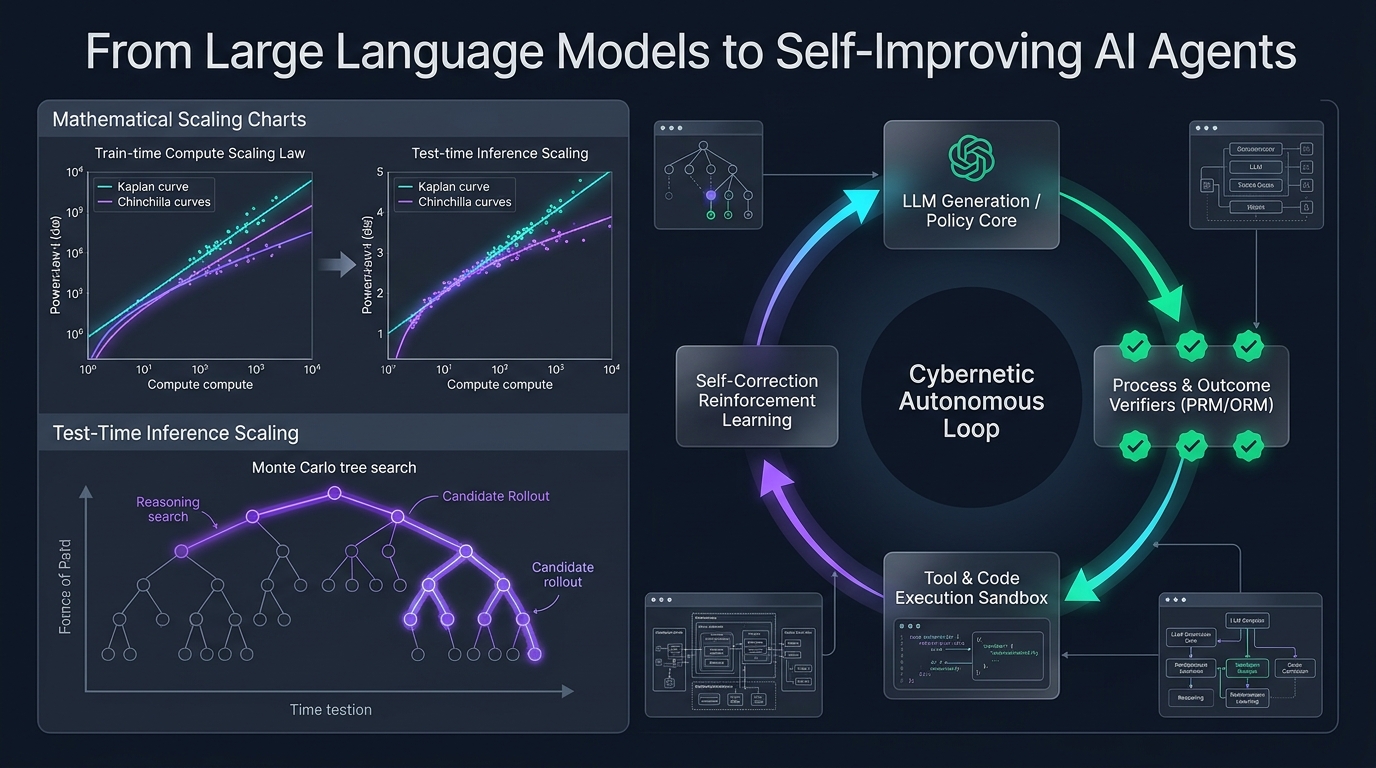
**スタンフォード大学(Stanford University)CS329A: Self-Improving AI Agents(自己改善型AIエージェント、2025年秋学期)**の技術解説へようこそ。
過去4年間、人工知能の研究と産業界は一つの強力なドグマに支配されてきました。それは、「より大規模なテキストコーパス上で、より巨大なモデルを事前学習(Pre-training)するほど、認知能力は予測可能な形で向上する」というスケーリング則(Scaling Laws)です。このパラダイムが現代の生成AI革命を牽引し、GPT-4、Claude 3.5、Geminiを生み出したことは間違いありませんが、機械学習フロンティアは今、決定的な転換点(Inflection Point)を迎えています。
静的な基盤モデル(Static Foundation Model)は、どれほどパラメータ数が膨大であっても、本質的な限界を抱えています。事前学習が完了して重みが凍結(Frozen)された後は、開ループ(Open-loop)で動作する受動的な自己回帰(Autoregressive)次トークン予測器に過ぎないという点です。難問に直面しても動的に計算リソースを追加配分できず、自身が生成した解の事実的正確性を検証できず、環境からのフィードバックをもとに誤りを自律修正することもできません。
flowchart LR
    subgraph 静的パラダイム ["従来の静的パラダイム (2020-2024)"]
        direction TB
        A1[大規模Webコーパス] --> B1[事前学習クラスタ]
        B1 --> C1[教師あり微調整 SFT]
        C1 --> D1[凍結された静的モデル]
        D1 -->|単一フォワードパス| E1[単発のテキスト応答]
    end

    subgraph 自律的自己改善パラダイム ["スタンフォードCS329A最前線:自己改善エージェント"]
        direction TB
        A2[複雑なタスク目標] ==> B2[推論・計画エンジン]
        B2 -->|実行アクション / コード下書き| C2[サンドボックス環境・ツール]
        C2 -->|実行トレースと状態| D2[プロセス検証器 PRM]
        D2 -->|報酬・エラーフィードバック| B2
        D2 ==>|推論時・訓練時アップデート| E2[持続的な自己進化]
    end
スタンフォードCS329Aが投げかける中心的な問いは次の通りです:「単にテキストを出力するだけでなく、自身の推論とコードを自ら検査、検証、計画し、改善し続けるソフトウェアエージェントをどのように構築するか?」
本講義では、基盤LLMから自律型エージェントへの進化軌跡を解き明かし、事前学習スケーリング則と推論時計算量配分の数学的定式化を学び、4大標準エージェントワークフローパターンと、自律知能の最大のボトルネックである**「生成器・検証器ギャップ(Generator-Verifier Gap)」**を徹底的に解剖します。