[Stanford CS329A #6] 訓練時スケーリングと強化学習: DeepSeekMath、GRPO、そして大規模推論最適化
· 約19分

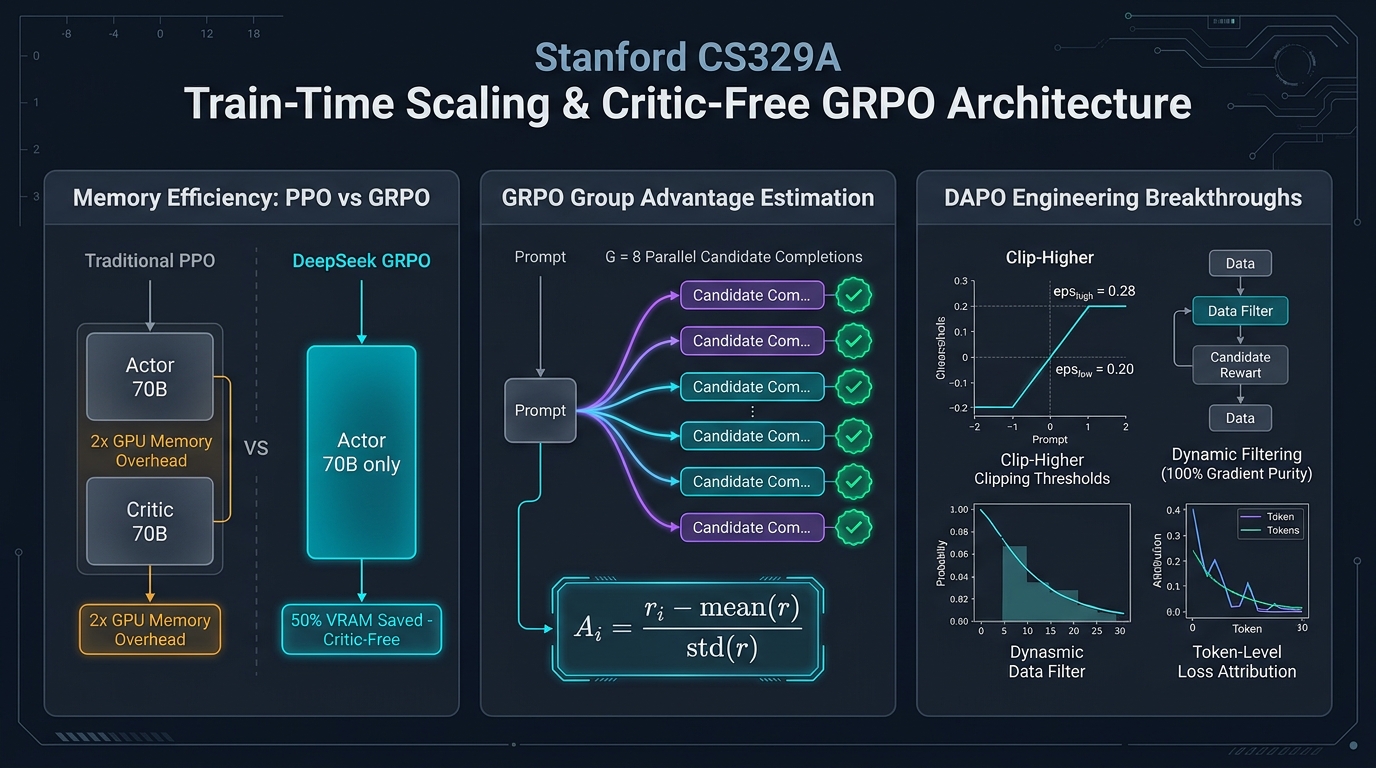
スタンフォード大学の2025年秋学期最新大学院講義、**CS329A: Self-Improving AI Agents(自己進化型AIエージェント)**の第6回エンジニアリング解説へようこそ。
第1講から第5講にわたる**Part 1(Foundation · 基礎理論)**を通じて、私たちは凍結された事前学習済みモデルに対し、推論時計算量(Test-time Compute)を集中的に投入して性能を極限まで引き出す手法を学びました。MCTS木探索を展開し、コンパイラの実行エラーを取り込み、弱検証器アンサンブルで正解を絞り込んできました。
しかし、ここで冷静に根本的な限界を直視しなければなりません: 小学生にテスト時間をさらに10分与えたとしても、大学レベルの微分積分の証明問題を解くことはできません。モデル自身の凍結されたニューラルシナプス(重みパラメータ、$\theta$)の内部に該当する数学的概念や推論ロジックが初めから存在しないならば、数千回のダイスを振ろうとビームサーチを行おうと、それは真の知能ではなく確率的な偶然にすぎません。
本日より幕を開ける**Part 2: Training & Evolution(訓練と自己進化、第6講〜第9講)**は、まさにこの根源的な問いに答える挑戦です:
「推論時に高コストな探索を行う代わりに、訓練時(Train-time)に膨大な計算量を注ぎ込み、モデルの頭脳そのものを恒久的に賢く進化させることはできないのか?」
第6講では、人間によるラベリングのボトルネックを打破し、最先端の推論モデルを誕生させた**事後強化学習(Post-Training RL)**の3大革新パラダイムを徹底的に解体・再構築します:
- 自らの正解から自らを教育する自己ブートストラップ: STaR(Self-Taught Reasoner, Zelikman et al., Stanford 2022)
- Criticモデルを葬り去った強化学習革命: DeepSeekMathとGRPO(Group Relative Policy Optimization, 2024)
- 1000基のGPUクラスタを制御する実戦エンジニアリング: DAPO(Decoupled Clip & Dynamic Sampling, 2025)
flowchart TD
    subgraph ParadigmShift ["パラダイムシフト: 推論時 vs 訓練時"]
        direction TB
        TestTime["Part 1: 推論時スケーリング (Test-Time Scaling)<br/>• ニューラル重みの凍結 (θ = 固定)<br/>• 外部ランタイム探索 (MCTS, ReAct, RLEF)<br/>• ユーザー応答遅延およびサービングコストの増大"]
        --> TrainTime["Part 2: 訓練時スケーリング (Train-Time RL)<br/>• 能動的な勾配降下法による重み更新 (θ ← θ + Δθ)<br/>• 強化学習により戦略的計画直感をシナプスへ直接内面化<br/>• 単一パス (Single-Pass) による超高速推論の実現"]
    end

    subgraph RLEvolution ["数学的推論強化学習の3段階進化"]
        direction TB
        M1["STaR (スタンフォード 2022)<br/>• 自ら正解した解答の推論過程を教師データとして再学習<br/>• 事後合理化 (Rationalization): 正解ヒントから逆方向の論理架橋<br/>• 6Bモデルが175BのGPT-3と同等の性能を達成"]
        --> M2["GRPO (DeepSeekMath 2024)<br/>• 価値関数モデル(Critic)を完全排除 (GPUメモリを50%削減)<br/>• G個のグループ内Z-score正規化でAdvantageを算出<br/>• 7BオープンモデルでGoogle Minerva 540Bを撃破"]
        --> M3["DAPO (大規模実戦オープンソース 2025)<br/>• 非対称Clip-Higher (0.28 vs 0.20)でエントロピー崩壊を阻止<br/>• ダイナミックサンプリングにより分散ゼロの無効バッチを排除<br/>• Qwen-32Bが半分のステップでDeepSeek-R1-ZeroのAIME記録を更新"]
    end

    ParadigmShift ==> RLEvolution