[Stanford CS329A #5] 多段階計画と木探索: ADaPT、LATS、SPRINT、そして言語エージェントMCTS

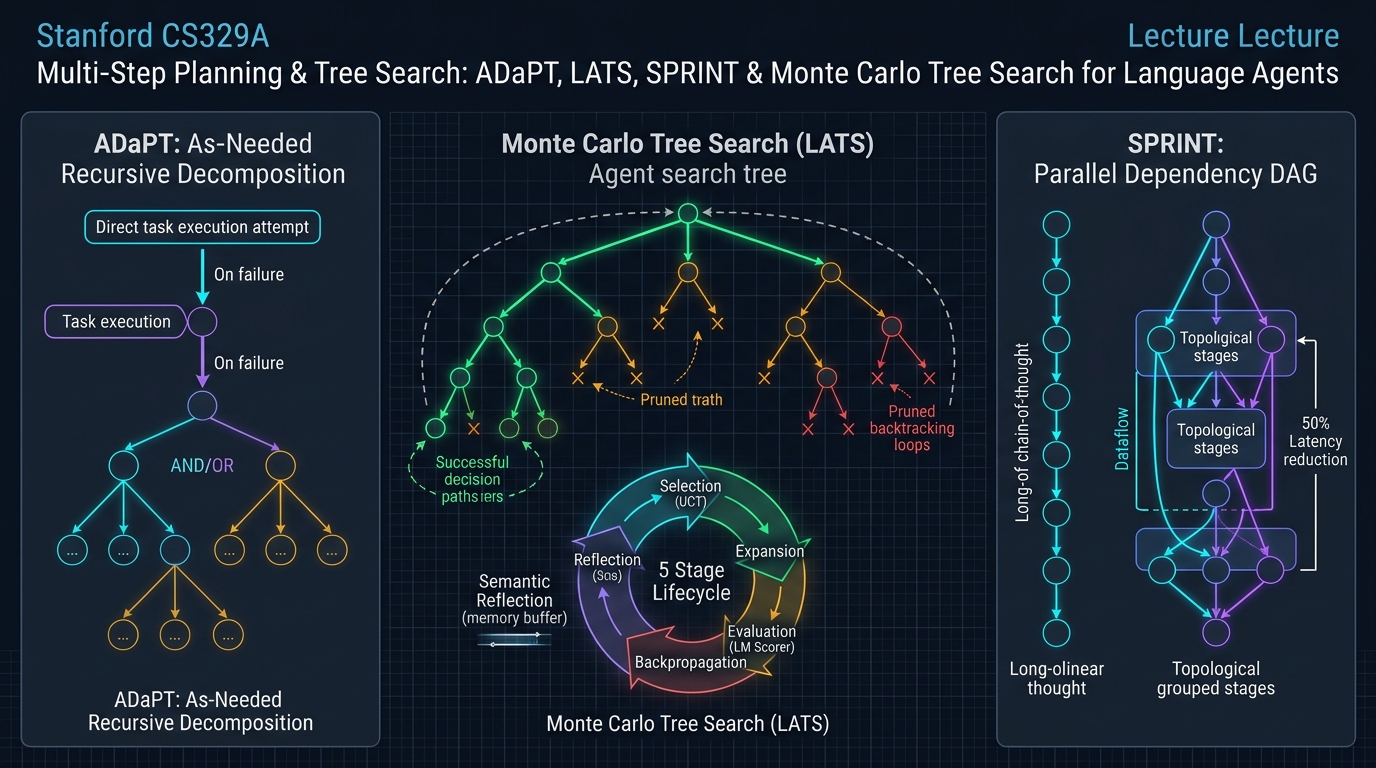
スタンフォード大学の2025年秋学期最新大学院講義、**CS329A: Self-Improving AI Agents(自己進化型AIエージェント)**の第5回エンジニアリング解説へようこそ。
第4講において、私たちは言語モデルがターミナル上でコードを実行し、コンパイラエラーを解析しながら自律的にバグを修正するツール利用と実行フィードバックループ(ReAct、RLEF)を学びました。しかし、ジュニアエンジニアが局所的なシンタックスエラーを修正することと、リードアーキテクトが10万行規模の分散ソフトウェアを設計し、長期的な課題を完遂することは全く別次元の課題です。
従来のReActや思考連鎖(CoT)アプローチは、本質的に**「目の前の一歩だけを見て前進する貪欲的(Greedy)な単一パス探索」**です。チェスにおいて直後の1手だけを見て駒を動かす初心者が3手先でチェックメイト(詰み)に陥るのと同様に、貪欲な言語モデルも複雑な多段階タスクにおいて序盤で誤った決定を下すと、後戻りできずに袋小路に閉じ込められてしまいます。
本日の第5講は、カリキュラムの前半部である**Part 1(Foundation · 基礎理論)を締めくくる壮大なフィナーレです。テーマは「多段階計画(Multi-Step Planning)と木探索(Tree Search)」**です。
囲碁で世界王者を破ったAlphaGoの数学的心臓部である**モンテカルロ木探索(MCTS)**を自己回帰型言語モデルに移植し、チェスのグランドマスターのように数十手先を見据えて自律的に計画を立案し、失敗した場合には過去の分岐点へとバックトラック(Backtracking)して別の可能性を探索する知的アーキテクチャを解体・再構築します:
- 推論・行動・計画の完全統合: 言語エージェント木探索 LATS(Zhou et al., 2023)
- 失敗時のみ賢く分解する適応的タスク細分化: ADaPT(Allen AI, 2023)
- 推論遅延を53.5%圧縮する並列DAGパッキング: SPRINT(Stanford Future Data, 2025)
- トンプソン抽出に基づく適応的分岐: 探索を横に広げるか深く掘るかを解決する AB-MCTS(Sakana AI, 2025)
- 計画能力をモデル重みへと直接焼き付ける: SWiRL(Step-Wise RL, 2025)
flowchart TD
    subgraph MCTS_Loop ["LATS言語エージェントMCTSエンジン"]
        direction TB
        Root["ルートノード: ユーザー課題 / 仕様要件"]
        --> Select["1. 選択 (Selection): UCT指標最大化ノードの探索"]
        --> Expand["2. 展開 (Expansion): n個の多様な行動候補のサンプリング"]
        --> Eval["3. 評価 (Evaluation): LMスコア + 自己一貫性アンサンブル"]
        --> Backprop["4. 逆伝播 (Backpropagation): 上位ノードへの価値伝播"]
        --> Reflect["5. 言語的反省 (Semantic Reflection): 失敗原因のテキスト記録"]
    end

    subgraph PlanningParadigms ["エージェント計画アルゴリズムの進化系譜"]
        direction TB
        P1["LATS (木探索 MCTS)<br/>• プロンプト履歴復元によるコストゼロのバックトラッキング<br/>• HumanEvalで92.7%達成; HotpotQA正答率が32%から71%へ急増"]
        --> P2["ADaPT (適応的再帰分解)<br/>• 硬直的な事前計画を排除し、単一実行器でまず試行<br/>• 失敗報告時のみAND/ORサブタスクへ柔軟に動的分解"]
        --> P3["SPRINT (依存関係DAGパッキング)<br/>• 長文推論ステップ間の相互独立性をグラフ理論で抽出<br/>• GPUクラスタによる並列実行でエンドツーエンド遅延を53.5%削減"]
        --> P4["SWiRL (ステップ単位強化学習)<br/>• MCTS探索の叡智をモデル神経重みに直接内面化<br/>• 単一パス推論でグランドマスター級の戦略的先見性を獲得"]
    end

    MCTS_Loop ==> PlanningParadigms