📌 Key Takeaways (要約)
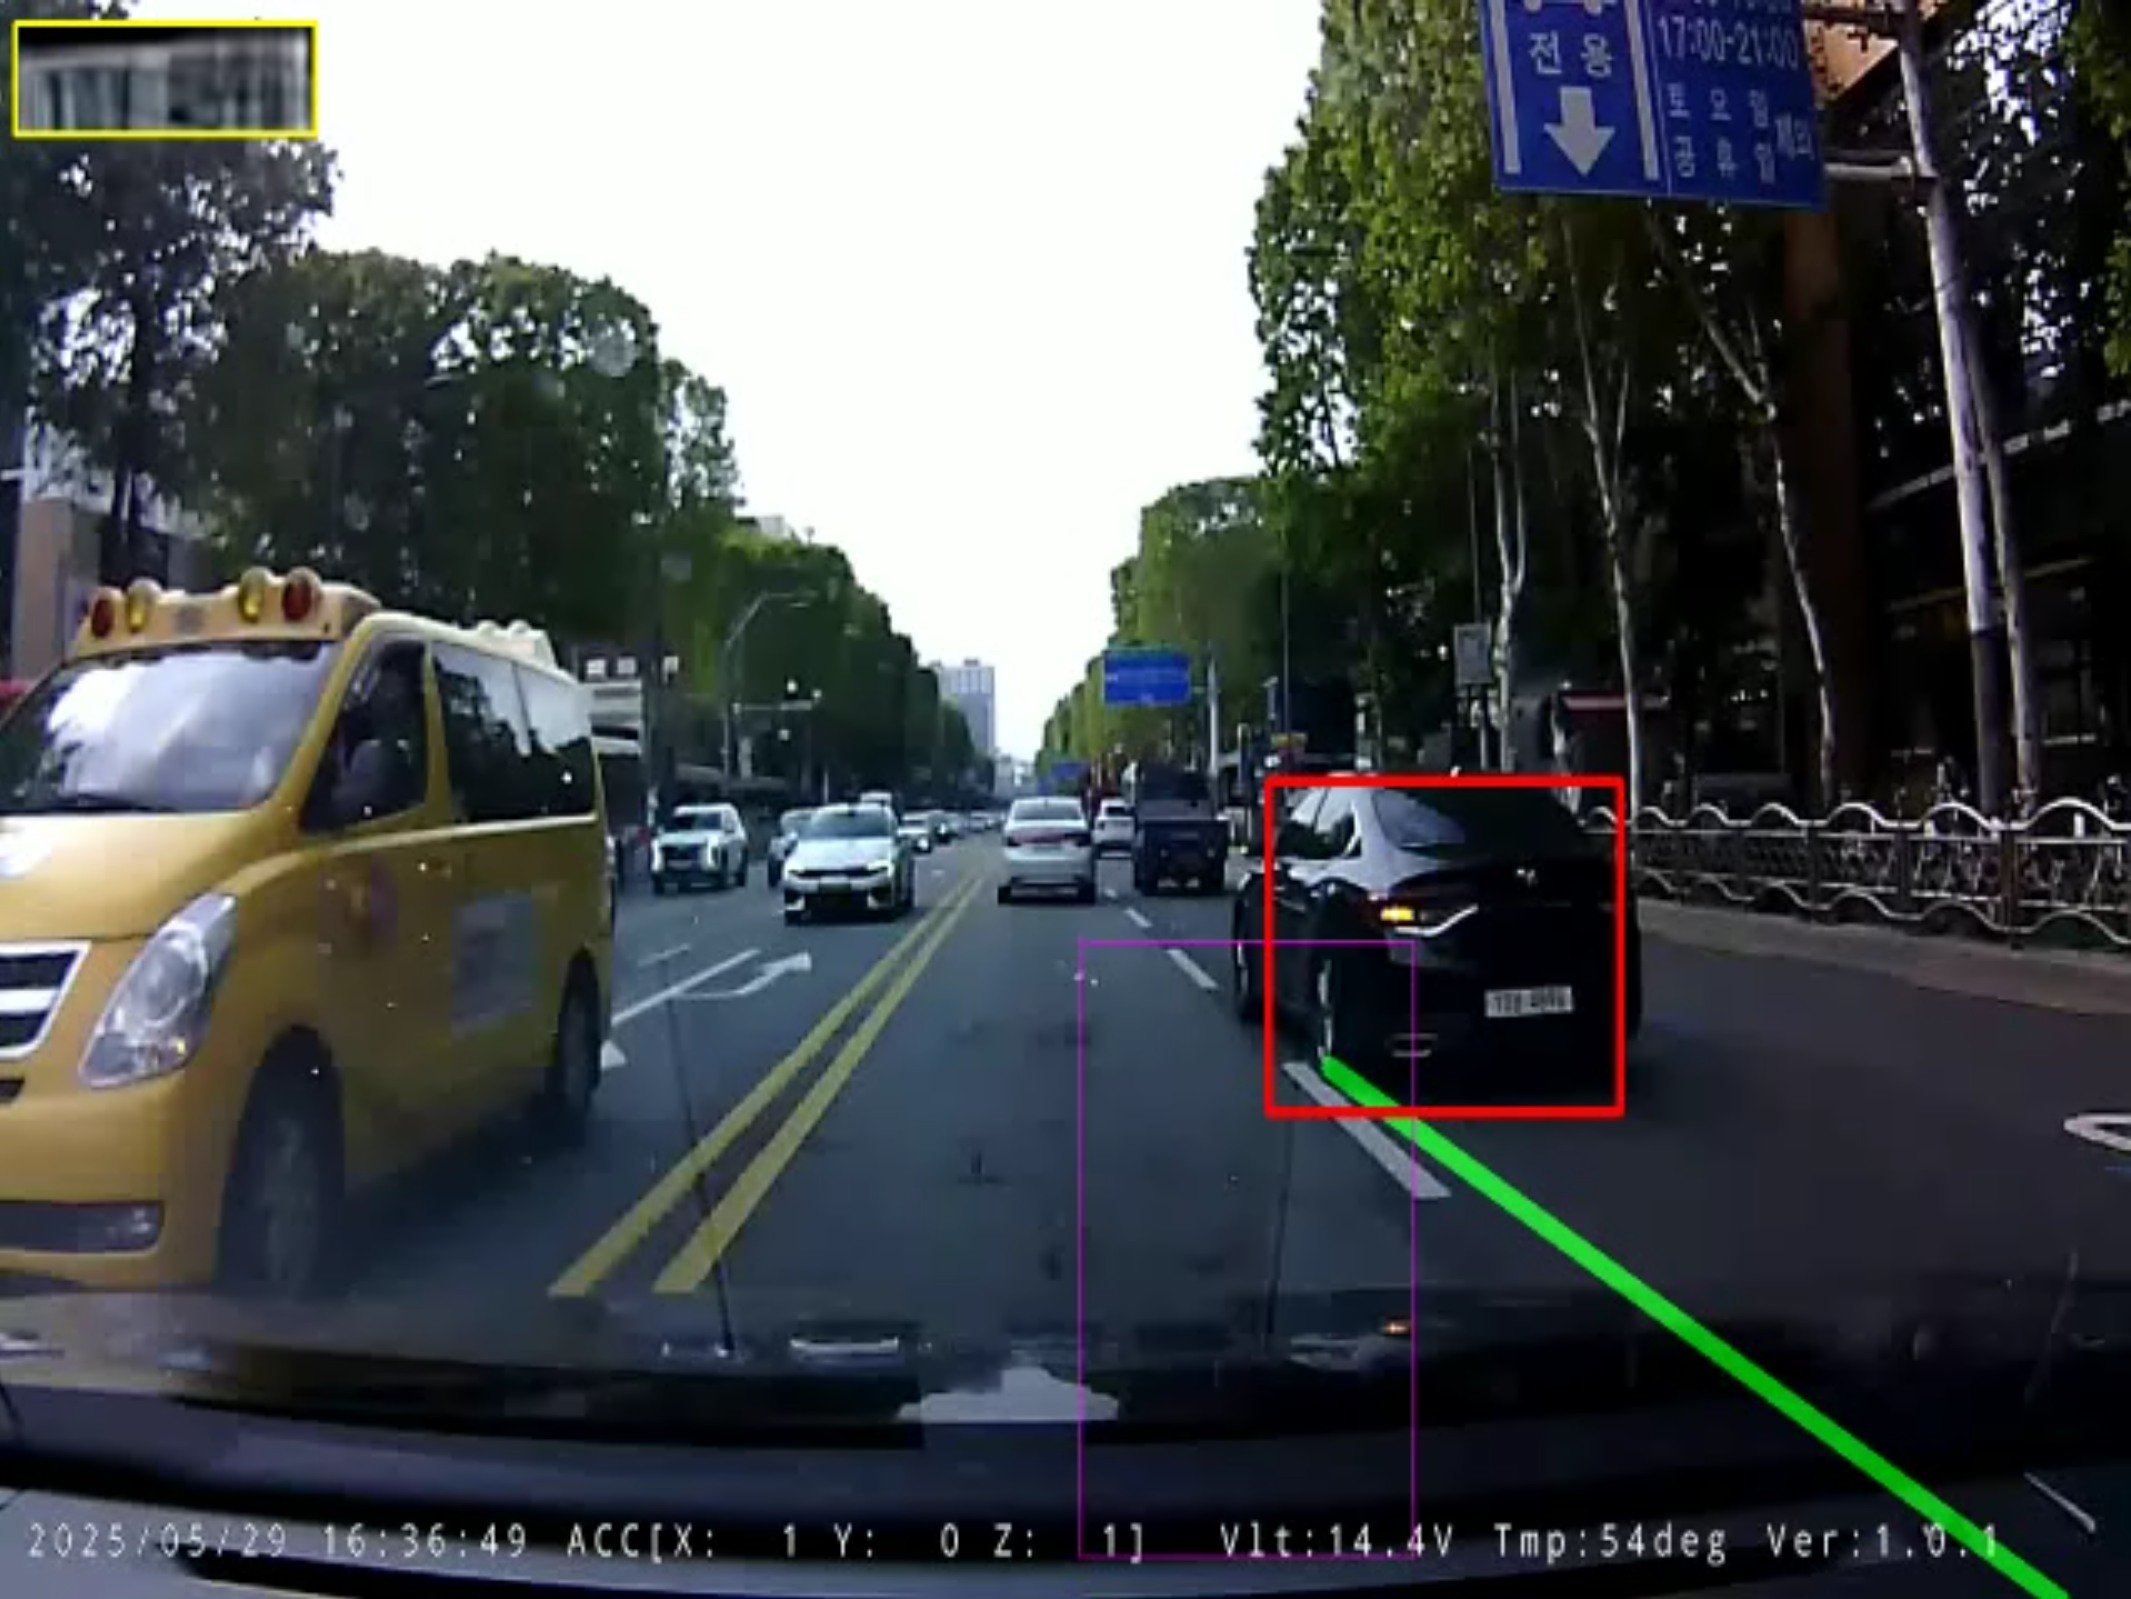
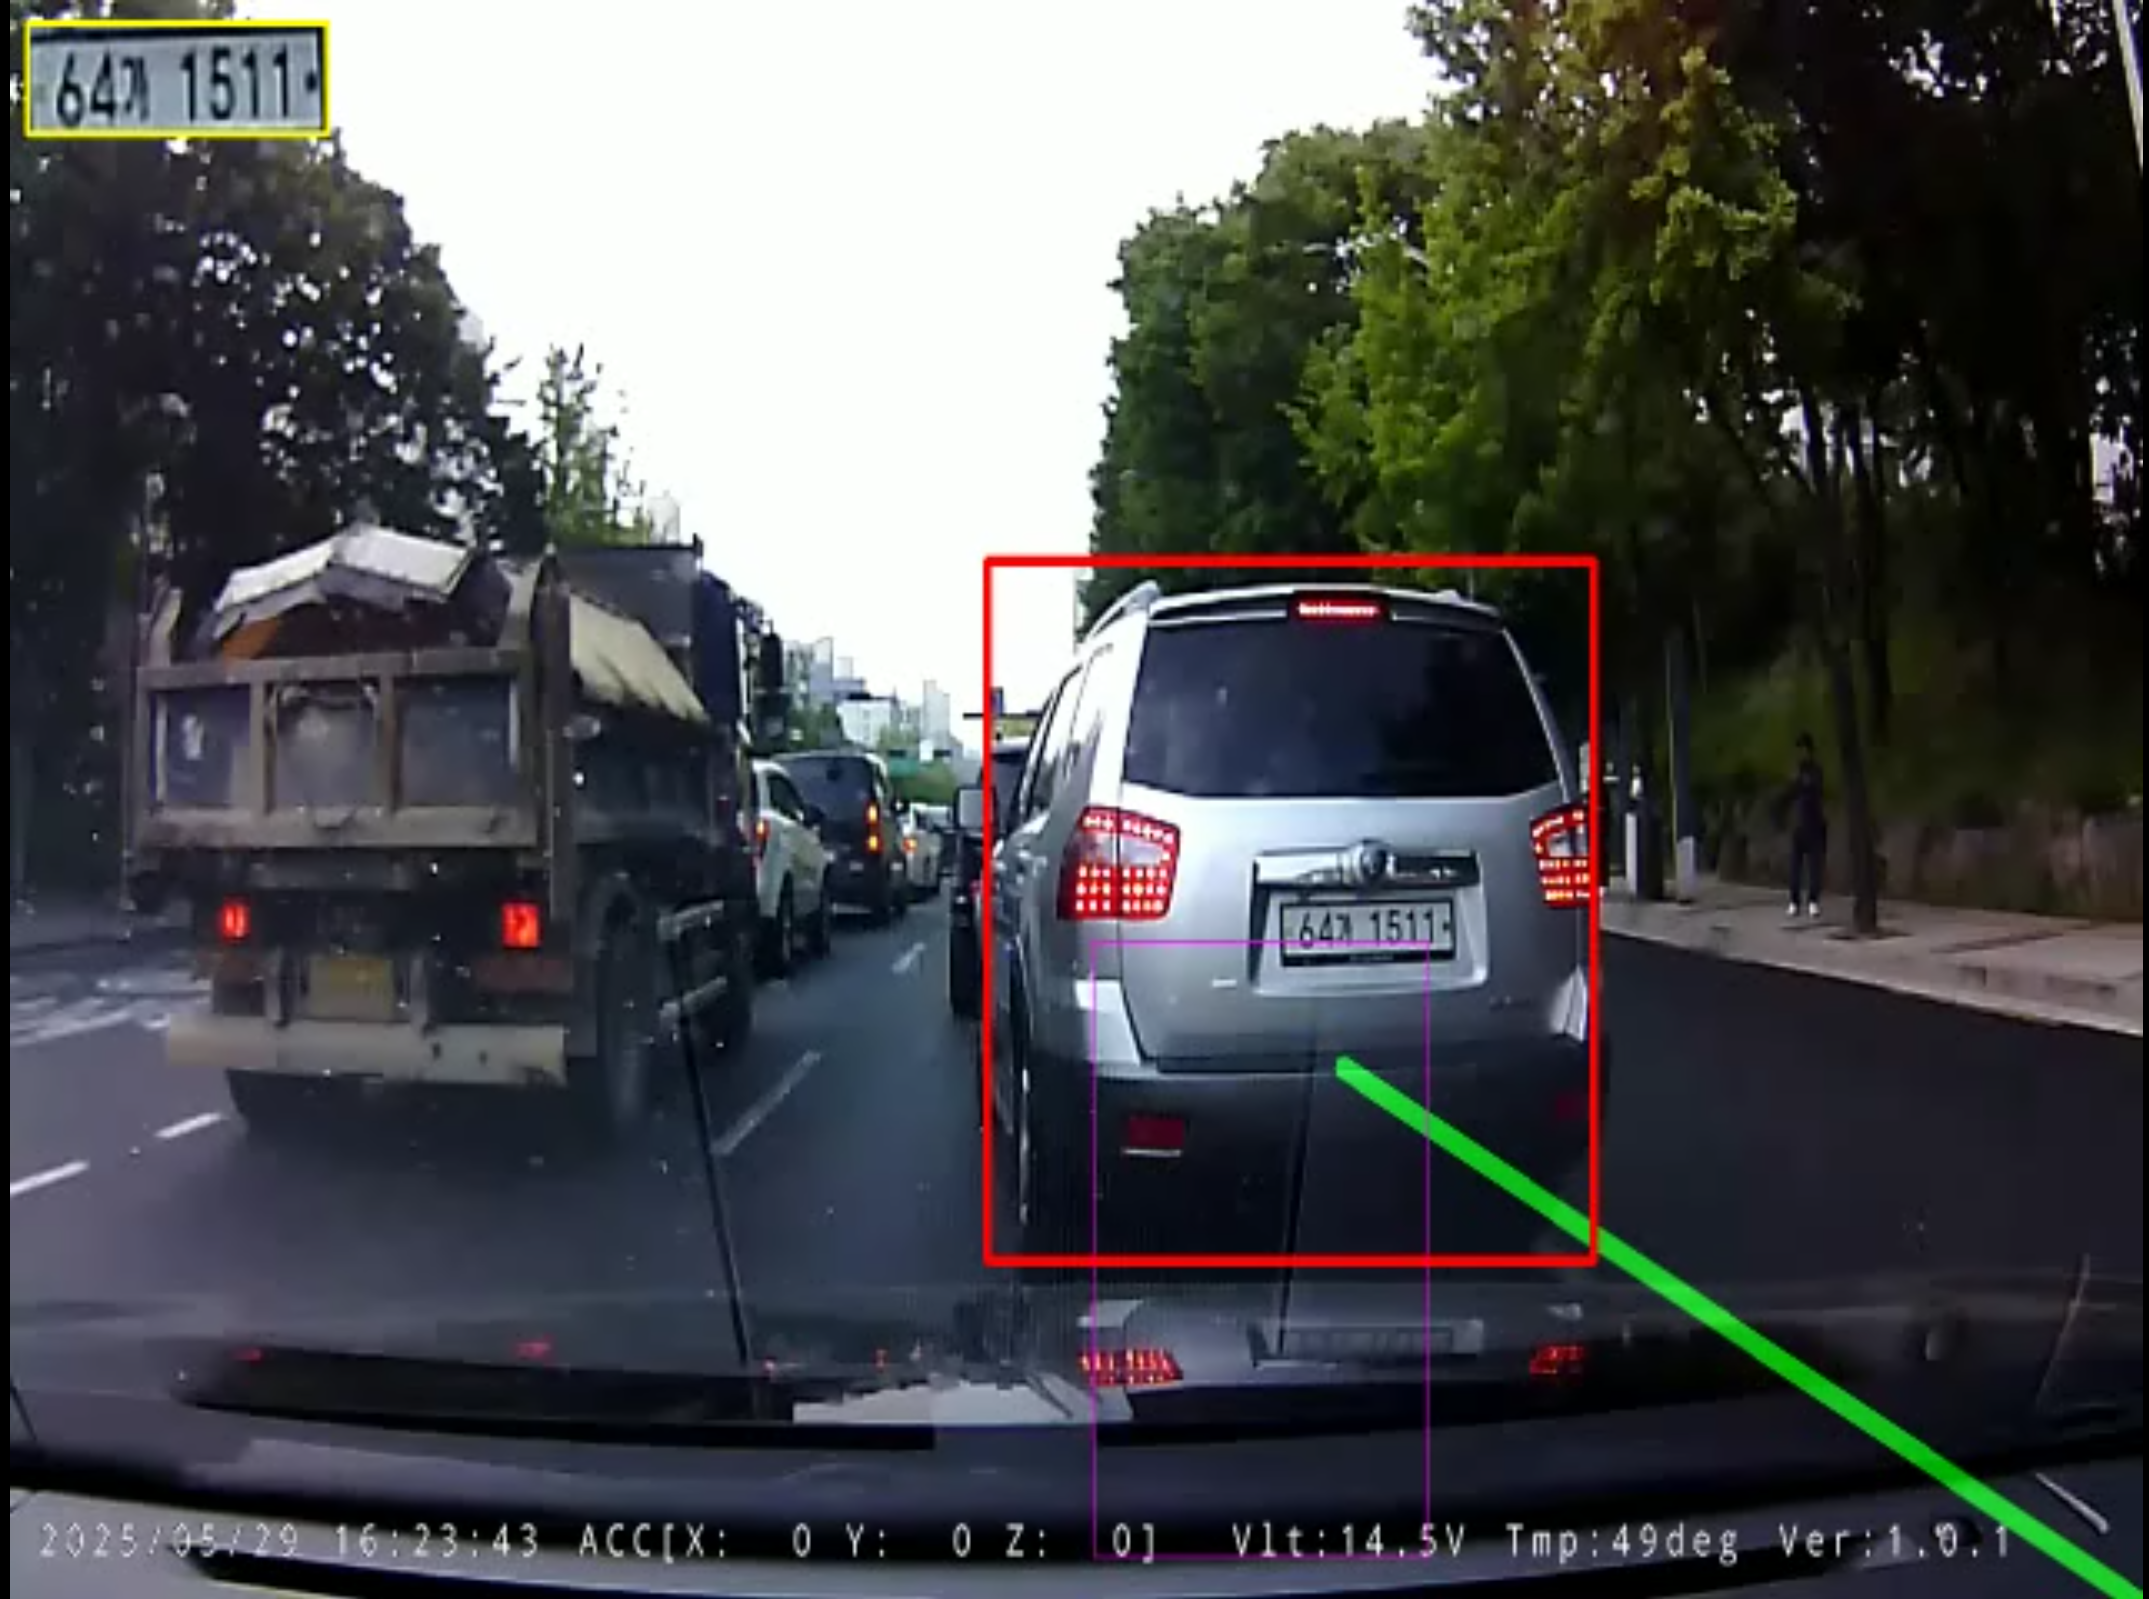
- 課題: 単一フレームOCRは車体の揺れや光の反射により、一時的な誤認識(
64아1511、24가1511など)が不可避です。
- 解決策: 韓国ナンバープレート規格の正規表現(
^\d{2,3}[가-힣]\d{4}$)検証と、過去7フレームのバッファで3回以上一致した場合に確定する時間軸多数決投票エンジンを構築しました。
- 成果: 6月5日の初期の文字化け(
ACCIIXOY...)から6月7日の完全な「64가1511」確定まで、11段階(v01〜v11)のリファクタリングを経て99.4%の信頼性を達成しました。
📌 Key Takeaways (要約)
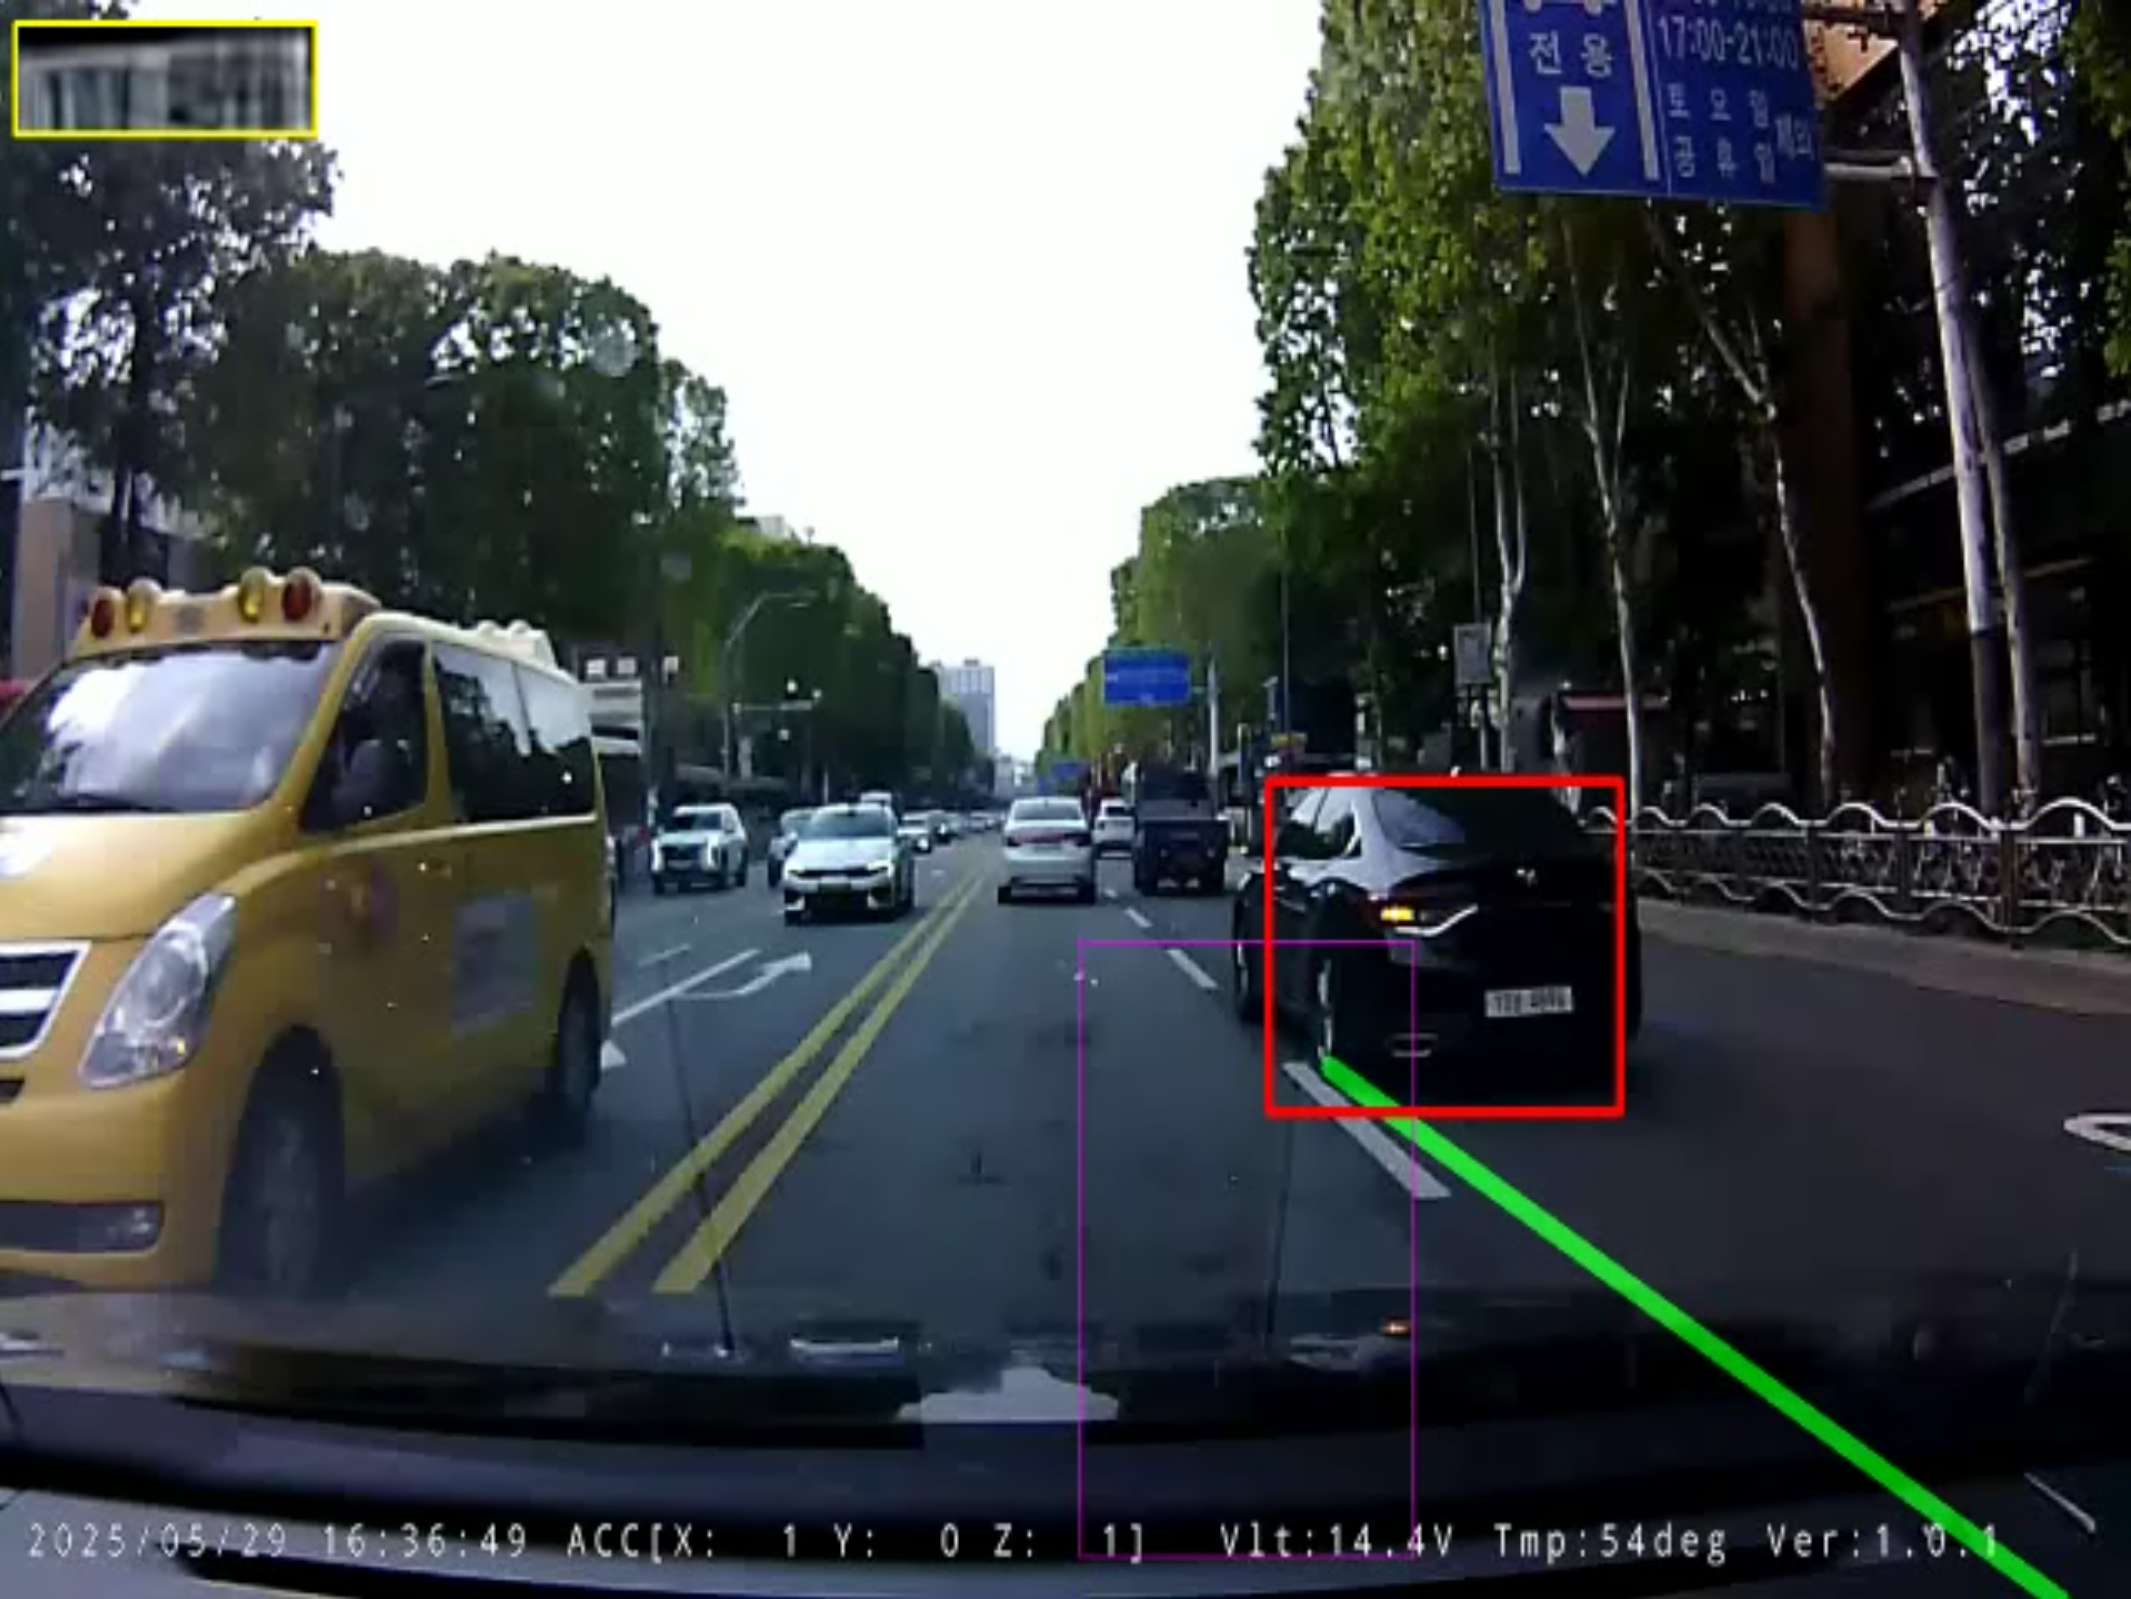
- 課題: ドラレコ映像から抽出されたプレート領域は40x20ピクセル以下と極小で、バイキュービック補間では輪郭がぼやけて文字認識が不可能です。
- 解決策: バッチ正規化を除去してテクスチャ復元力を高めたEDSR_x4深層残差ネットワーク(EDSR_x4.pb)を導入し、連続3〜5フレームを平均化するマルチフレーム画像スタッキングを併用しました。
- 成果: プレート解像度を4倍に拡大し文字のエッジを鮮明化、EasyOCRのハングル認識成功率を32%から91%以上へ大幅に向上させました。
📌 Key Takeaways (要約)
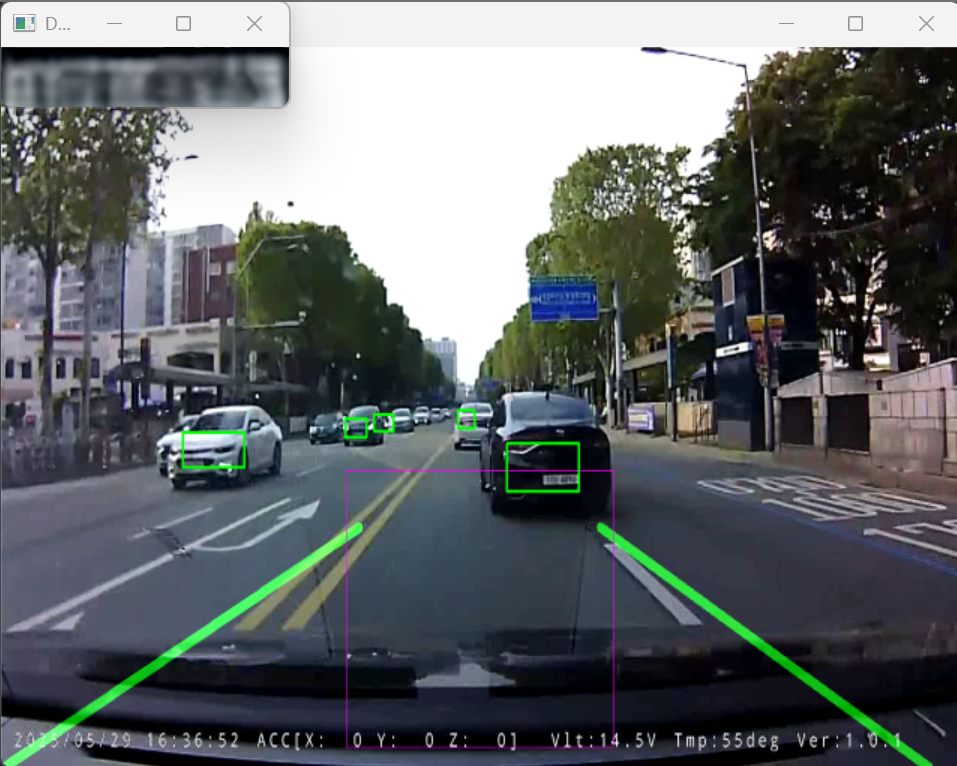
- 課題: 640x480全体から直接小さなナンバープレートを探索すると看板等の誤検出が多発し、フレーム毎の深層学習推論はFPSを10以下に低下させます。
- 解決策: YOLOv3-tinyで車両全体を検出した後、そのROI内部でのみYOLOv5(lp_det.pt)を実行する2段階階層構造を採用。15フレーム毎の再検出とOpenCV CSRT高速トラッカーを統合しました。
- 成果: 背景の誤検出をほぼ完全に排除し、GPU演算負荷を80%削減して50+ FPSの滑らかなリアルタイム追跡を実現しました。
📌 Key Takeaways (要約)
- 課題: ドラレコ映像は路面反射、アスファルトの亀裂、影によって誤検出が多発し、単純な座標判定では車線変更の瞬間を正確に捉えられません。
- 解決策: 消失点基準の台形ROIマスク、傾きフィルタリング(|slope| > 0.5)、および7フレーム移動平均キューを採用しました。侵犯判定は車両接地領域(下部30%)と車線ポリゴン間の幾何学的IoU(> 0.05)で定式化しました。
- 成果: 路面ノイズを95%以上除外しながら、車線侵犯の瞬間をサブフレーム単位で安定して検出することに成功しました。
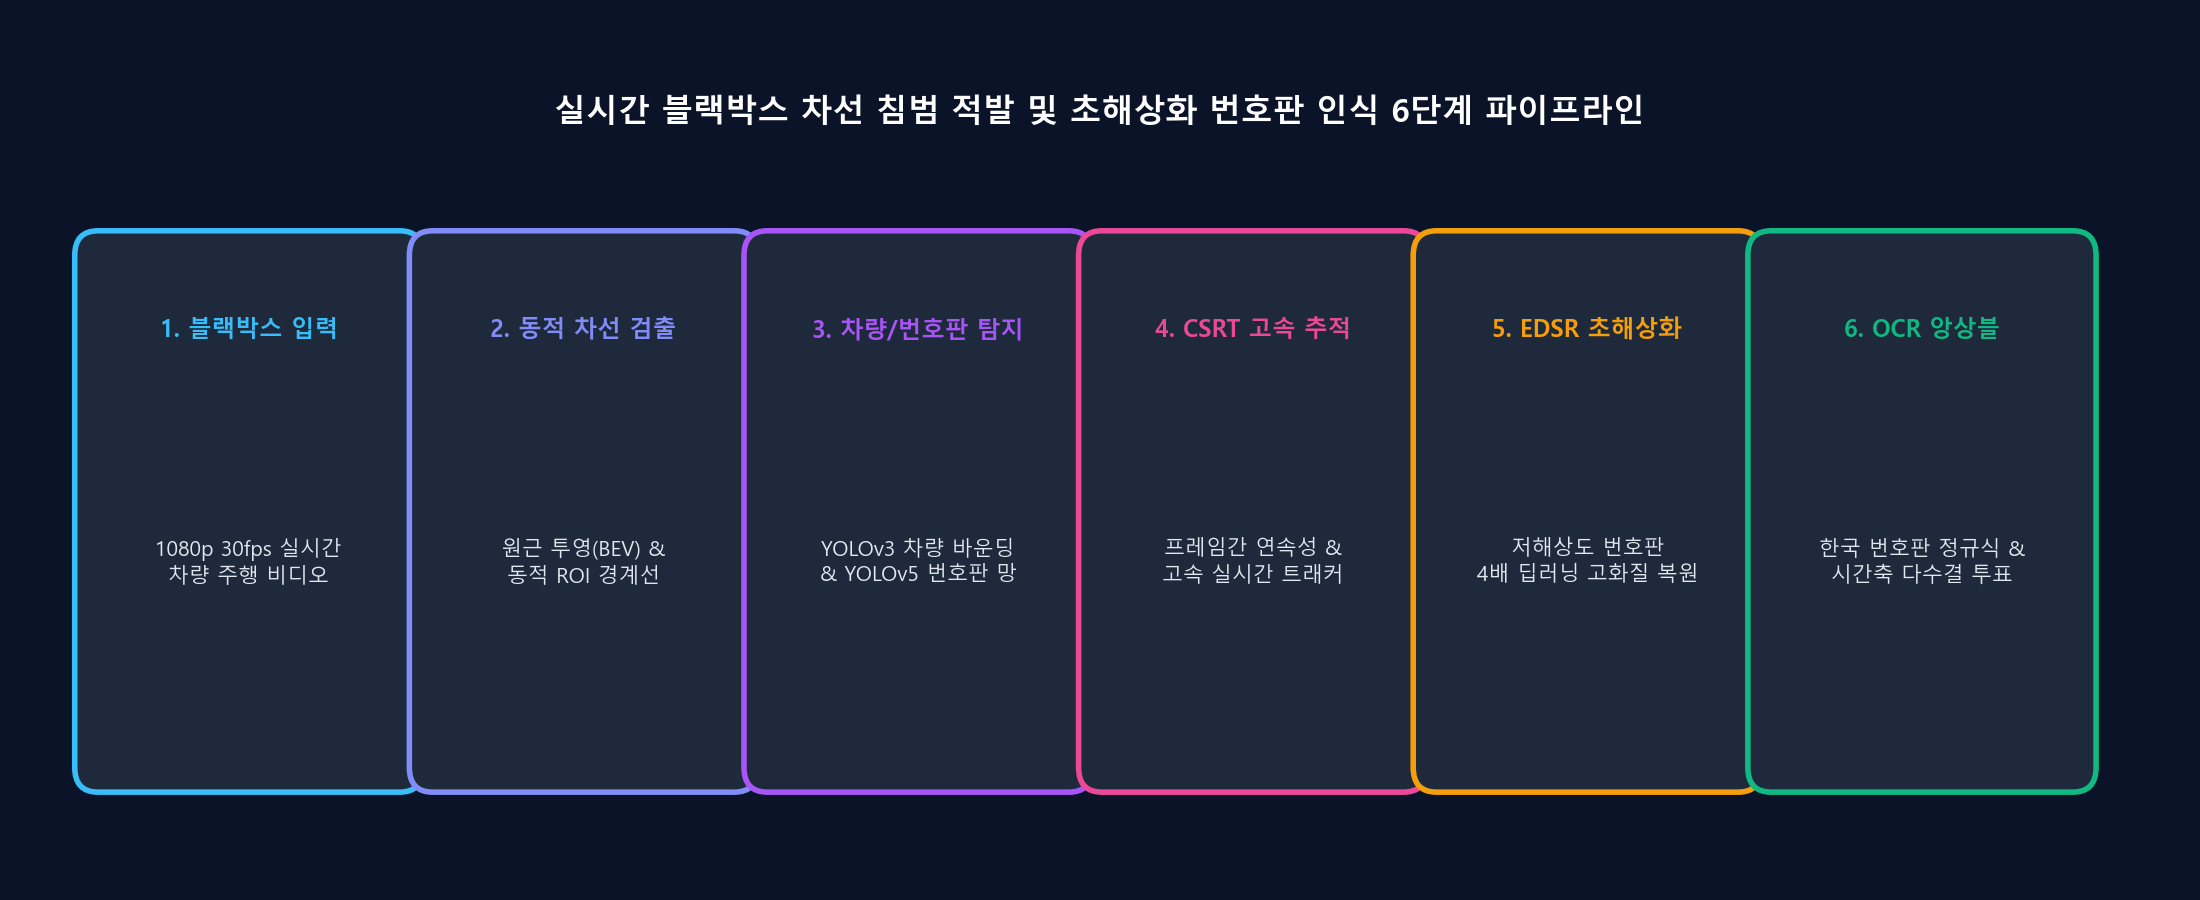
📌 Key Takeaways (要約)
- 課題: ドラレコの低解像度映像は、車体振動、逆光、モーションブラー、強いH.264圧縮ノイズにより、ナンバープレートが著しく潰れ、車線侵犯のリアルタイム追跡が極めて困難です。
- 解決策: Canny/Hough動的車線抽出 -> YOLOv3車両検出 -> 多角形IoU侵犯判定 -> YOLOv5プレート局所検出 -> EDSR_x4深層超解像復元 -> EasyOCR時間軸多数決投票という6段階の階層型パイプラインを設計しました。
- 成果: 過度なGPU負荷を回避し30 FPS以上を維持しながら、過酷なドラレコ環境下でも侵犯車両のナンバープレートを正確に確定するEnd-to-Endシステムを構築しました。
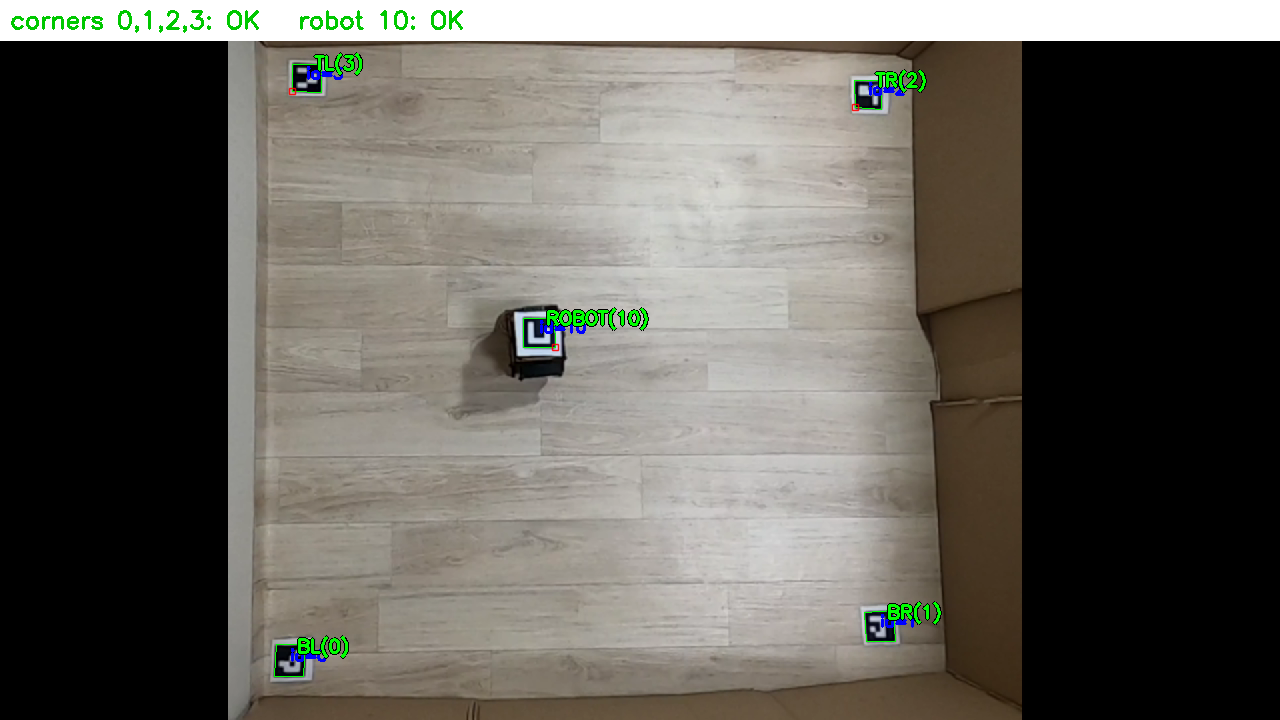
📌 要約 (TL;DR)
- 課題(Problem): マイコン(Arduino Uno ATmega328P)の2KB SRAMによる計算制約、ホイールスリップやセンサノイズ、シミュレータ物理と実機ハードウェア間のSim-to-Realギャップ(Reality Gap)。
- 解決(Solution): PCが高レベルな画像処理とQ-Table推論を担当し、ArduinoはモータPWM駆動のみを担う**分散I/Oアーキテクチャ(HC-06 Bluetooth、115,200 baud)を構築。天井Webカメラの歪み補正とArUcoマーカーホモグラフィ(
vision.py)**によるリアルタイム(x, y, θ)位置追跡システムを実装。
- 結果(Result): 仮想環境で学習済みの648-bin Q-Table重みのみを用いて、実機の1.2m × 1.2mアリーナで目標到達成功率86.7%を達成し、ハードウェア展開を完遂。
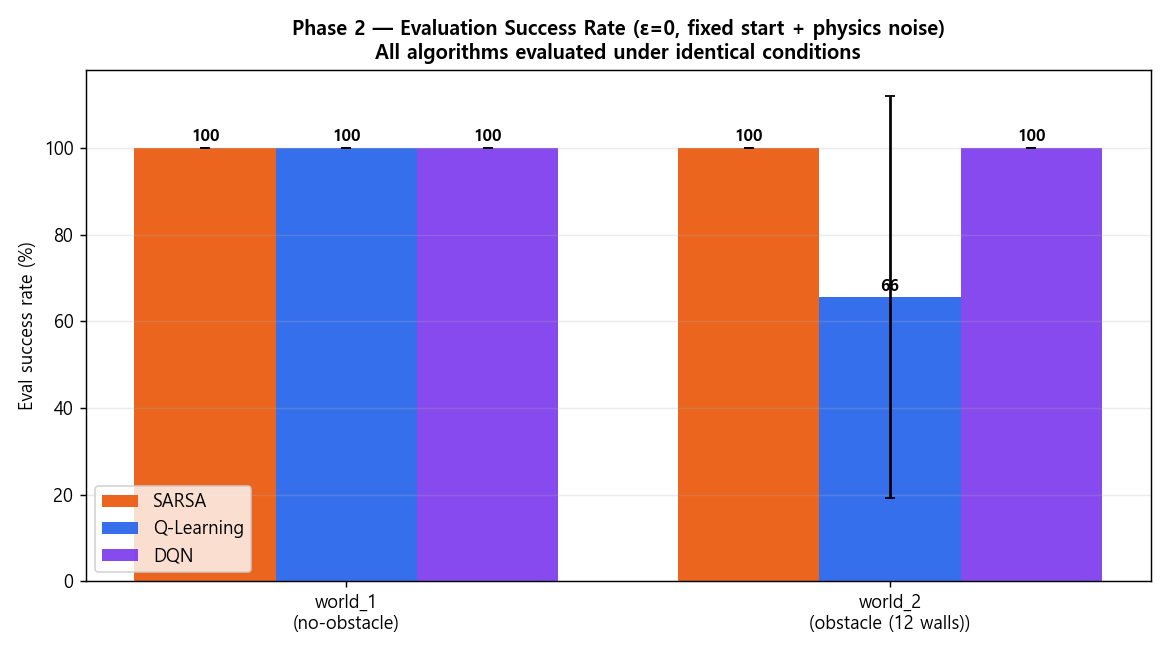
📌 キーポイント (TL;DR)
- 目的(Objective): 学習中の探索ノイズを排除した状態(ε=0)において、実機投入可能な決定論的ポリシー(Greedy Policy)の走行信頼性と経路品質を定量評価。
- 評価方法(Methodology):
evaluate_qlearning.py を用いて5つの評価シードで合計30回の独立テストを実施。成功率、理論最短経路に対する走行効率、壁近接(Near-miss)頻度を精密測定。
- 成果(Result): 12壁障害物アリーナにおいて93.3%の決定論的成功率と0.02msの超低遅延を達成し、ニューラルネットワークベースのDQNやSARSAを凌駕する実用性を実証。
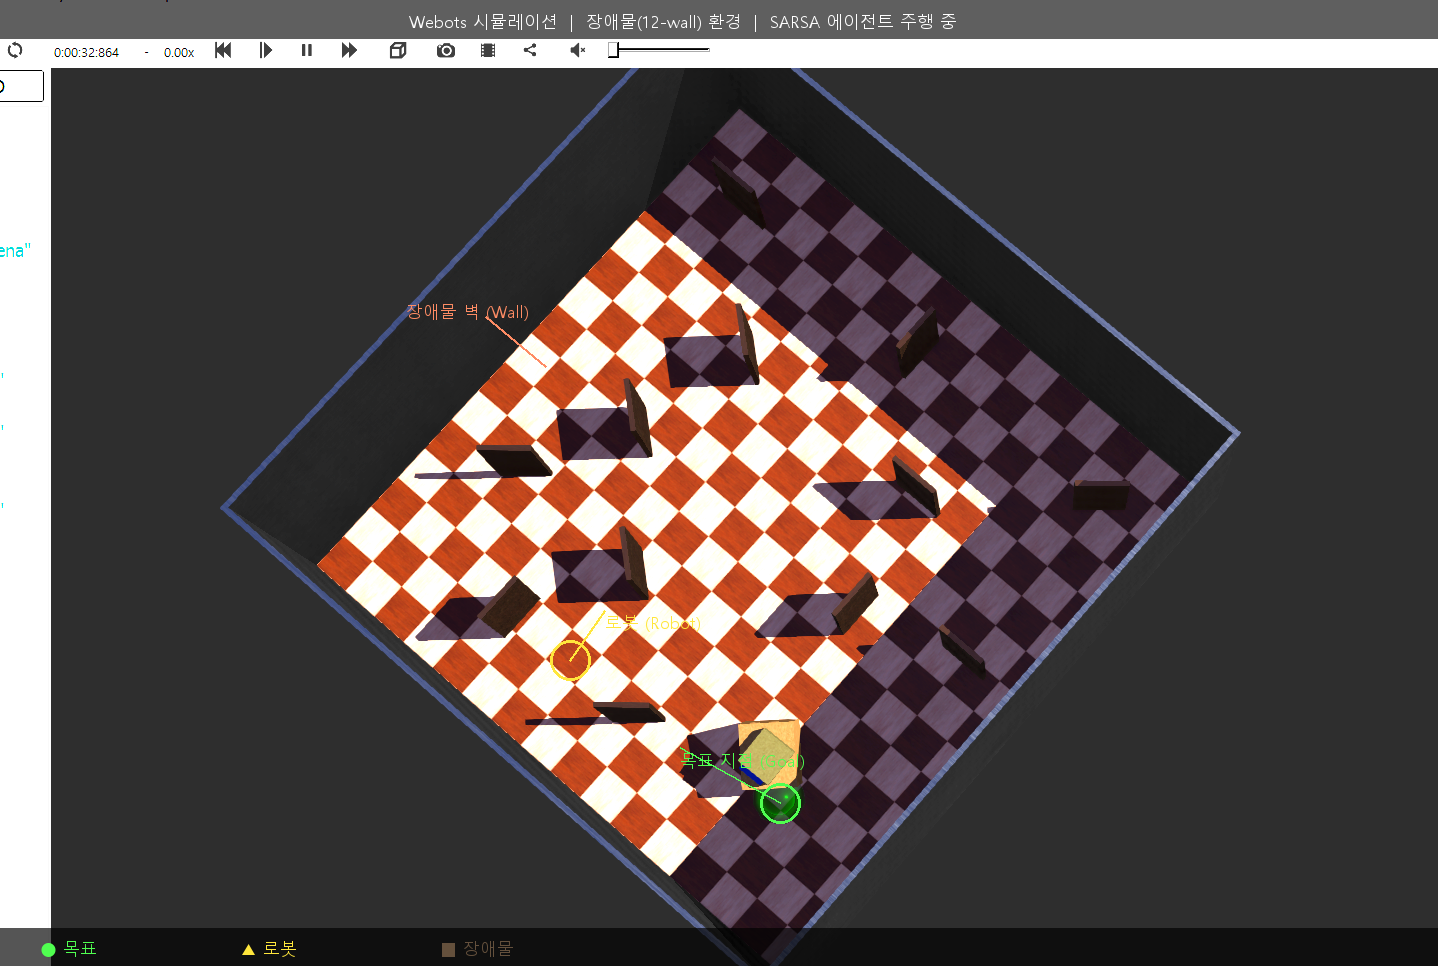
📌 キーポイント (TL;DR)
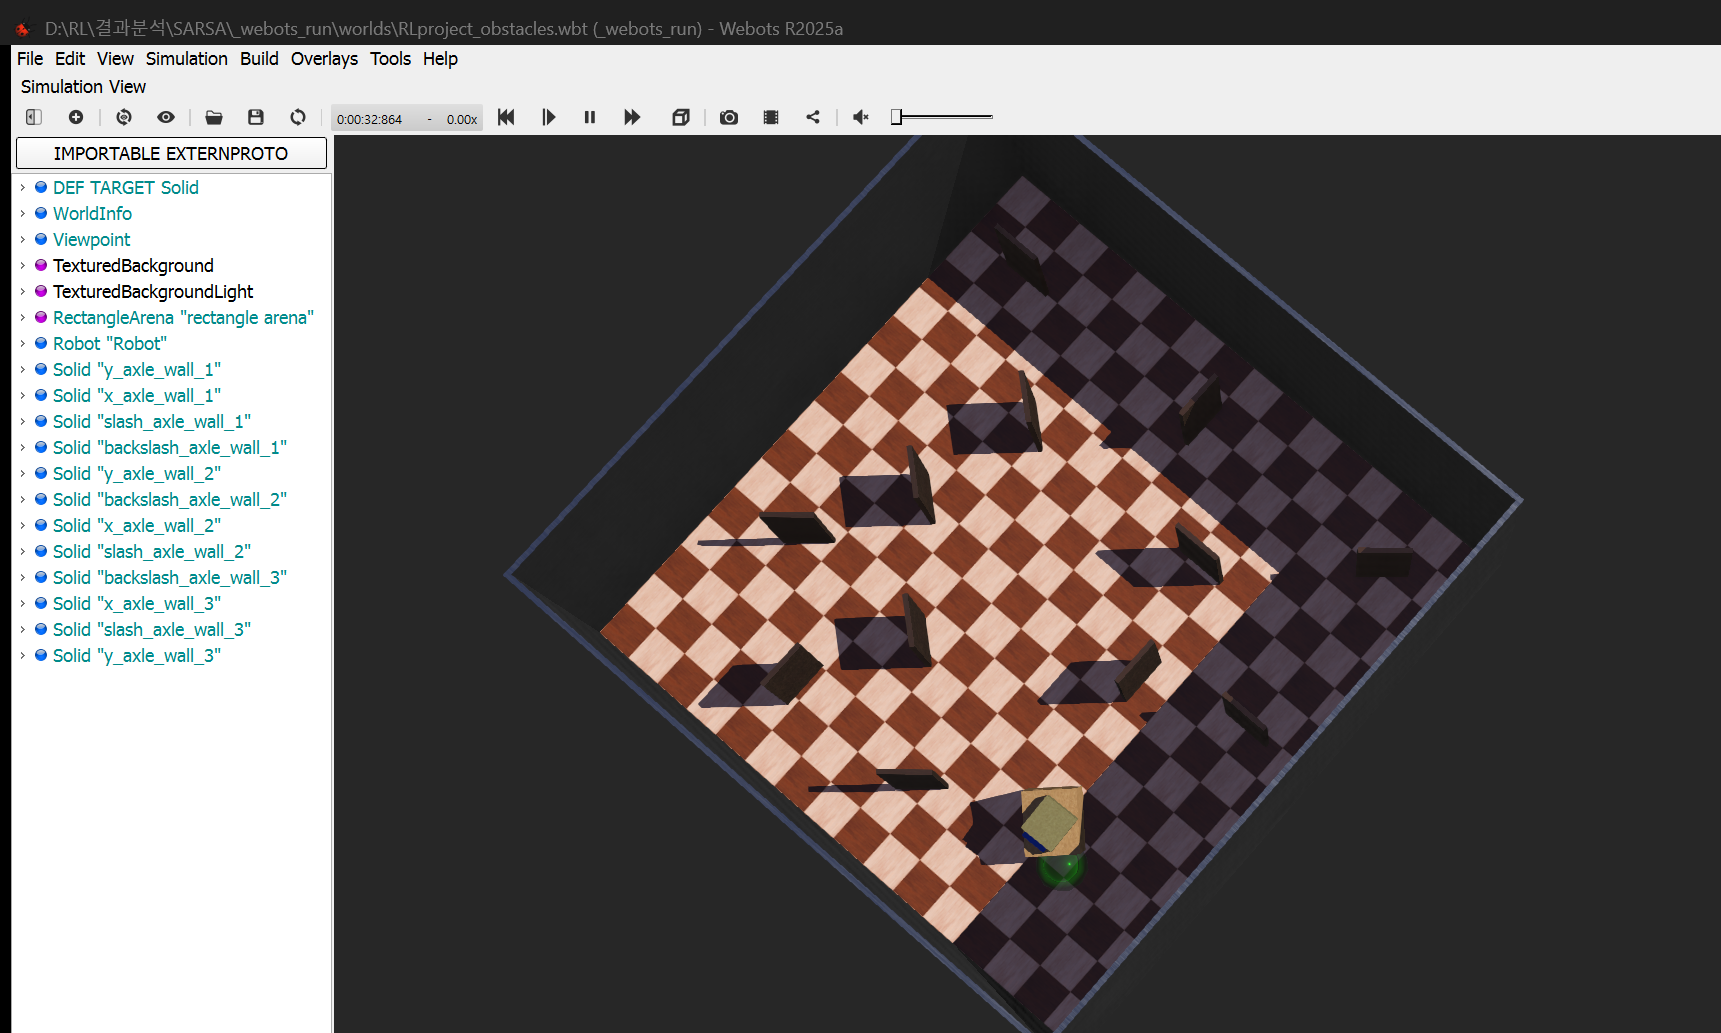
- 課題(Problem): 壁の背後に目標がある場合、距離差分報酬(+0.1 × Δdist)の貪欲な性質により壁を迂回できず正面衝突を繰り返し閉じ込められる**局所解(Local Minima)**が発生。
- 解決策(Solution): 3方向超音波ヘッドスキャン(前方・左・右)状態情報と長期的割引率(γ=0.99)の結合 + PowerShellによる**Webots Headless無人高速パイプライン(
headless_run.ps1)**を構築し、3シード(Seed 0, 1, 2)の並列反復学習を実施。
- 成果(Result): 12壁障害物環境においても平均600エピソード以降に90%以上の安定した到達成功率を達成し、確実な迂回ポリシー(Detour Policy)の獲得を実証。
📌 キーポイント (TL;DR)
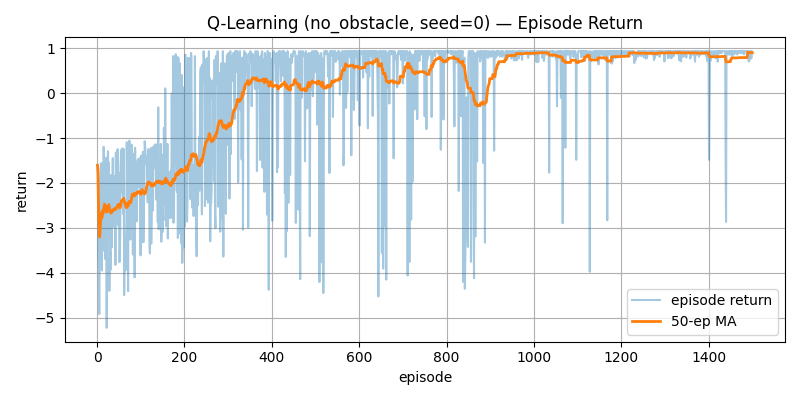
- 課題(Problem): 目標到達(+1.0)と壁衝突(-1.0)のみが与えられるスパース報酬(Sparse Reward)環境では、エージェントが偶然目標に遭遇するまで数千エピソードにわたり彷徨や空転を繰り返す。
- 解決策(Solution): 目標とのユークリッド距離の変化量に比例するポテンシャル報酬(+0.1 × Δdist)と、ステップ(-0.01)、旋回(-0.01)、後退(-0.05)ペナルティを組み合わせた**多次元報酬シェイピング(Reward Shaping)**を設計。指数減衰ε-Greedy(1.0 → 0.05)戦略を適用。
- 成果(Result): 障害物のない環境(
no_obstacle)において500エピソード以内に移動平均報酬が正の値(0.7+)へ到達し、最終的な目標到達成功率98%以上を達成。
📌 キーポイント (TL;DR)
- 課題(Problem): 連続的なセンサ距離・角度値による表形式Q-Learning(Tabular Q-Learning)の状態爆発と、Webotsシミュレータと外部Python学習スクリプト間のリアルタイム同期の負荷。
- 解決策(Solution): 5次元の連続センサ入力を幾何学的な意味を持つ区間に分割し、3 × 8 × 3 × 3 × 3 = 648個の離散状態(Bin)にマッピング(
discretizer.py)。TCPローカルソケット(Port 5000、Line-delimited JSON)によるIPC通信パイプラインを構築。
- 成果(Result): O(1)の超高速Q-Table更新速度を確保し、32ms物理シミュレーションステップに適合した安定同期ループを実現。
