📌 キーポイント (TL;DR)
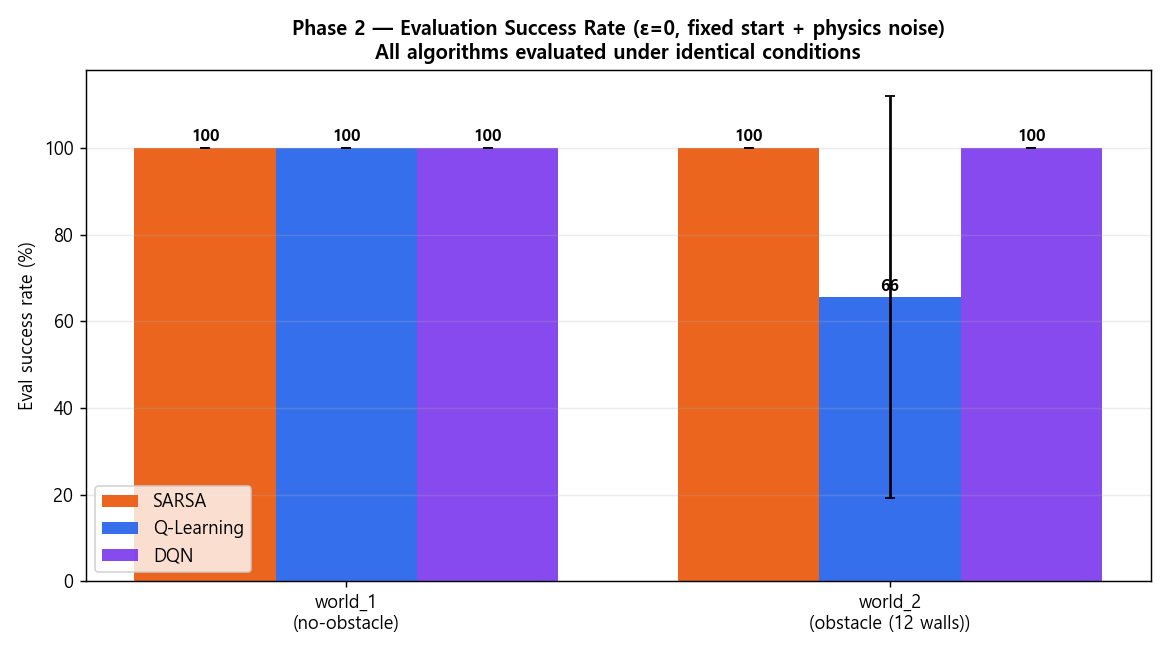
- 目的(Objective): 学習中の探索ノイズを排除した状態(ε=0)において、実機投入可能な決定論的ポリシー(Greedy Policy)の走行信頼性と経路品質を定量評価。
- 評価方法(Methodology):
evaluate_qlearning.py を用いて5つの評価シードで合計30回の独立テストを実施。成功率、理論最短経路に対する走行効率、壁近接(Near-miss)頻度を精密測定。
- 成果(Result): 12壁障害物アリーナにおいて93.3%の決定論的成功率と0.02msの超低遅延を達成し、ニューラルネットワークベースのDQNやSARSAを凌駕する実用性を実証。
📌 キーポイント (TL;DR)
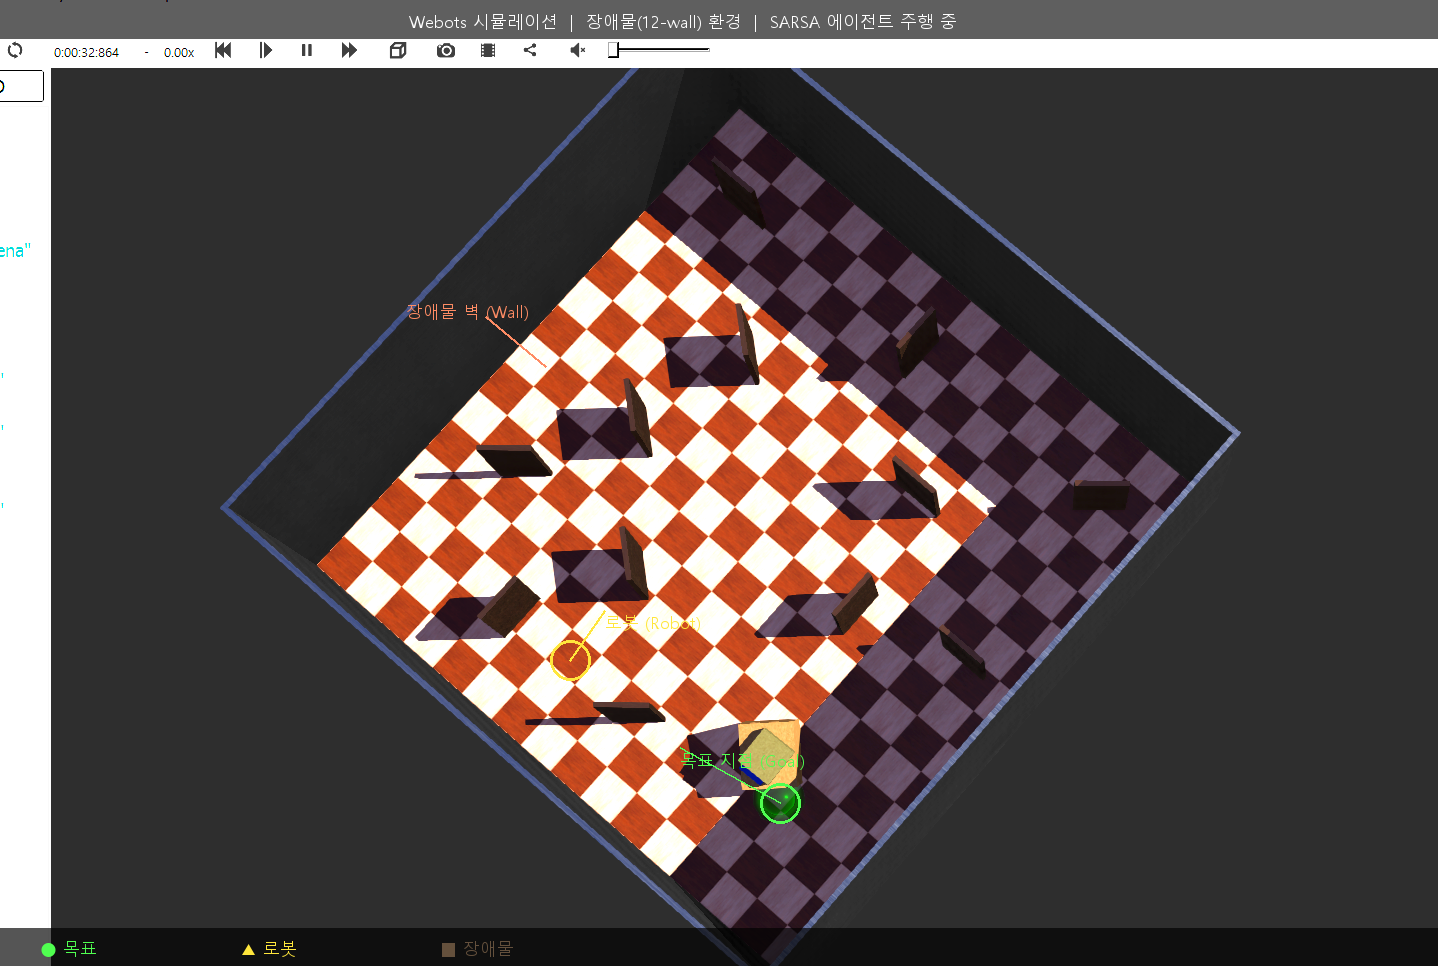
- 課題(Problem): 壁の背後に目標がある場合、距離差分報酬(+0.1 × Δdist)の貪欲な性質により壁を迂回できず正面衝突を繰り返し閉じ込められる**局所解(Local Minima)**が発生。
- 解決策(Solution): 3方向超音波ヘッドスキャン(前方・左・右)状態情報と長期的割引率(γ=0.99)の結合 + PowerShellによる**Webots Headless無人高速パイプライン(
headless_run.ps1)**を構築し、3シード(Seed 0, 1, 2)の並列反復学習を実施。
- 成果(Result): 12壁障害物環境においても平均600エピソード以降に90%以上の安定した到達成功率を達成し、確実な迂回ポリシー(Detour Policy)の獲得を実証。
📌 キーポイント (TL;DR)
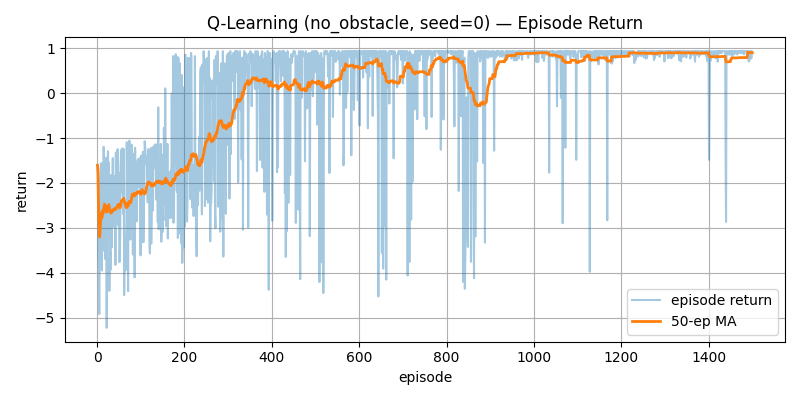
- 課題(Problem): 目標到達(+1.0)と壁衝突(-1.0)のみが与えられるスパース報酬(Sparse Reward)環境では、エージェントが偶然目標に遭遇するまで数千エピソードにわたり彷徨や空転を繰り返す。
- 解決策(Solution): 目標とのユークリッド距離の変化量に比例するポテンシャル報酬(+0.1 × Δdist)と、ステップ(-0.01)、旋回(-0.01)、後退(-0.05)ペナルティを組み合わせた**多次元報酬シェイピング(Reward Shaping)**を設計。指数減衰ε-Greedy(1.0 → 0.05)戦略を適用。
- 成果(Result): 障害物のない環境(
no_obstacle)において500エピソード以内に移動平均報酬が正の値(0.7+)へ到達し、最終的な目標到達成功率98%以上を達成。
📌 キーポイント (TL;DR)
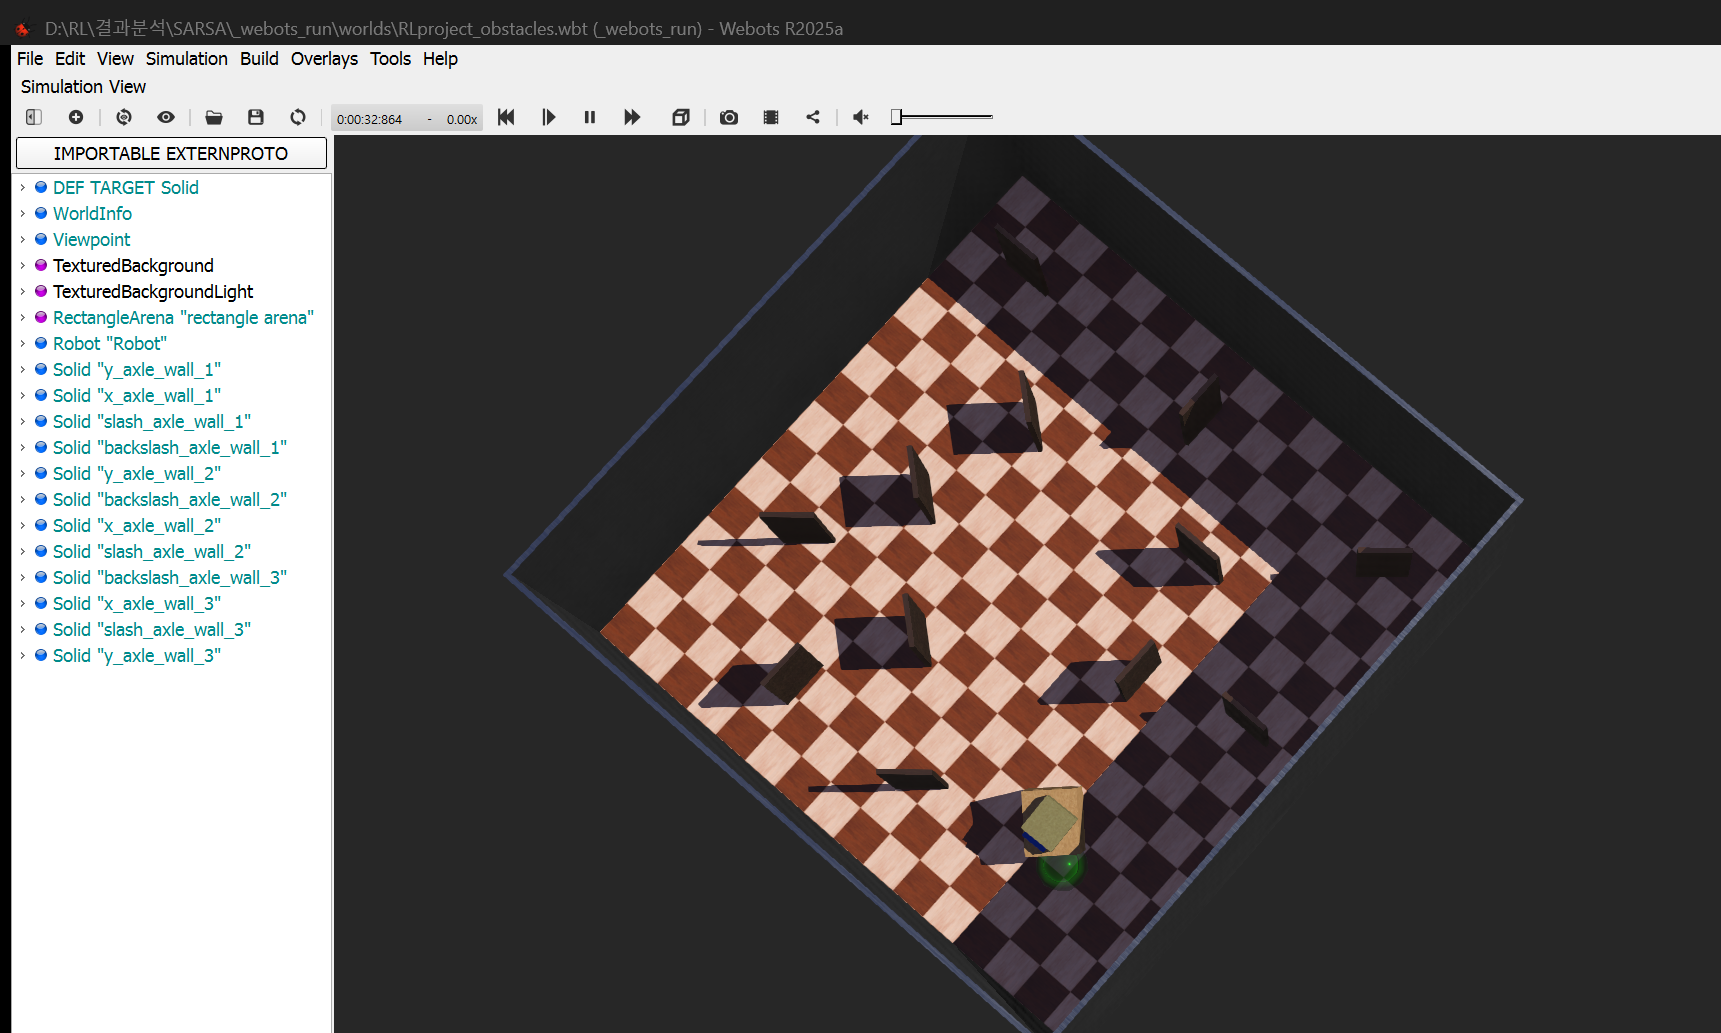
- 課題(Problem): 連続的なセンサ距離・角度値による表形式Q-Learning(Tabular Q-Learning)の状態爆発と、Webotsシミュレータと外部Python学習スクリプト間のリアルタイム同期の負荷。
- 解決策(Solution): 5次元の連続センサ入力を幾何学的な意味を持つ区間に分割し、3 × 8 × 3 × 3 × 3 = 648個の離散状態(Bin)にマッピング(
discretizer.py)。TCPローカルソケット(Port 5000、Line-delimited JSON)によるIPC通信パイプラインを構築。
- 成果(Result): O(1)の超高速Q-Table更新速度を確保し、32ms物理シミュレーションステップに適合した安定同期ループを実現。
