[Stanford CS329A #4] ツール利用とコード実行フィードバック: ReAct、RLEF、そして憲法型自己修正
· 約19分

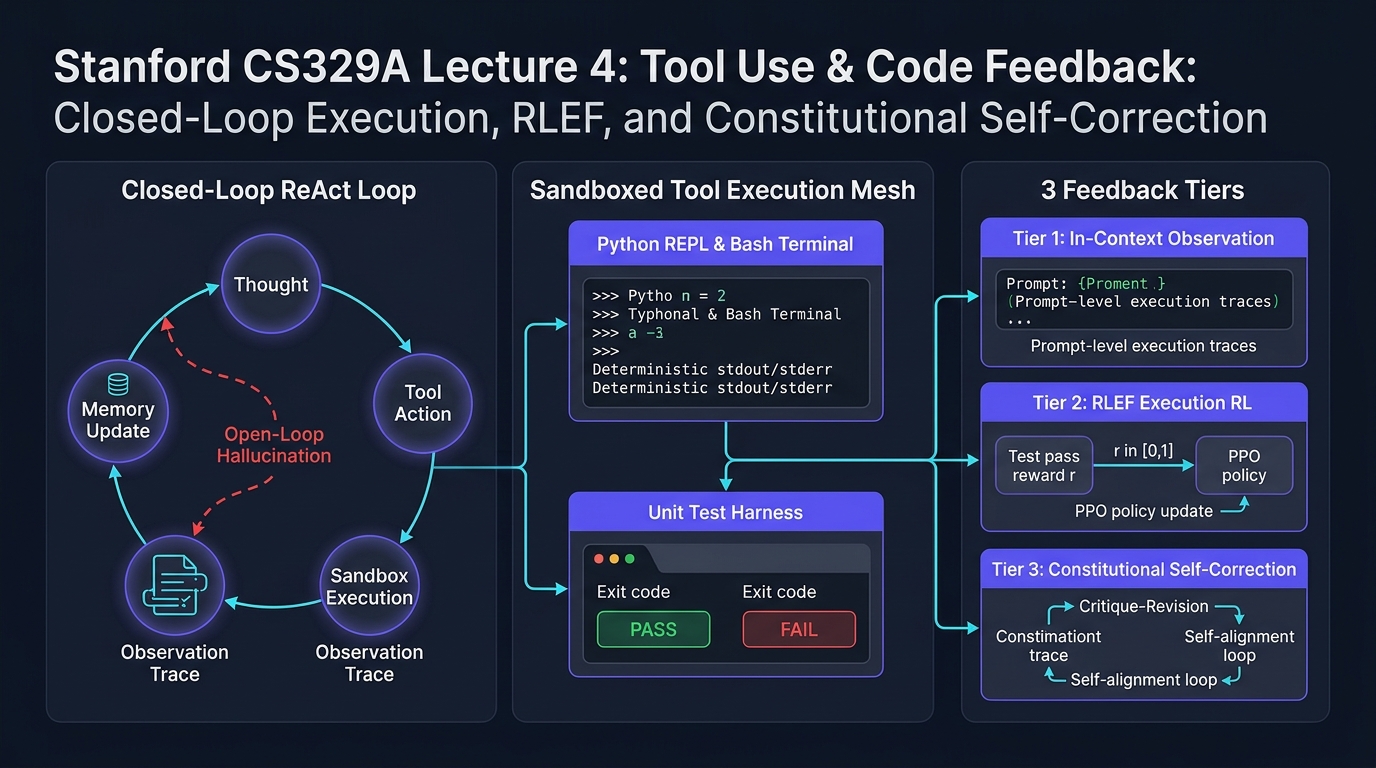
スタンフォード大学の2025年秋学期最新大学院講義、**CS329A: Self-Improving AI Agents(自己進化型AIエージェント)**の第4回エンジニアリング解説へようこそ。
第2講と第3講では、推論時計算量スケーリング(Test-time Compute Scaling)およびプロセス報酬モデル(PRM)を駆使し、言語モデルがいかに推論探索木を展開して中間ステップの正当性を検証するかを学びました。しかし、どれほど洗練された思考連鎖(CoT)を展開できたとしても、純粋なテキスト生成にとどまるモデルは本質的に**「密室に閉じ込められて試験問題を解く受験生」**にすぎません。モデルは事前学習時に脳内に焼き付けられた、静的で凍結されたパラメータメモリ(Parametric Memory)だけに頼っているためです。絶えず変化する外部の事実、動的なWeb API、あるいは厳格なコード実行環境を前にすると、現実世界と切り離されたモデルは不可避的に「もっともらしい幻覚(Hallucination)」を生み出してしまいます。
本日解説する第4講は、モデルをその密室から解き放つ決定的な転換点です。テーマは**「ツール利用(Tool Use)と実行フィードバックループ(Feedback Loops)」**です。
自律型エージェントは、コードやAPI呼び出しを単なる出力テキストとして扱うのではなく、外部環境と相互作用するための**「センサーおよびアクチュエータ」**として活用します。本講義では、静的な言語モデルをクローズドループ型自律エージェントへと昇華させる3つの主要フィードバック層を詳細に解体・再構築します:
- プロンプト層の環境フィードバック(In-Context): 思考と行動を有機的に結合する ReAct(Yao et al., 2022)
- ポリシー層の実行フィードバック(Policy-Level): コンパイラやテストスイートの診断結果をニューラルネットワークの重みに直接焼き付ける RLEF(Reinforcement Learning from Execution Feedback, 2024)
- 自己教師あり価値アライメント(Self-Supervision): 高コストな人間のアノテーションを自然言語の憲法原則による批評・修正ループで置き換える Constitutional AI(Anthropic, 2022)
flowchart TD
    subgraph ClosedLoop ["クローズドループ型エージェントアーキテクチャ (Closed-Loop)"]
        direction TB
        Agent["自律エージェントコア (LLM Policy)"]
        Thought["内部言語思考 (Thought Space L)"]
        Action["実行可能なツール呼び出し (Action Space A)"]
        Sandbox["隔離実行サンドボックス (Python REPL / Shell / Search)"]
        Obs["決定論的環境観測結果 (Stdout / Stderr)"]

        Agent --> Thought
        Thought --> Action
        Action --> Sandbox
        Sandbox --> Obs
        Obs -->|"フィードバックによるコンテキスト更新 (c_{t+1})"| Agent
    end

    subgraph FeedbackTiers ["エージェントフィードバックの3大進化レイヤー"]
        direction TB
        T1["レイヤー1: インコンテキスト環境フィードバック (ReAct)<br/>• 思考と行動の交差ループ: Thought + Action + Observation<br/>• 知識検索タスクにおける事実捏造幻覚率 0% を達成"]
        --> T2["レイヤー2: ポリシーレベル実行フィードバック (RLEF)<br/>• MDP定式化: State, Action, Sandbox Reward<br/>• 公開/非公開テスト分離によるPPO最適化<br/>• Llama-3.1-70B: CodeContests 1@3 正答率が27.5%から40.1%へ急上昇"]
        --> T3["レイヤー3: 自律的価値自己修正 (Constitutional AI)<br/>• 自然言語原則(憲法)に基づく批評・修正SFTデータ構築<br/>• AIフィードバック強化学習(RLAIF)による選好報酬モデル学習<br/>• 人間ラベリングのスケーラビリティボトルネックを解消"]
    end

    ClosedLoop ==> FeedbackTiers