[Stanford CS329A #3] 堅牢な回答検証: プロセス報酬モデル(PRM)、アンサンブル、そしてスケーラブルな監視

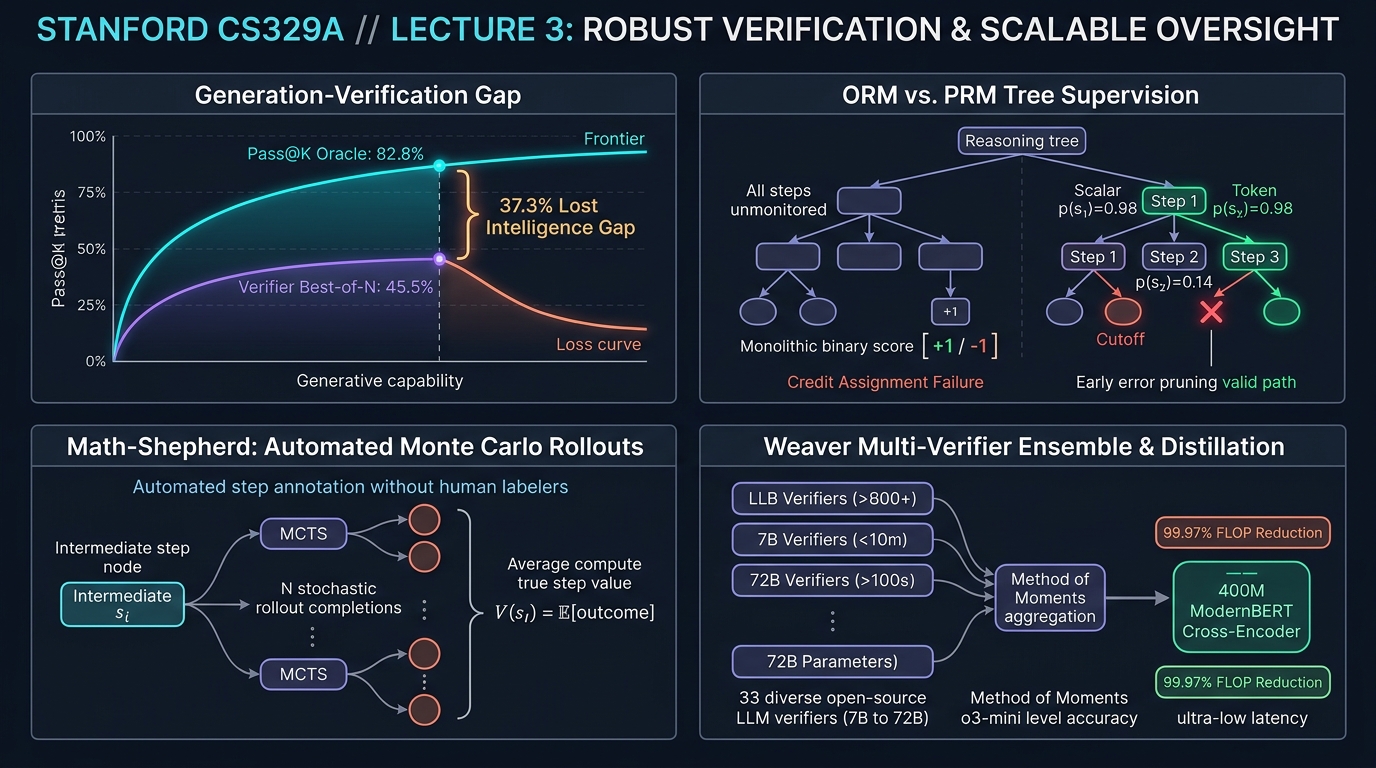
スタンフォード大学の2025年秋学期・最新大学院講座、**CS329A: Self-Improving AI Agents(自己改善AIエージェント)**の第3回エンジニアリング解説へようこそ。
前回の第2講で、私たちは推論時計算量スケーリング(Test-time Compute Scaling)を学び、極めて示唆に富む結論に達しました。モデルに数千の候補回答($pass@k$)を生成させれば、正解の網羅率(カバーレッジ)は99%を超えます。しかし、**「無数の誤答の中から真の正解を選び抜く高精度な検証器(Verifier)がなければ、多数決投票(Majority Voting)を行っても性能は完全に頭打ち(Plateau)になる」**という現実でした。
第3講では、この本質的なボトルネックを打ち破る中核システム技術、**堅牢な回答検証(Robust Verification)**を徹底解明します。
人間の数学者やソフトウェアエンジニアであっても、複雑な問題を解く際に一直線の思考だけで正解に至ることは稀です。1行の論理を展開し、数式の整合性を確かめ、微小な符号の誤りを見つければ直ちに前のステップへと戻り(バックトラッキング)、修正を重ねます。これに対し、従来の自己回帰(Autoregressive)言語モデルは未来方向へとのみトークンを生成します。初期の推論でわずかな論理破綻が生じると、モデルは自らの誤りを正当化するために、さらに複雑なハルシネーション(幻覚)を連鎖させてしまいます。
では、「モデルが生成した中間推論ステップを、別のモデルが1歩ずつ厳格に検査し、誤った思考枝を早期に刈り取る(Pruning)ことはできないか?」
OpenAIの金字塔であるCobbeのGSM8K検証器から、Lightmanによるステップ単位の過程監視(PRM800K)、人間のアノテーションなしにモンテカルロ・ロールアウトで自己採点するMath-Shepherd、そして複数の弱検証器を統計学的に統合してo3-mini級の精度を引き出す最新のWeaver(NeurIPS 2025)まで、検証器エンジニアリング(Verifier Engineering)の極致を体系的にマスターしていきましょう。
flowchart TD
    subgraph Gap ["核心的課題: 生成-検証ギャップ (Generation-Verification Gap)"]
        direction TB
        G1["Pass@100 オラクル上限: 82.8% (理論的潜在力)"]
        G2["多数決投票の実際の成功率: 45.5% (実際の抽出性能)"]
        G1 -.->|"選別失敗により失われる 37.3%p の知能"| G2
    end

    subgraph Solutions ["回答検証システムの4段階の進化"]
        direction TB
        S1["結果報酬モデル (ORM)<br/>• 最終回答のみに二値スコア(+1 / -1)を付与<br/>• 信用割当の破綻 (Credit Assignment Failure)"]
        --> S2["プロセス報酬モデル (PRM800K)<br/>• トークンレベルのステップ監視 p(step_i)<br/>• 初期の誤り検知による早期枝刈りと確率積評価"]
        --> S3["Math-Shepherd (教師なしMCTSロールアウト)<br/>• 人手アノテーション不要の自動モンテカルロ採点<br/>• 人手によるPRM800Kを上回るベンチマークスコア達成"]
        --> S4["Weaver 弱検証器アンサンブル<br/>• モーメント法(Method of Moments)に基づく教師なし統合 (33検証器)<br/>• 400M ModernBERT クロスエンコーダ蒸留 (計算量 99.97% 削減)"]
    end

    Gap ==> Solutions