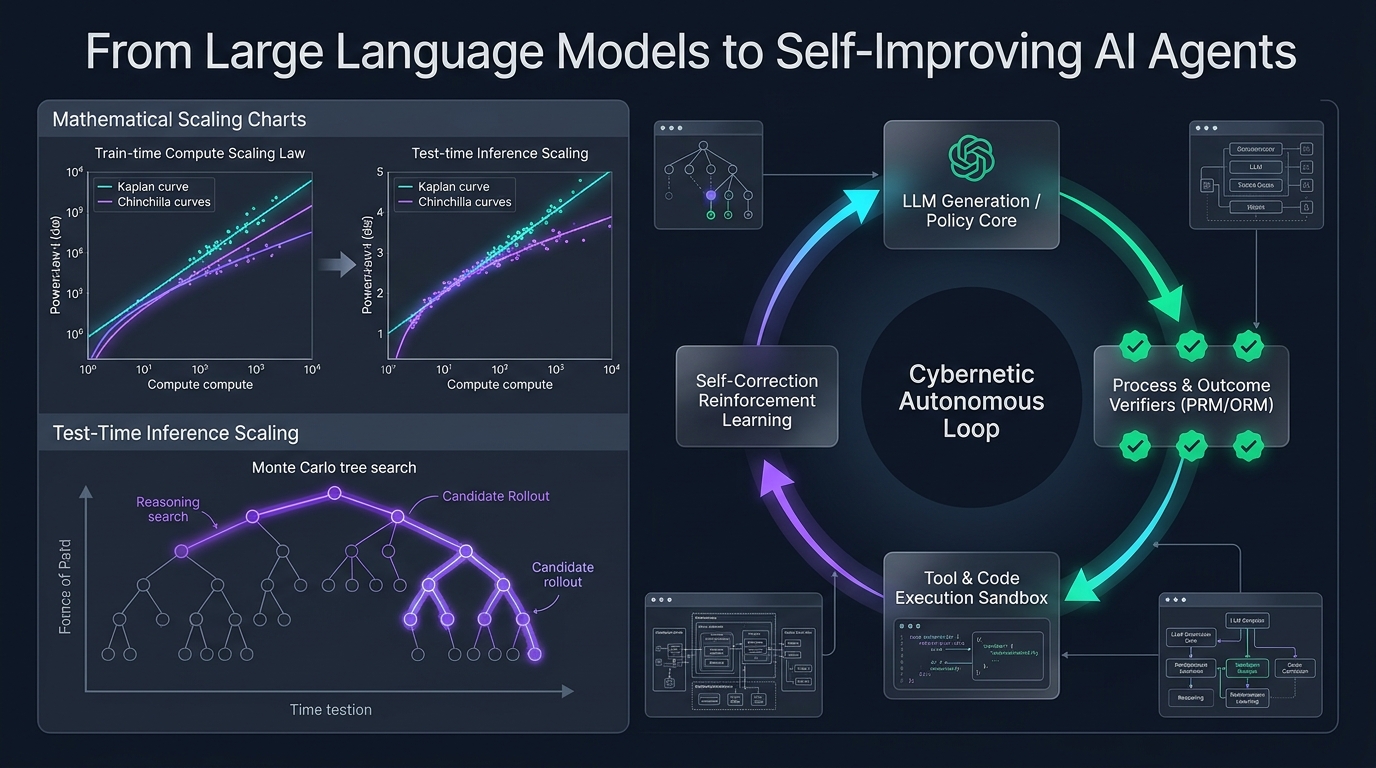
[Stanford CS329A #2] 推論時計算量スケーリング: 事前学習のスケーリング則を超えて計算最適推論へ
· 約16分

スタンフォード大学の2025年秋学期・最新大学院講座、**CS329A: Self-Improving AI Agents(自己改善AIエージェント)**の第2回エンジニアリング解説へようこそ。
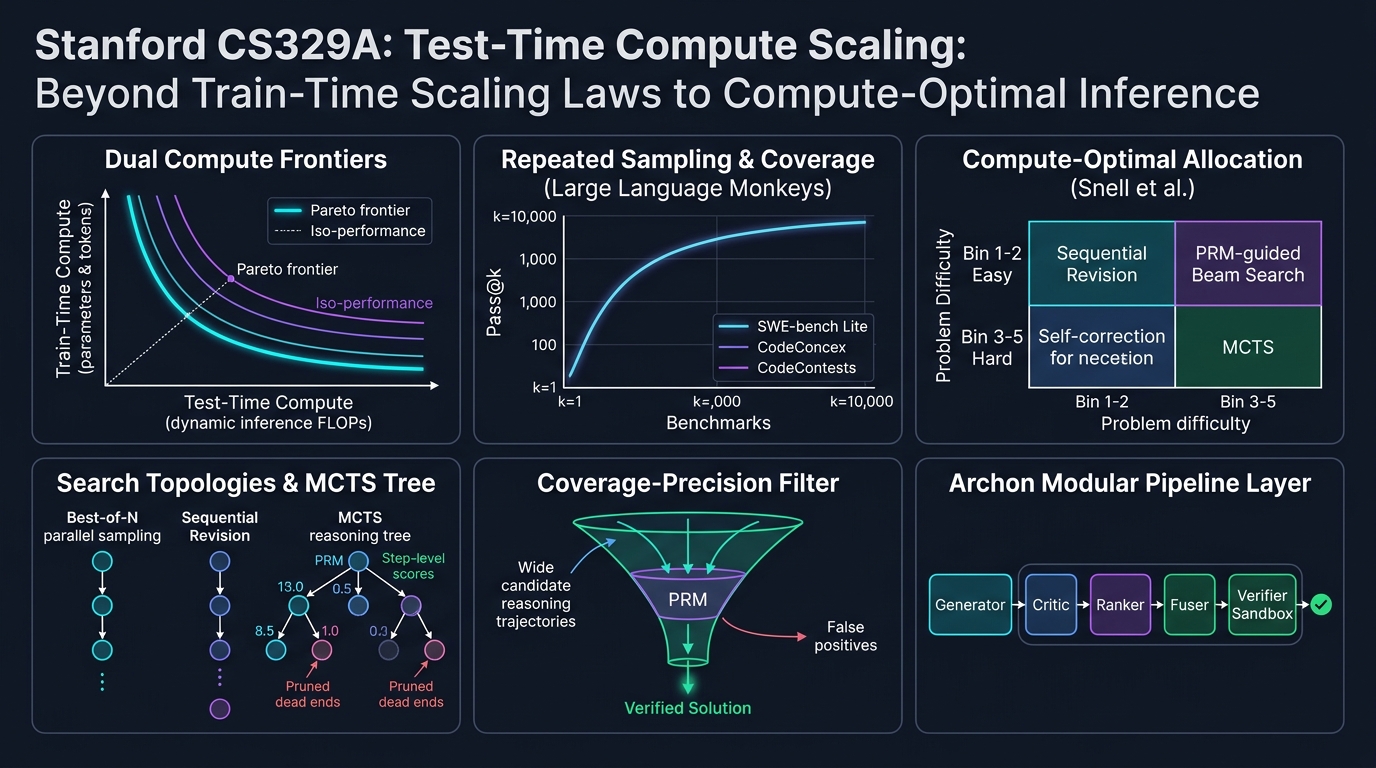
第1講では、静的な次トークン予測器としてのLLMが、環境とフィードバックループを回す自律型エージェントへと変貌するパラダイムシフトを概括しました。本日扱う第2講のテーマは、この自律的な自己改善を支える最も本質的な計算基盤、すなわち**推론時計算量スケーリング(Test-Time Compute Scaling / Inference-Time Scaling)**です。
過去5年以上にわたり、AI業界を支配してきた唯一の教義は事前学習(Pre-training)のスケーリング則(Kaplanら、Chinchilla)でした。「GPUクラスタを巨大化し、パラメータ数Nを数千億に増やし、数十兆トークンのウェブデータを学習させる」。しかし、学習が完了し重みθが固定(Frozen)されたモデルに対し、0.05秒で貪欲(Greedy)に答えさせる代わりに、10秒、1分、あるいは10分間深く思考させ、中間推論を検証し、仮説を自己修正させながら推論計算量(FLOPs)を投入したら何が起きるでしょうか?
Large Language Monkeys(Brownら、2024)、スタンフォード・バークレーのCharlie Snell研究チームによるCompute-Optimal Scaling(Snellら、2024)、そしてArchonモジュール型アーキテクチャフレームワークを通じて、**「推論計算量を投資してパラメータ容量を凌駕する現代AIの最適化法則」**を数理的・工学的に解き明かします。
flowchart TD
    subgraph PreTrain ["古典的フロンティア: 事前学習計算量のスケーリング"]
        direction TB
        P1["数兆トークンの公開ウェブデータ (D)"] --> P2["大規模GPUクラスタによる事前学習 (C_train)"]
        P2 --> P3["固定された高密度モデル重み (θ)"]
        P3 --> P4["単一フォワードパス推論 (O(1) 固定計算量)"]
    end

    subgraph TestTime ["CS329Aフロンティア: 推論時計算量スケーリング"]
        direction TB
        T1["固定された基底重み (θ)"] --> T2["動的な推論FLOPsの可変投入"]
        T2 --> T3{"問題の難易度適応型戦略の選択"}
        T3 -- "低難易度 (Bin 1-2)" --> T4["逐次修正 (Sequential Revision: 自己修正)"]
        T3 -- "高難易度 (Bin 3-5)" --> T5["PRM誘導ツリー探索 (MCTS / ビームサーチ)"]
        T4 --> T6["プロセス報酬モデル (PRM) 検証器"]
        T5 --> T6
        T6 --> T7["数学的・機械的に検証された最終正解の抽出"]
    end

    PreTrain -.->|"変曲点: パラメータスケーリングの飽和"| TestTime