[Webots ロボティクス] 表形式Q-Learningの実装と報酬関数(Reward Shaping)の最適化 (#2)
· 約3分

📌 キーポイント (TL;DR)
- 課題(Problem): 目標到達(+1.0)と壁衝突(-1.0)のみが与えられるスパース報酬(Sparse Reward)環境では、エージェントが偶然目標に遭遇するまで数千エピソードにわたり彷徨や空転を繰り返す。
- 解決策(Solution): 目標とのユークリッド距離の変化量に比例するポテンシャル報酬(+0.1 × Δdist)と、ステップ(-0.01)、旋回(-0.01)、後退(-0.05)ペナルティを組み合わせた**多次元報酬シェイピング(Reward Shaping)**を設計。指数減衰ε-Greedy(1.0 → 0.05)戦略を適用。
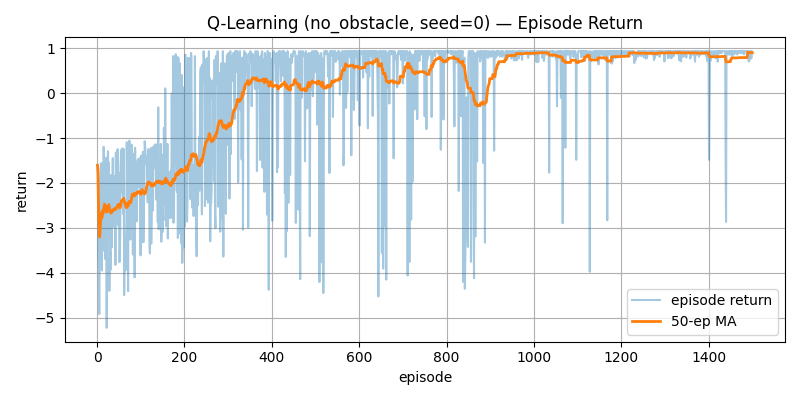
- 成果(Result): 障害物のない環境(
no_obstacle)において500エピソード以内に移動平均報酬が正の値(0.7+)へ到達し、最終的な目標到達成功率98%以上を達成。