[マウムジギ 開発日誌 #23] Safety Wrapper導入と1学期最終発表
· 約2分

6月に入り、マウムジギチームは1学期の主要な開発をすべて終え、安全網の構築と最終発表の準備に総力を傾けました。
6月に入り、マウムジギチームは1学期の主要な開発をすべて終え、安全網の構築と最終発表の準備に総力を傾けました。
5月の最終週(27日〜30日)、私たちは待望の**4次ファインチューニング(fine_tuning_4)**の結果をまとめ、システムの骨格を固める作業に邁進しました。
5月21日と22日、マウムジギチームは大規模データの生成と**4次ファインチューニング(fine_tuning_4)**の準備に突入しました。
5月19日と20日の2日間は、3次ファインチューニング(fine_tuning_3)の評価自動化とともに、実際のアプリ(App)サービス構築のためのバックエンド/フロントエンド機能の高度化作業が並行して進められました。
以前「5月13日がマウムジギ5月開発の最後になるだろう」と勘違いしていたことを訂正します!5月17日、ものすごい量のバックエンド連携テストとレポート作成作業が押し寄せました。
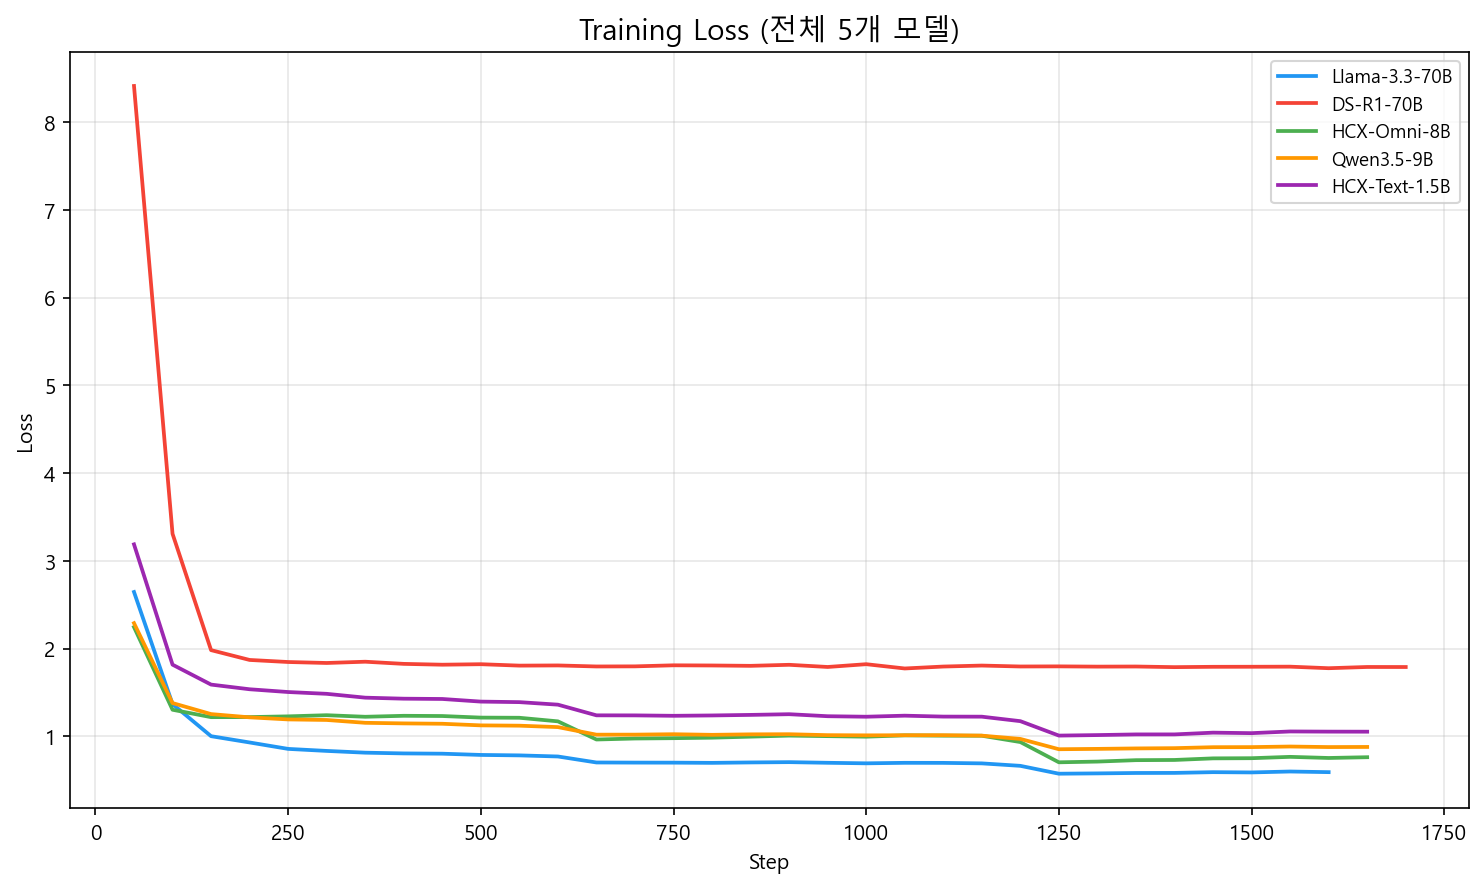
昨日発見したハードコーディングのバグをすべて修正し、ついにまともな2次ファインチューニングモデルの推論(Inference)テストを再開した5月13日です。
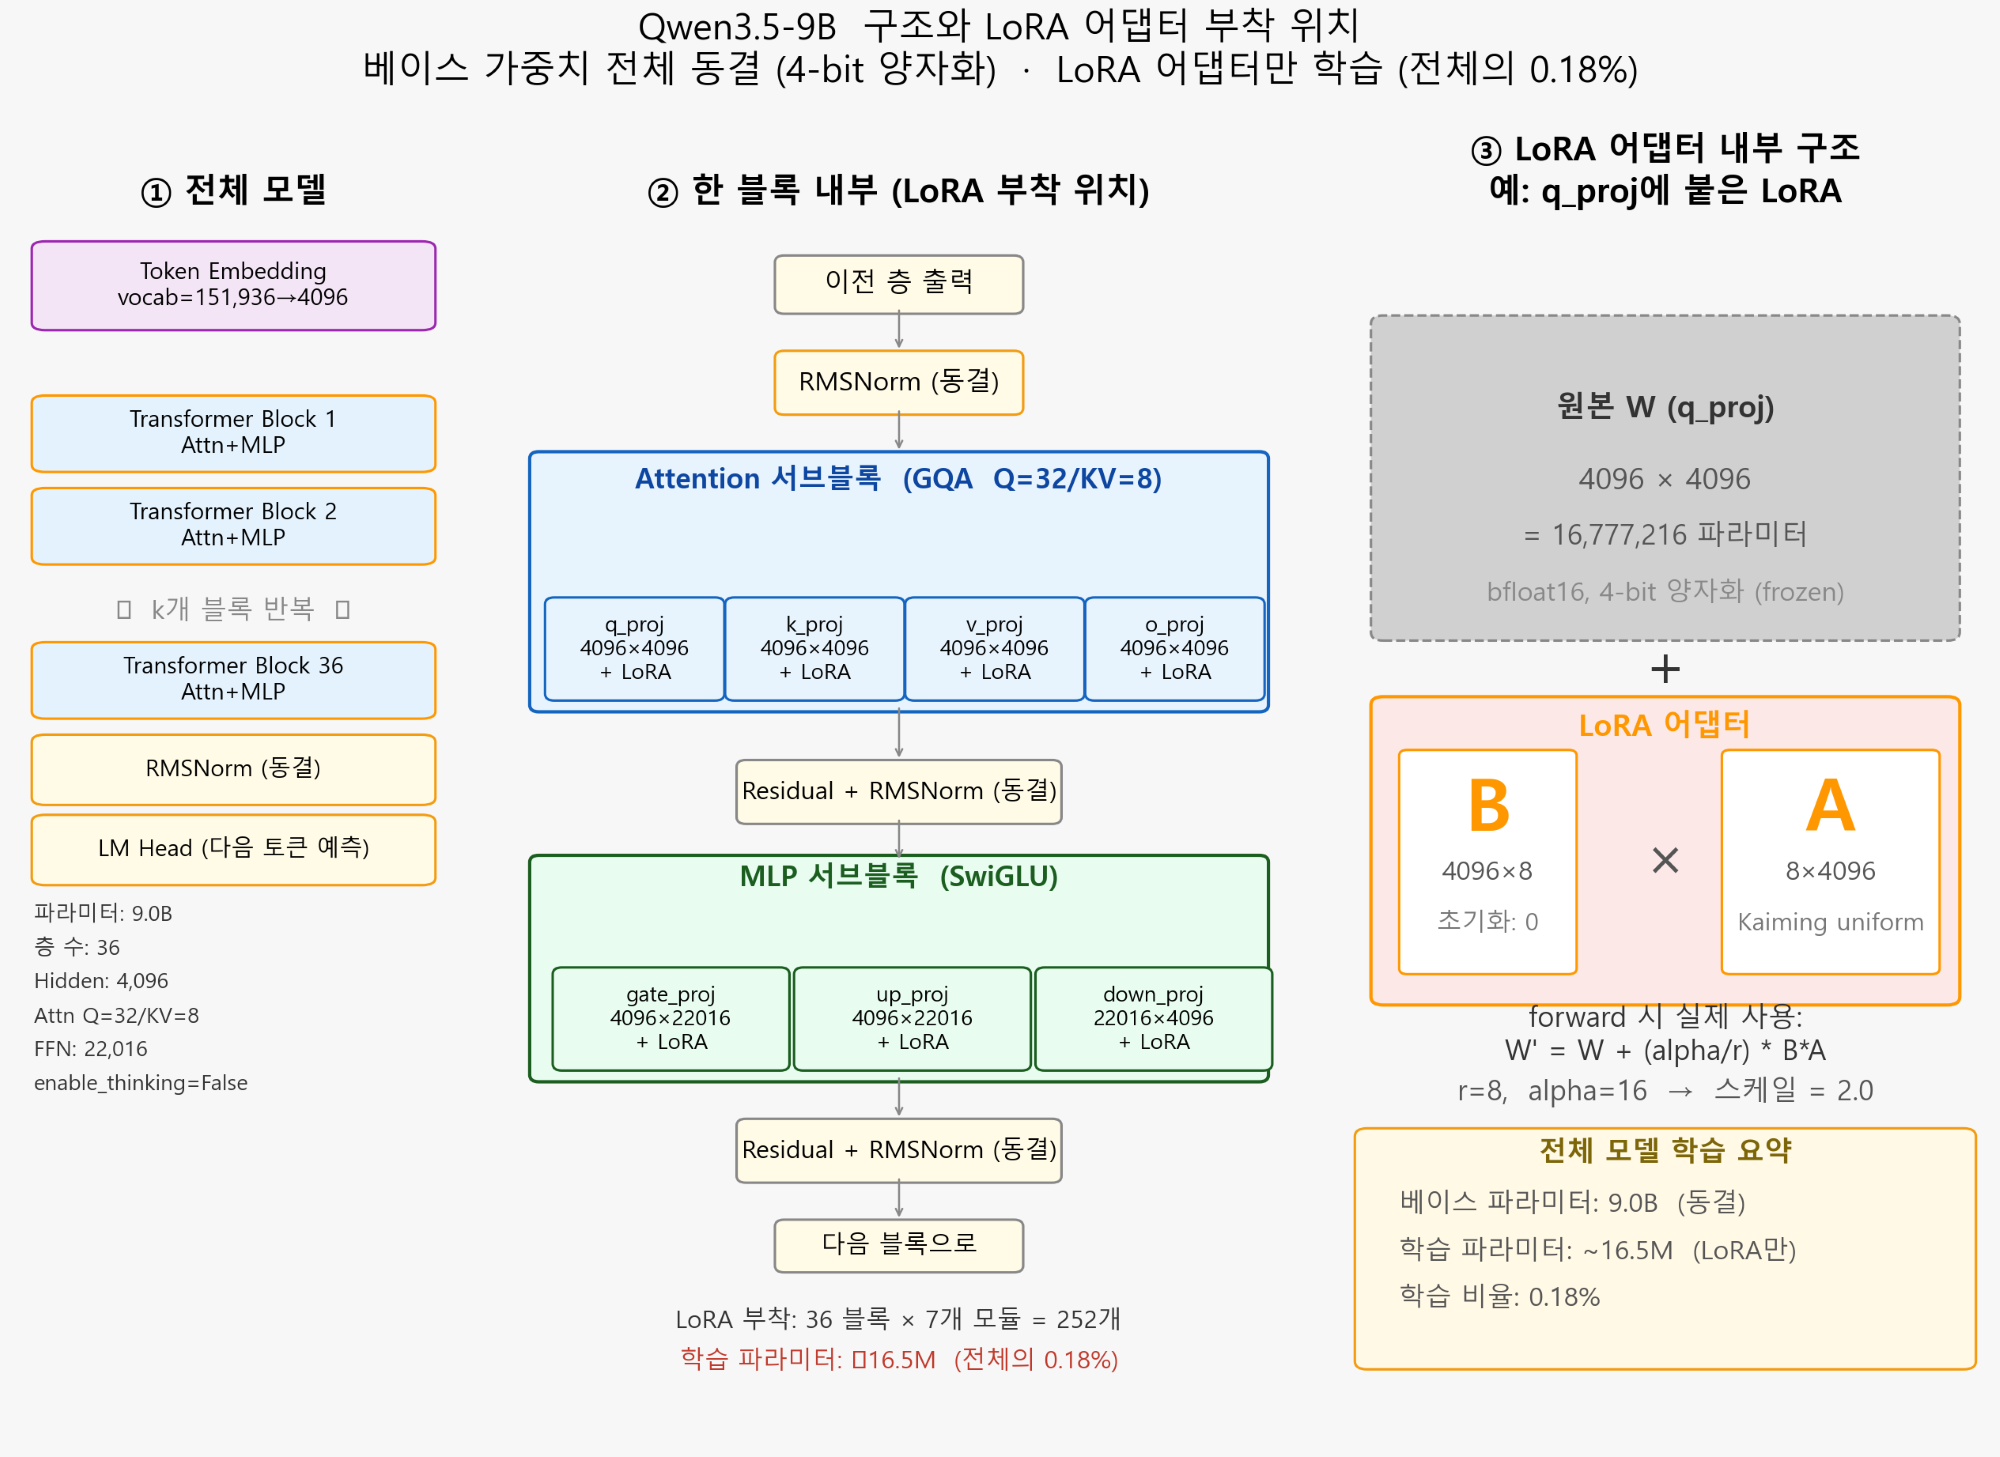
LoRAハイパーパラメータのミス(alpha/rank設定エラー)を正すために野心的に始めた2次ファインチューニング(fine_tuning_2)並列学習が、5月12日ついに終わりました!
5月8日は、これまで抽出したファインチューニングの結果を基にキャップストーンデザインの中間発表資料(PPT)を作成していた日でした。しかし、気分良くスライドを埋めていたところ、背筋が凍るようなとんでもないミスを発見してしまいました。
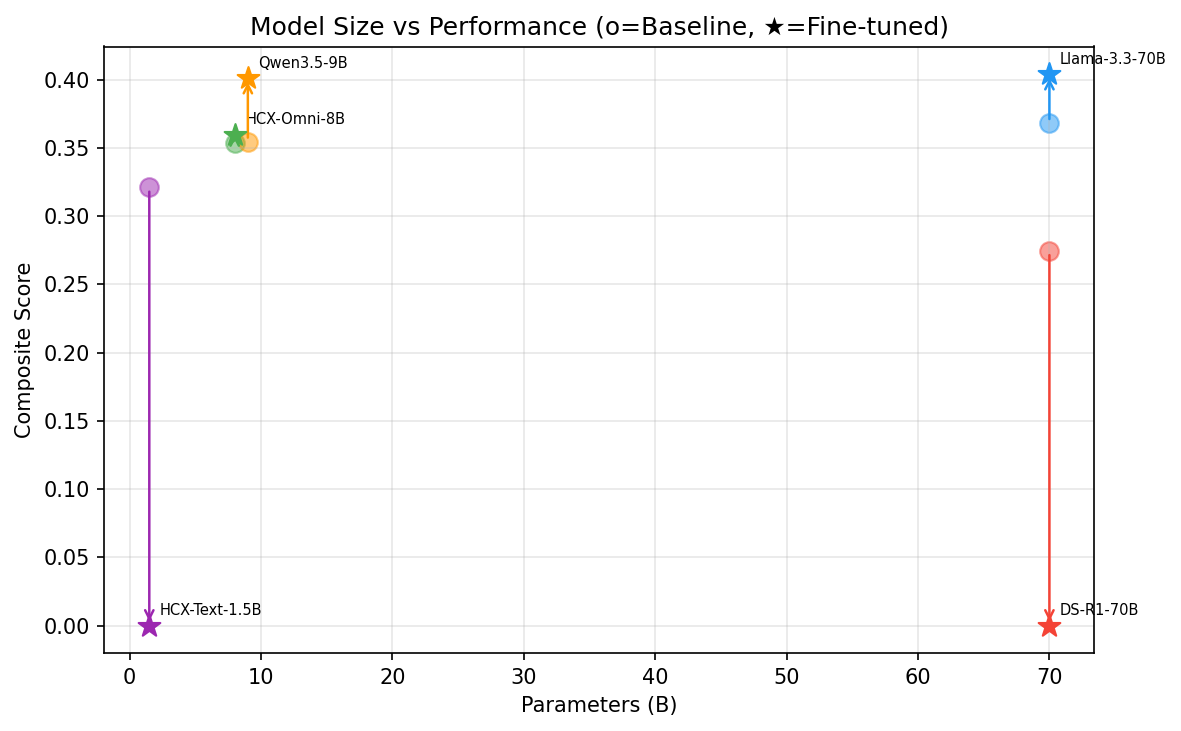
5月7日は、これまで苦労してファインチューニングした計5つのモデル(Llama3.3-70B, DSR1-70B, HCX-Omni-8B, Qwen35-9B, HCX-Text-1.5B)の結果を集大成し、本格的な視覚化とローカル環境の構築を進めた日です。
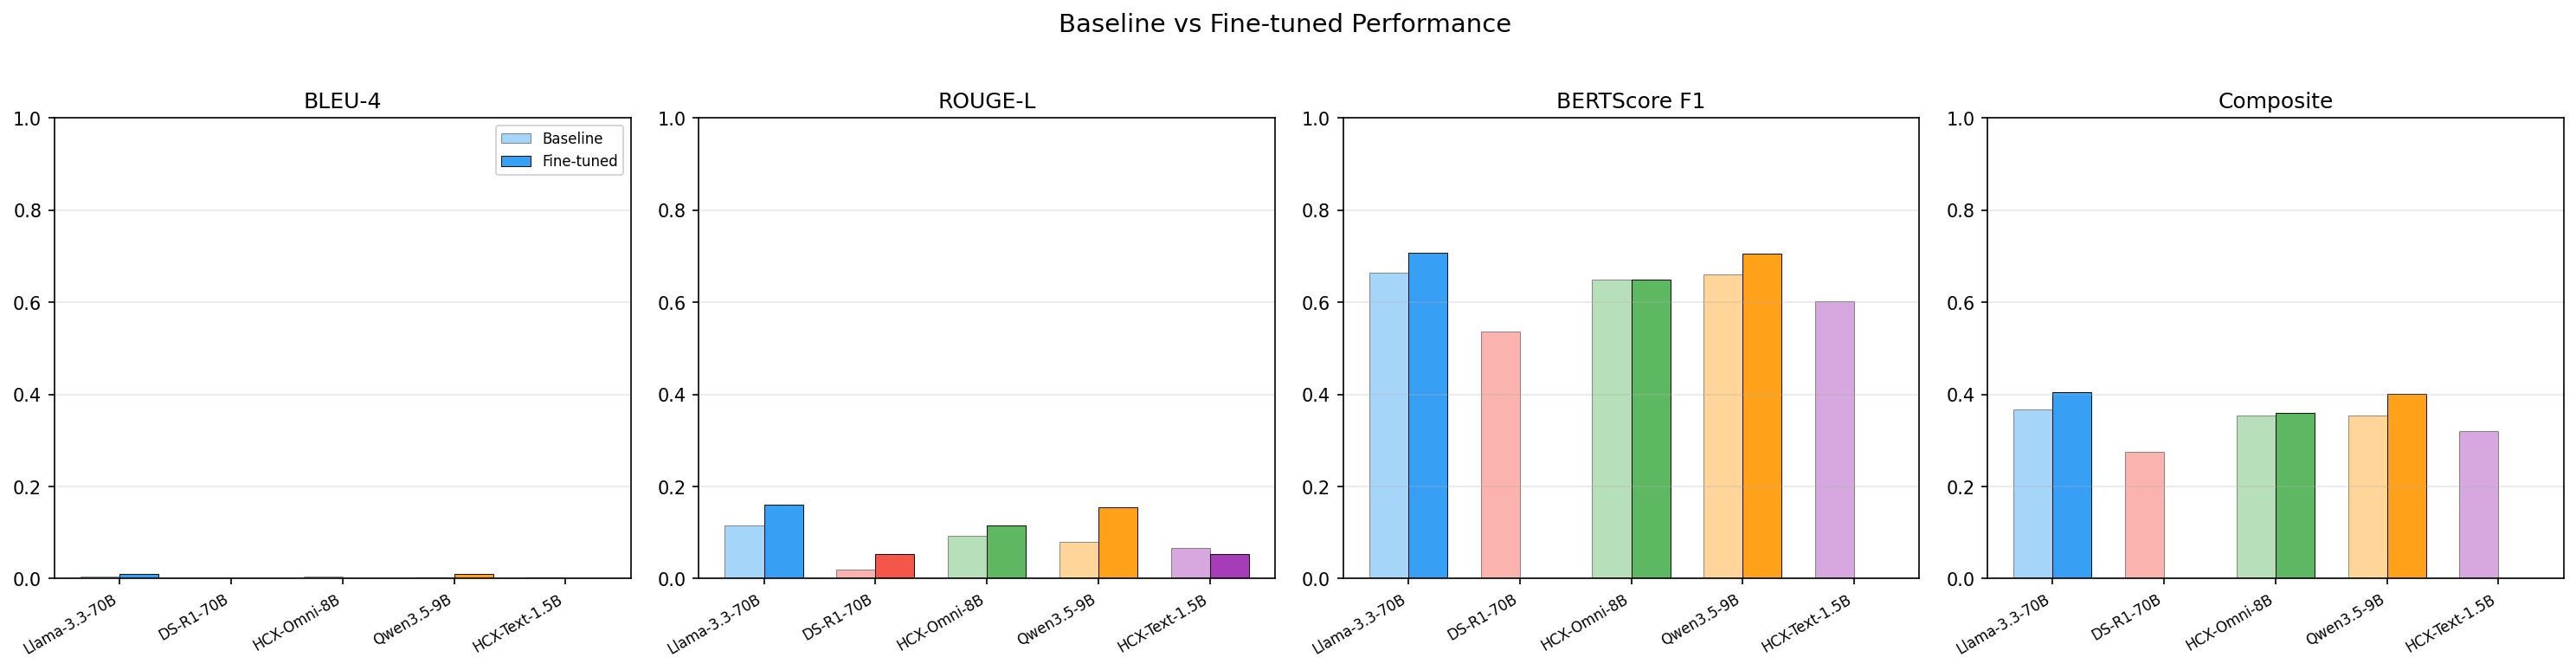
5月6日、ついに長く続いたファインチューニングの沼から抜け出しました!数日間の徹夜作業とハイパーパラメータの調整の末、HCX-Omni-8BやQwen35-9Bなどの中小型モデルの学習が成功裏に完了しました。
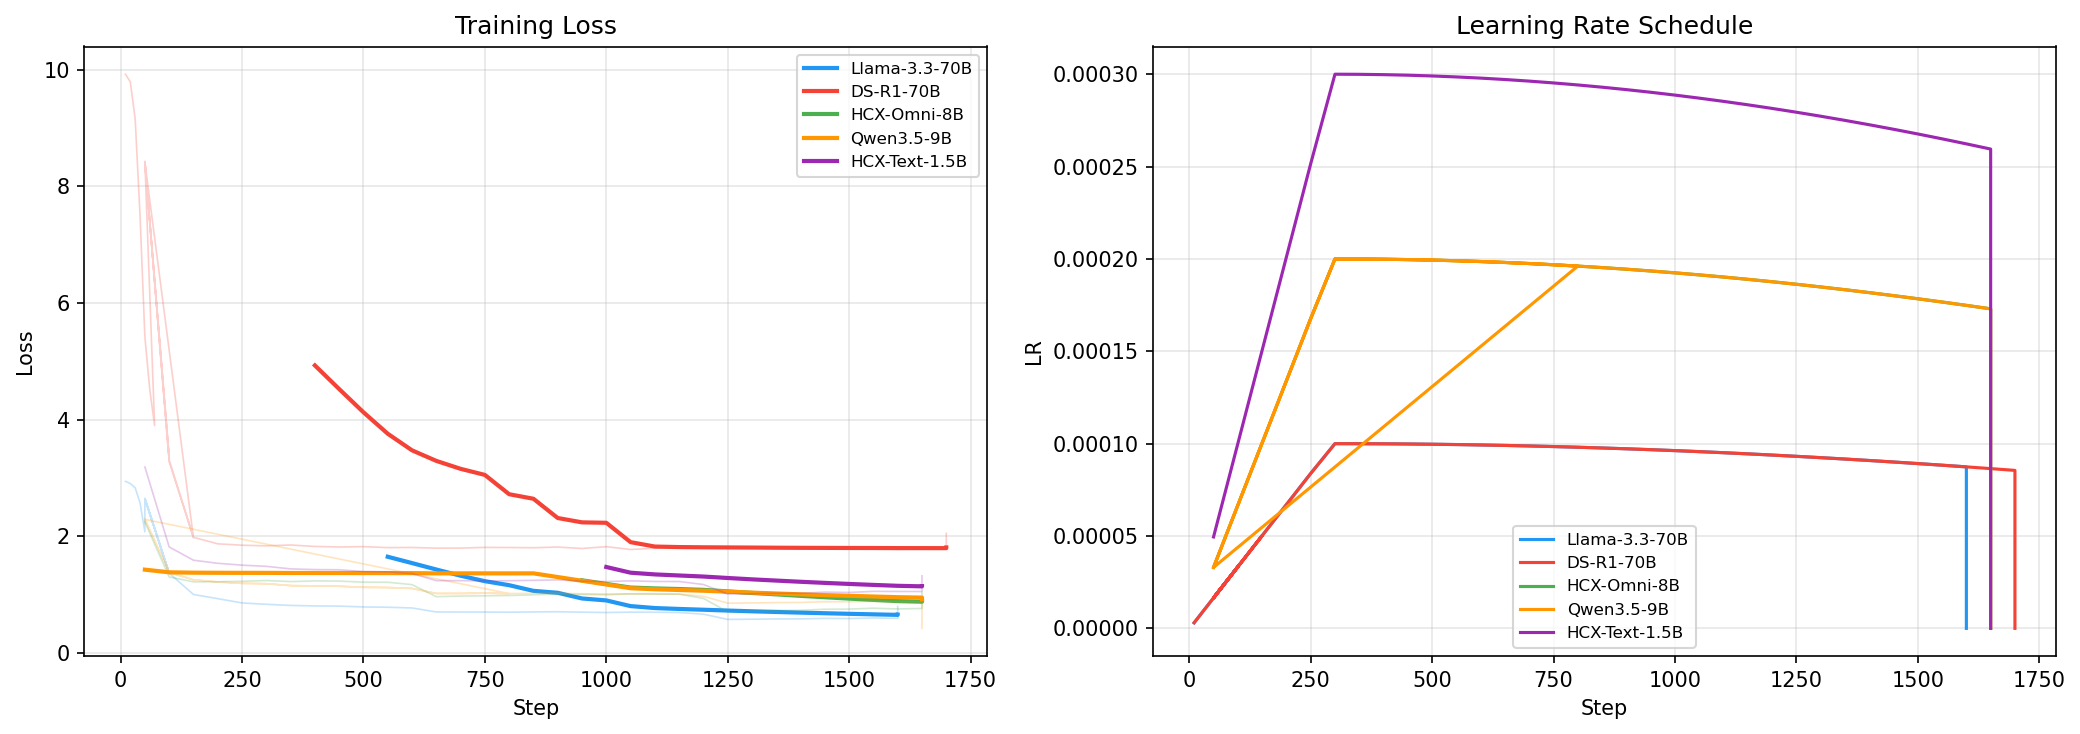
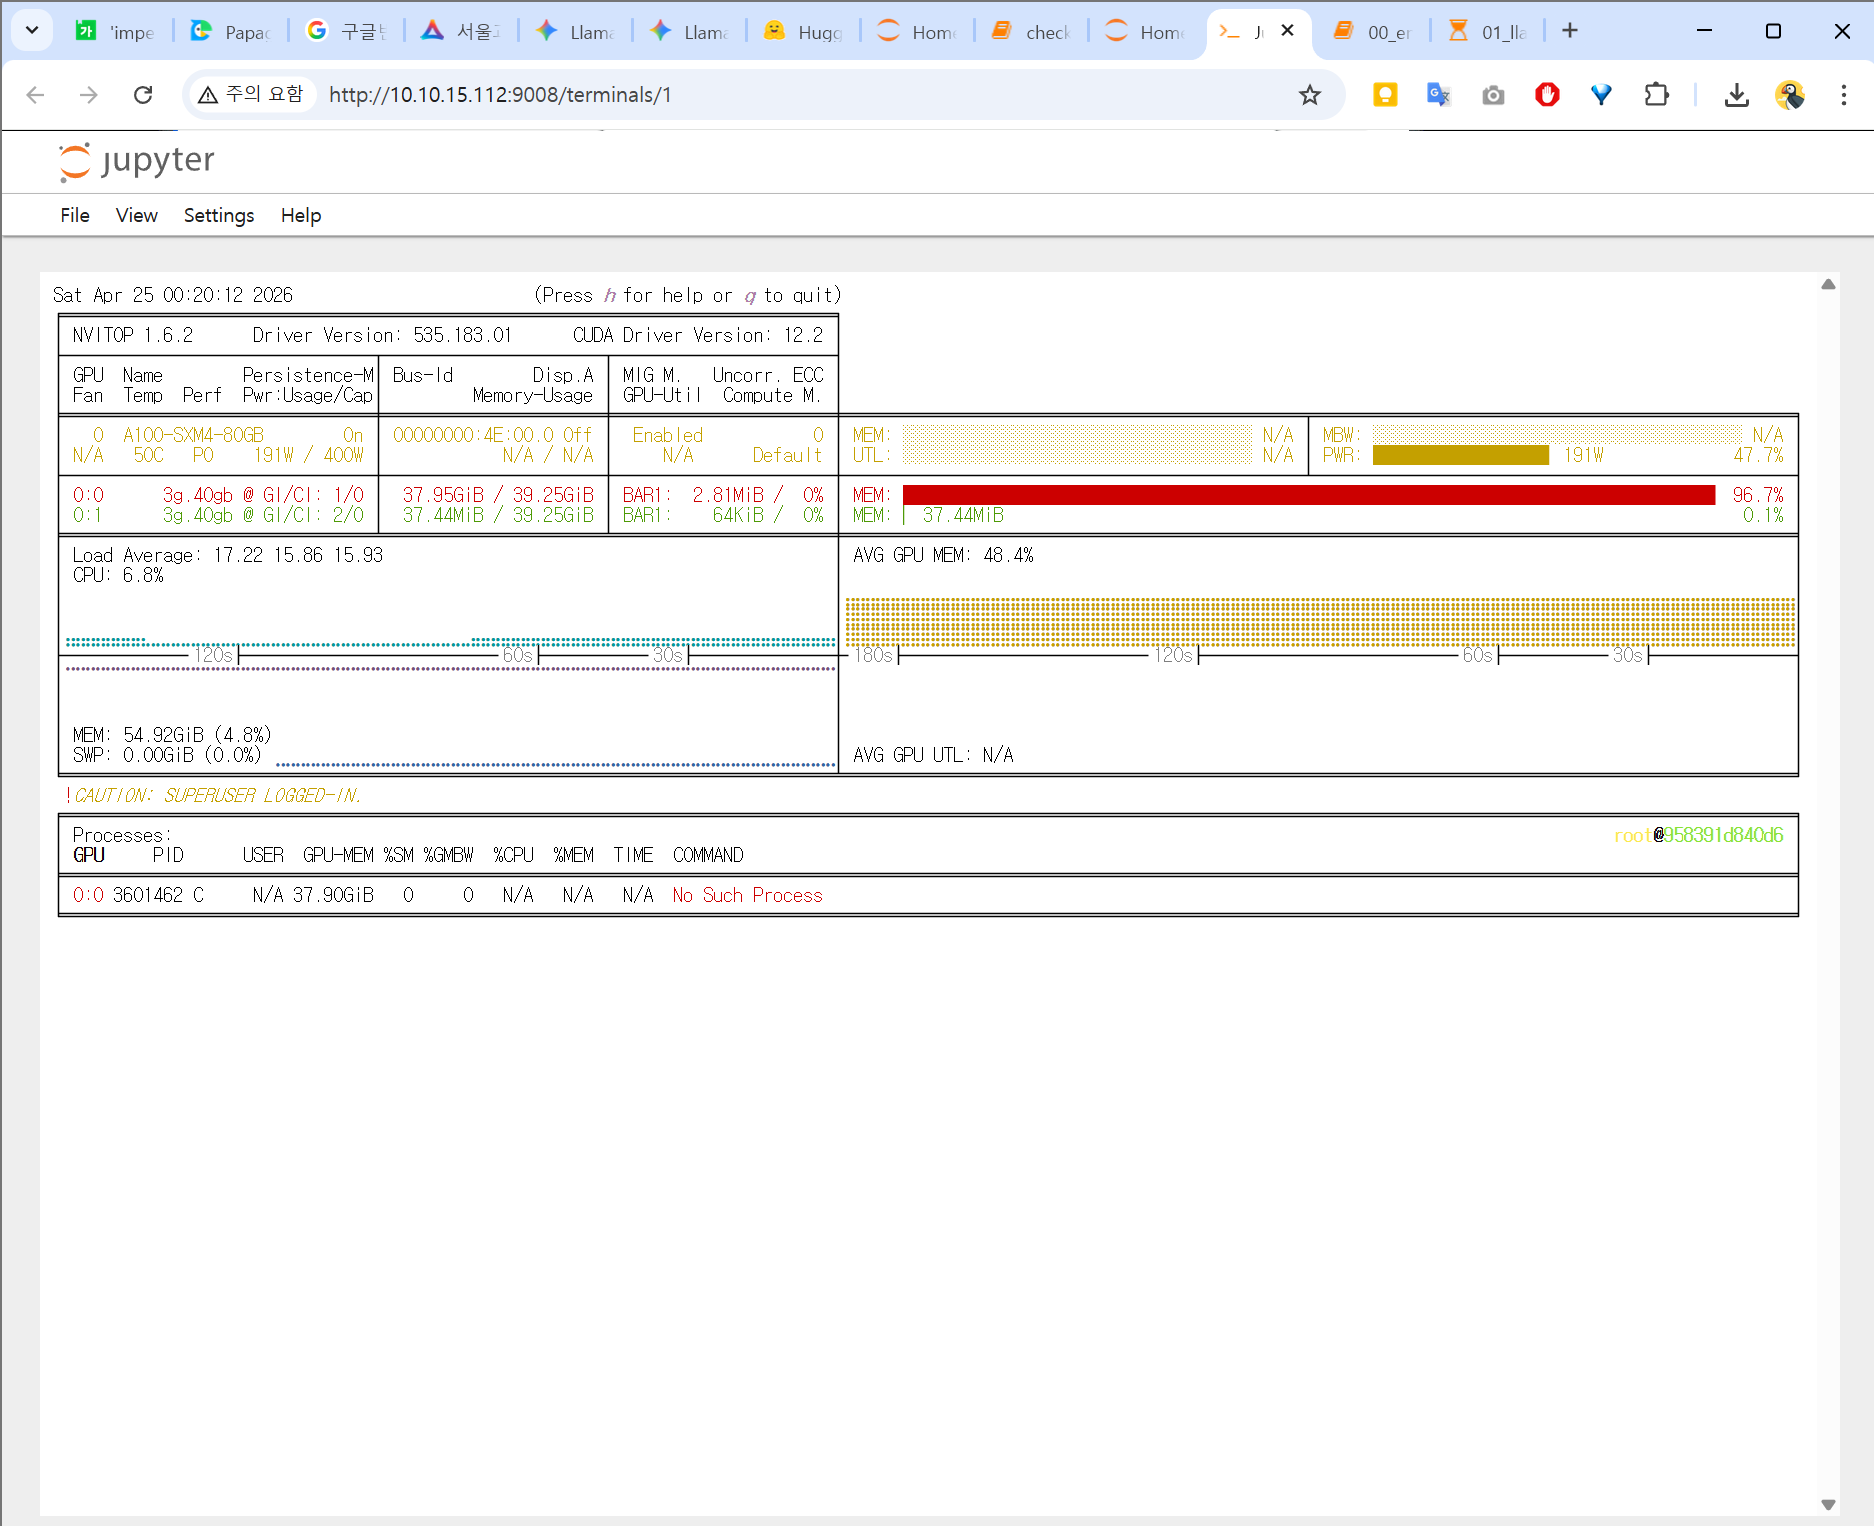
70Bという巨大なモデルのファインチューニング過程で発生したOOM(メモリ不足)の地獄を経験した5月4日、私たちは思い切った戦略変更を試みました。70Bモデル(Llama3.3, DeepSeek-R1)はバッチサイズを極端に減らして辛うじてcheckpoint-1200, 1300まで進めましたが、学習時間がかかりすぎて効率が最悪でした。
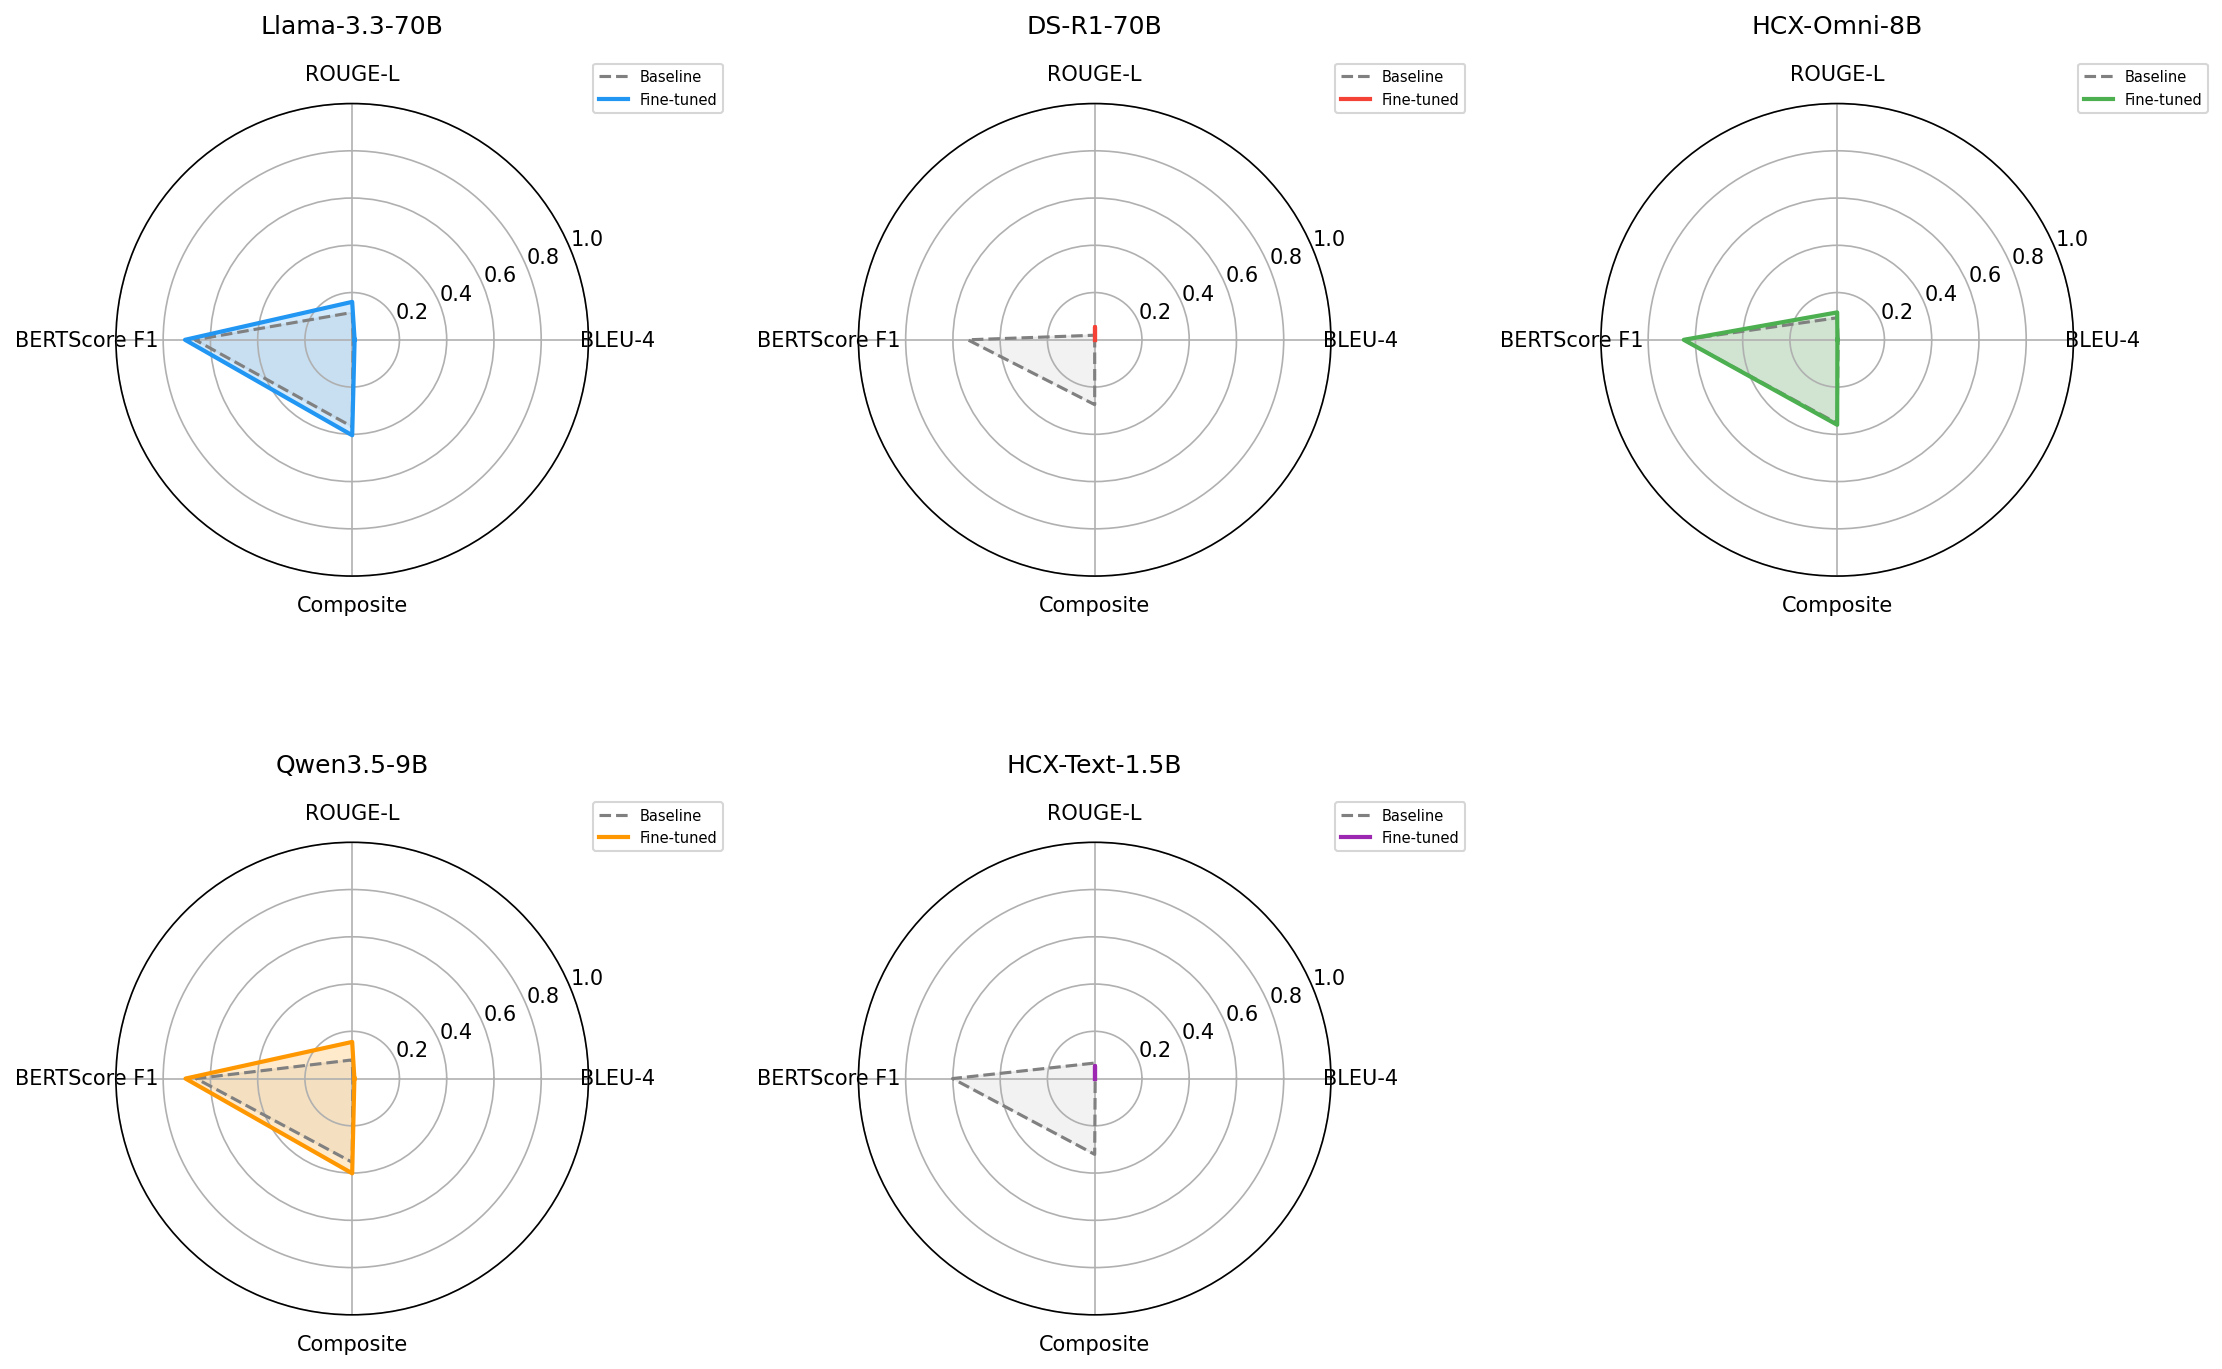
5月3日、これまで8Bモデルで十分に感覚を掴んだ私たちのチームは、ついに真のパフォーマンスの王様、**70B(700億パラメータ)**超大型モデルのファインチューニングに挑戦しました。Llama 3.3 70BとDeepSeek-R1 70Bの2つのモデルを対象に学習を試みましたが、予想通り膨大なハードウェアリソースの壁にぶつかってしまいました。
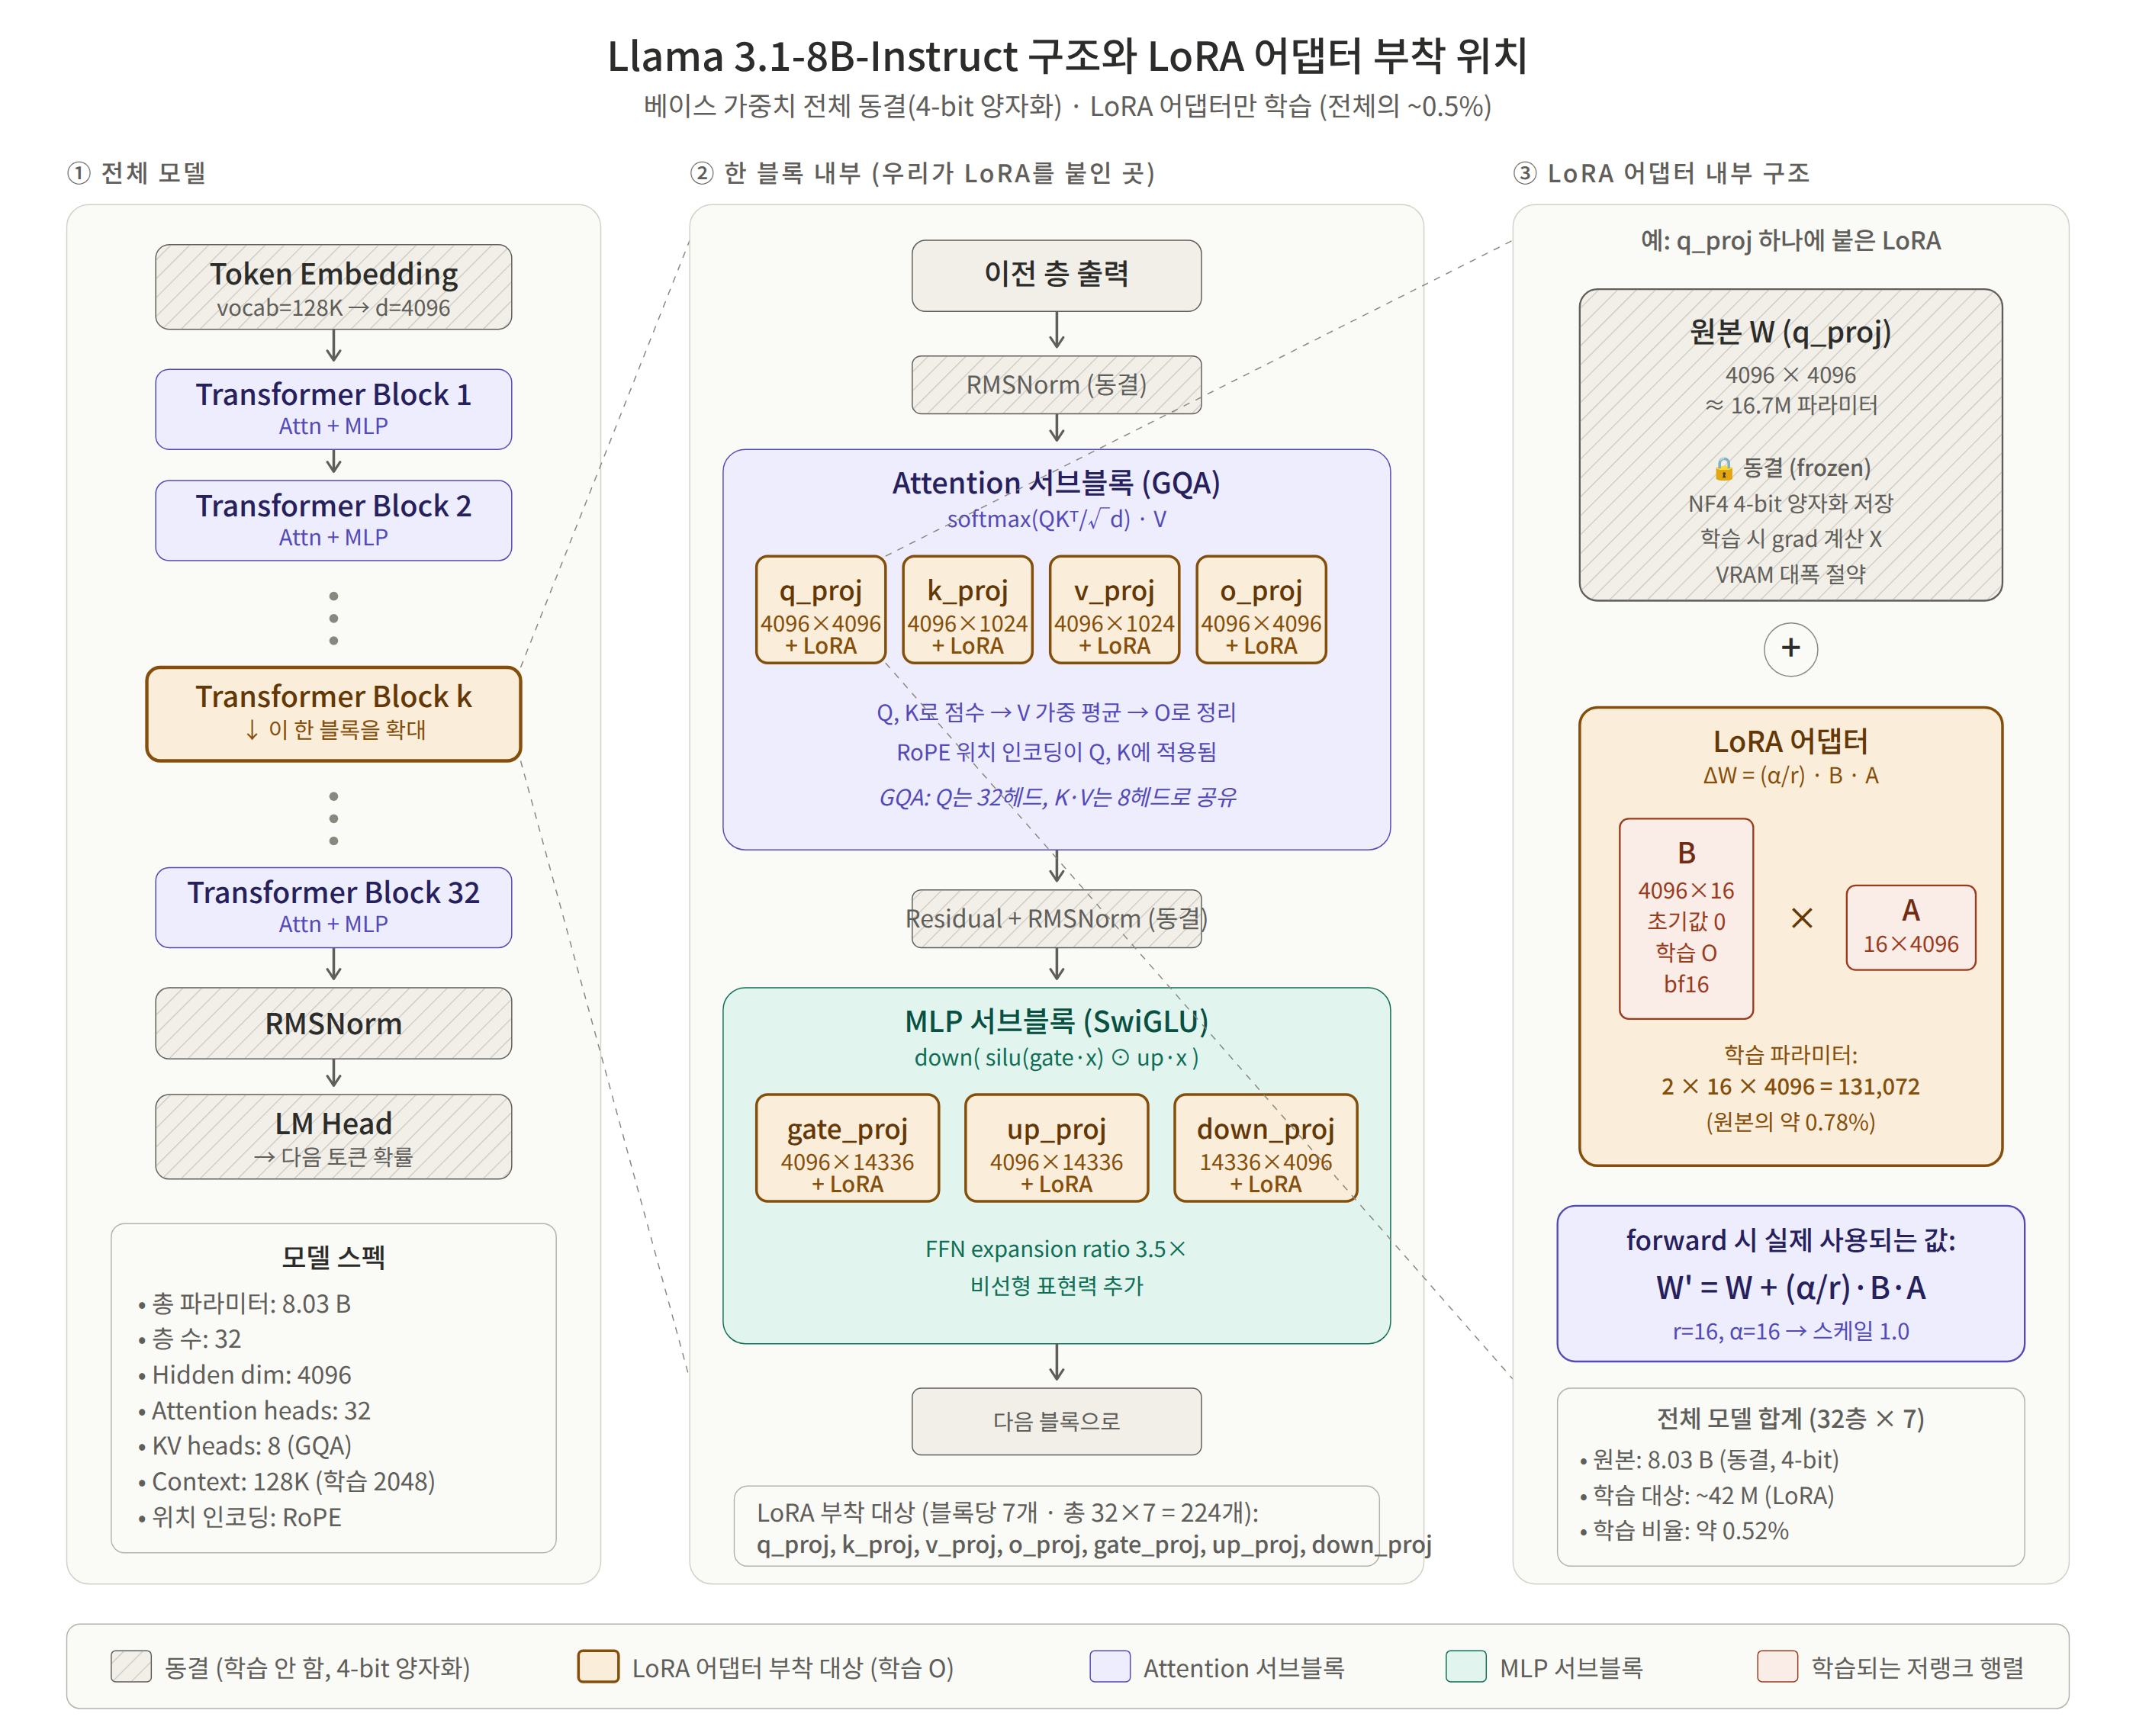
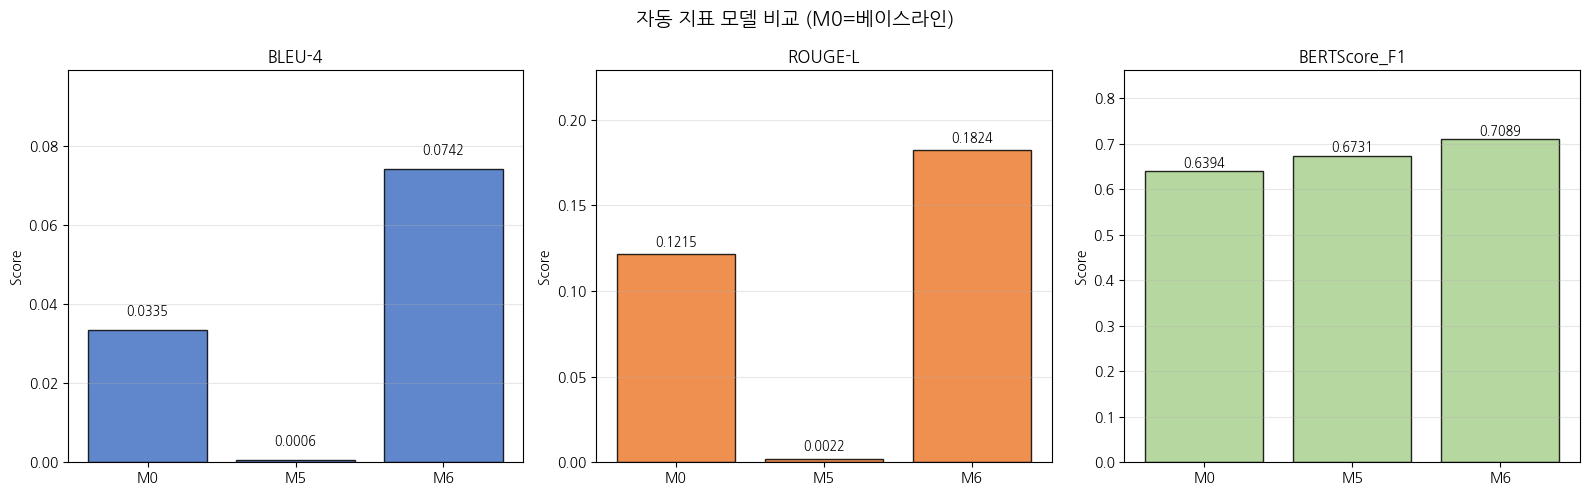
4月19日、血と汗を流して作り上げた仮想の合成データセット(v5)で訓練させたモデル(M6)のパフォーマンスを評価し、それを基に7週目の週間報告書を作成した日です。果たして10ドルの課金爆弾に耐えながら作り出したデータには、それだけの価値があったのでしょうか?
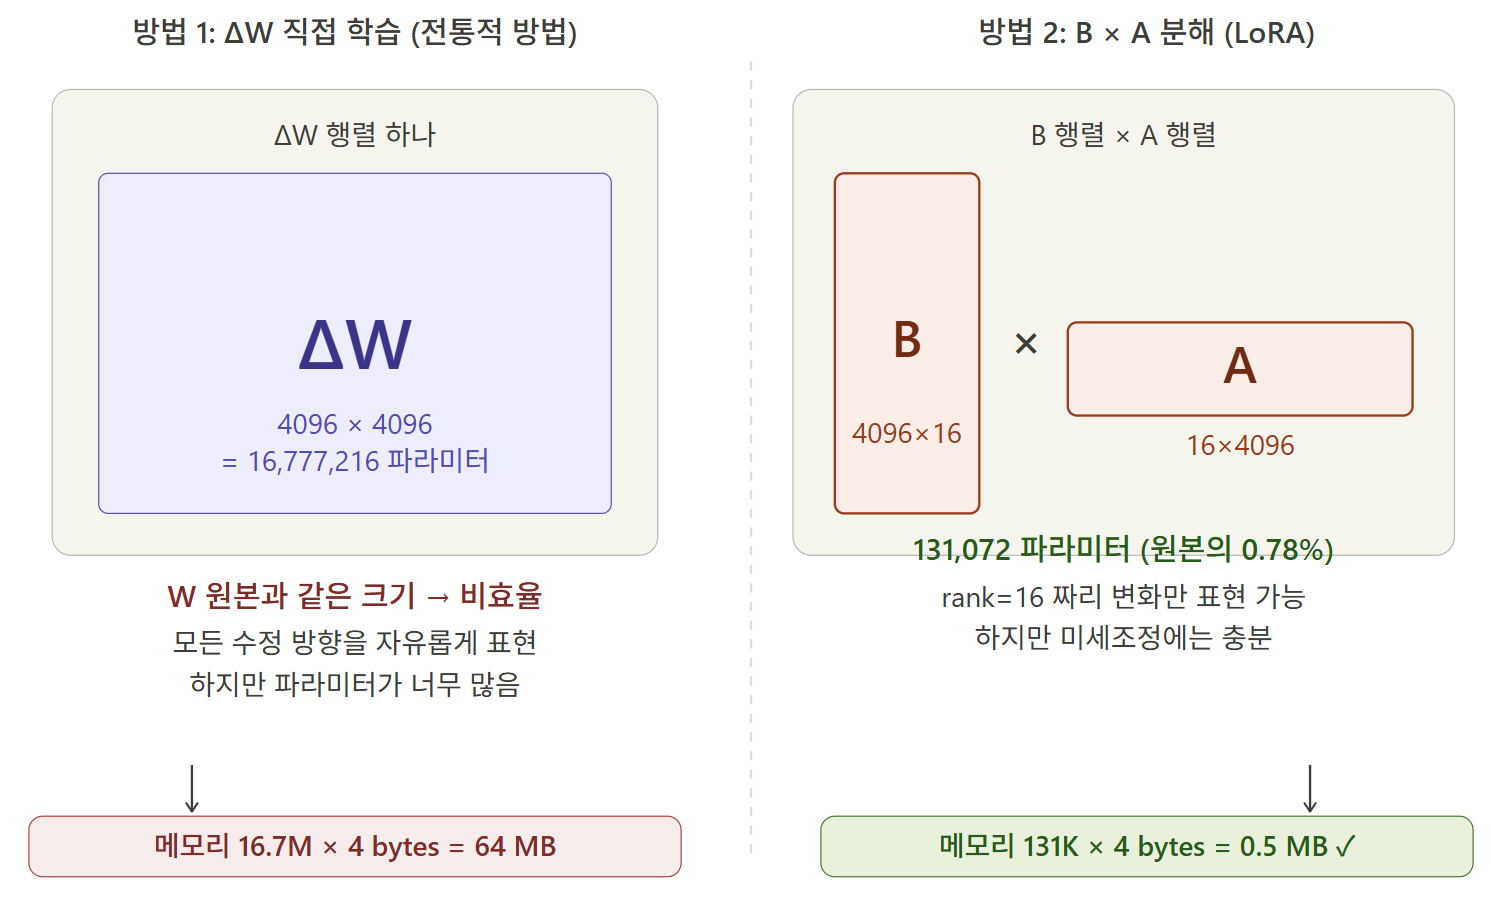
4月14日は、料金爆弾事件以降一時中断されていた合成データ(v5)生成作業を再開した日です。API料金限度額を引き上げ(制限解除)、システムを稼働させましたが、今回もすんなりとはいきませんでした。
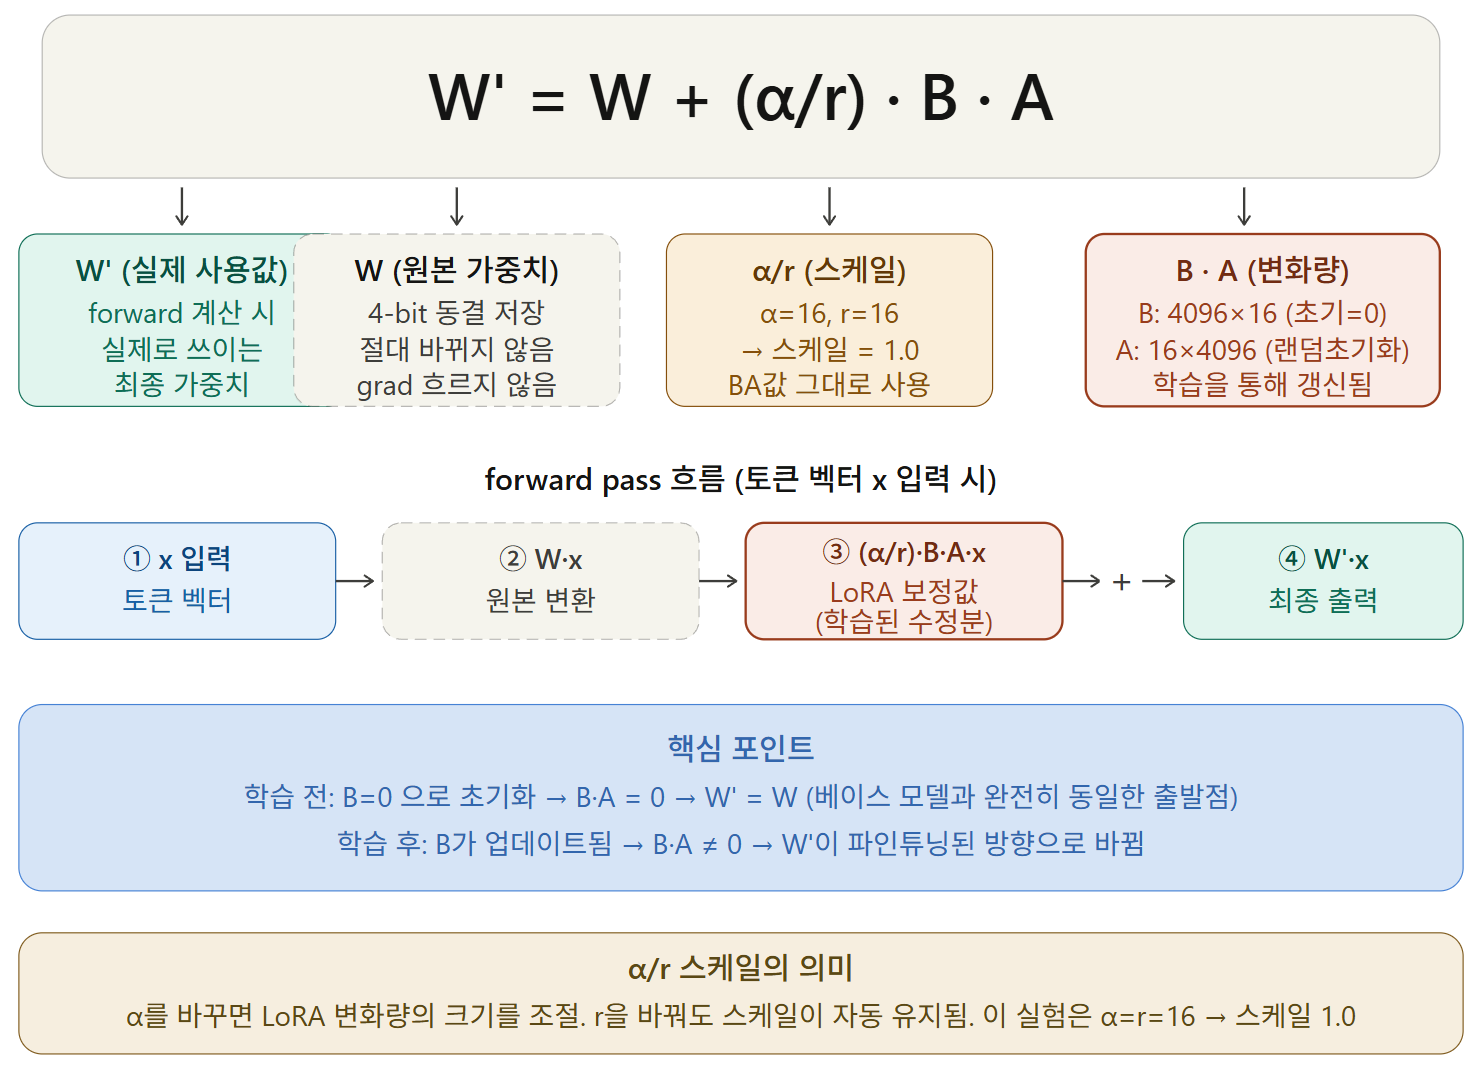
4月9日、昨日野心的に完成させたColabノートブックを使って、ついに人工知能モデル(Llama 3.1)の最初の学習(ファインチューニング)を試みました。しかし、現実はやはり甘くなく、数多くのエラーに直面しなければなりませんでした。同時に卒業研究6週目の中間発表資料まで作らなければならない過酷な一日でした。
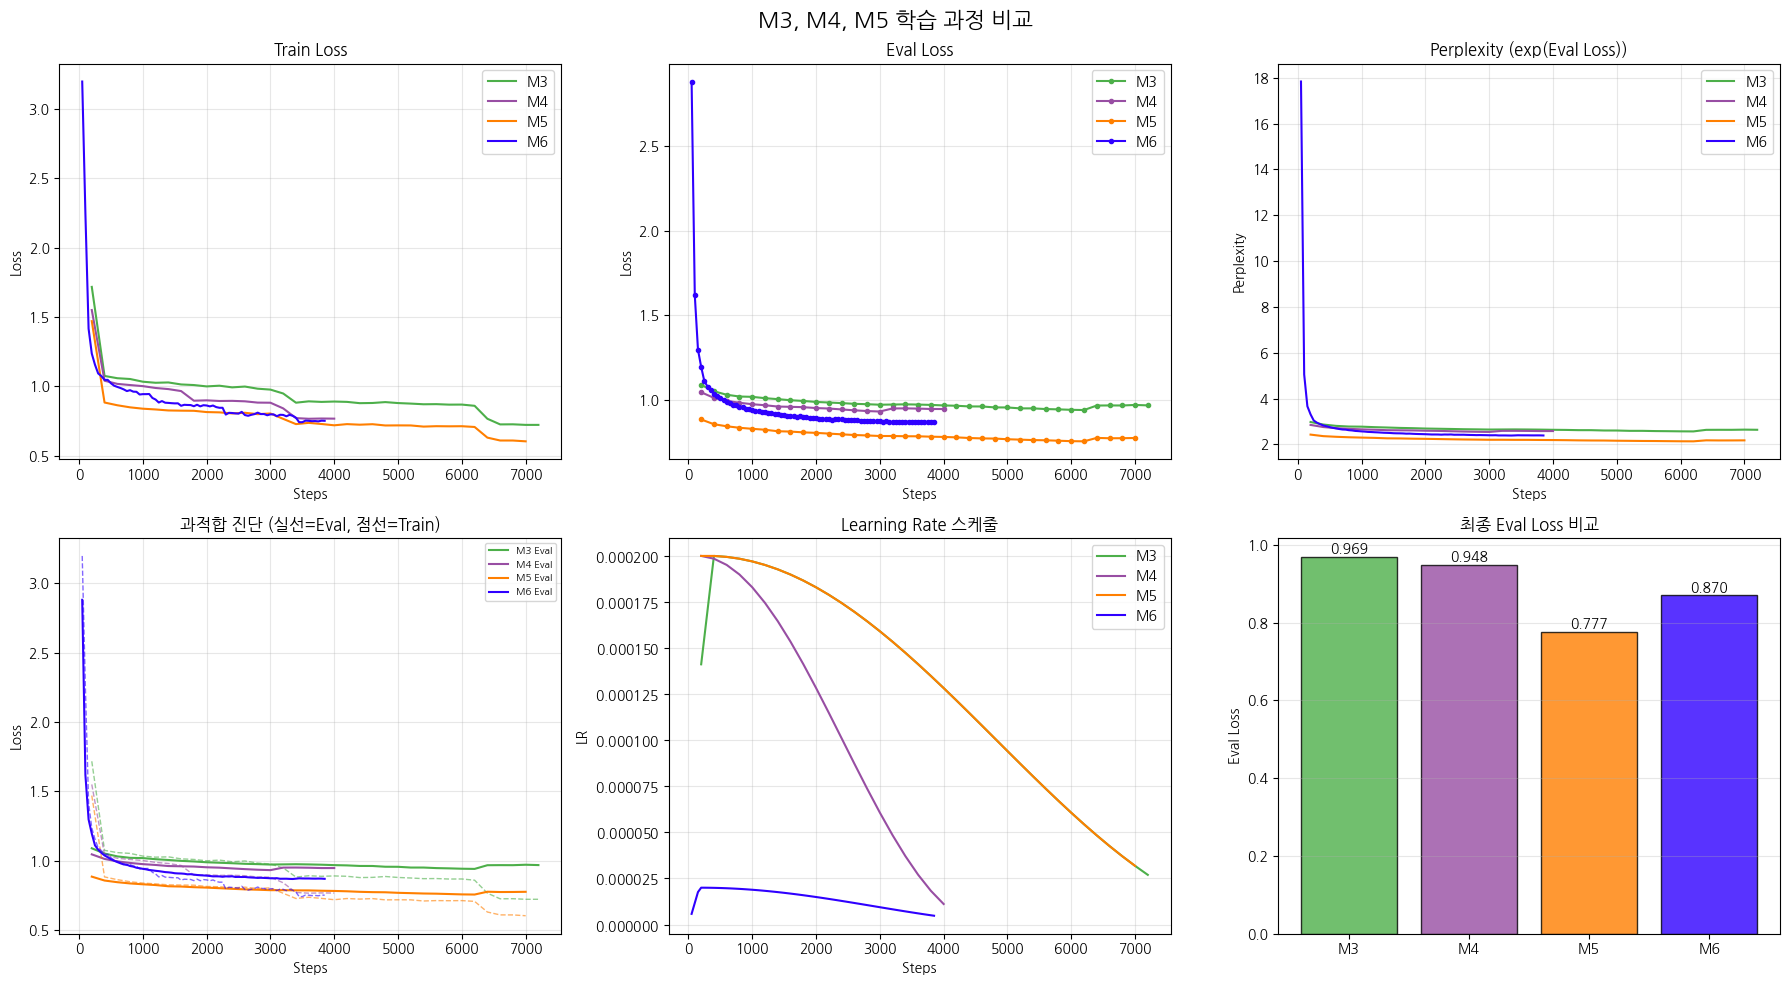
4月8日は、マウムジギプロジェクトを進める中で最大の危機であり、「笑えない」ハプニングが発生した日です。それはまさにClaude API月間限度額超過および料金爆弾事件です。
4月7日は、チームメンバーが構築したフロントエンドのコードをローカル環境で実行して統合を試みた日であり、 人工知能(AI)を活用して不足しているカウンセリングデータを新たに6万件も「合成(Synthesis)」するという巨大なスクリプトを稼働させた日です。
4月5日は、これまで進めてきた過酷なデータ前処理プロセス(v1〜v4)をまとめる最終報告書を作成し、 同時にマウムジギウェブサービスの顔となるフロントエンドプロジェクトを本格的にキックオフした日です。
4月3日、ディープラーニングモデル(Llama 3.1)に学習させるための対話データを精製する作業に本格的に着手した日の記録です。 単にデータを統合するだけでなく、人工知能(AI)にテキストを読ませて自ら感情を判別させる巨大なパイプラインを稼働させた日でもあります。
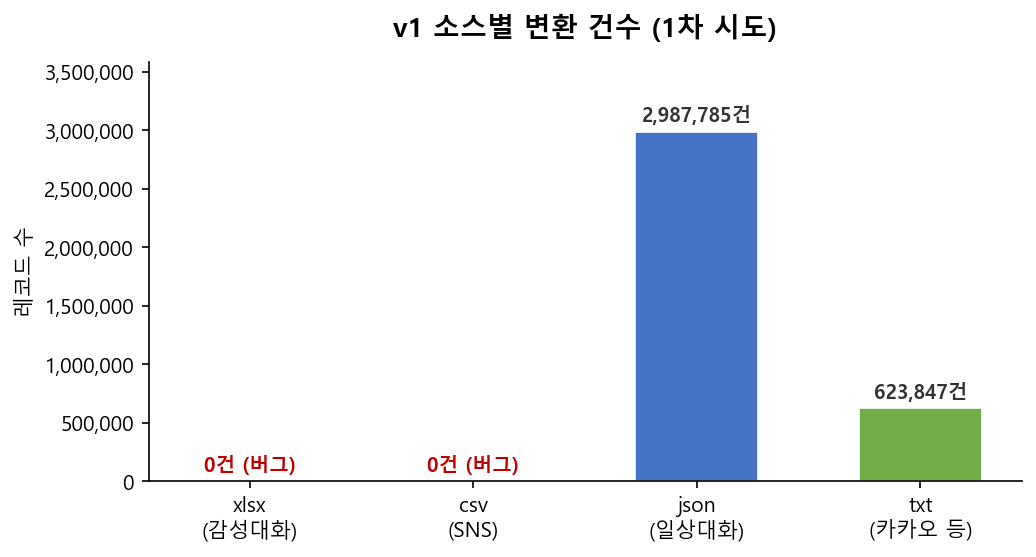
マウムジギプロジェクトの中核エンジンとなるLlama 3.1モデルを訓練するため、膨大な量の対話データをモデルが学習できる形式に加工し始めた4月1日の記録です。
マウムジギプロジェクトの初期方向であった国防コンベンション予約アラームアプリのAndroidビルドテストを進行すると同時に、 本格的に人工知能ベースのプロジェクトへの転換を暗示するLlama 3.1ファインチューニングデータ前処理を初めて開始した3月31日の記録です。
マウムジギプロジェクトの初期アイデアであった「国防コンベンション予約アラーム」アプリケーションの開発を本格的に開始した3月30日の記録です。 前回設定したコーディングルールに基づき、具体的なプロジェクト進行計画を立案し、テスト駆動開発(TDD)のための基盤を固めました。
これは、「マウムジギ(Maeumjigi)」プロジェクトの壮大な旅が初めて始まった2026年3月26日の記録です。 当時は、現在のAIベースの「マウムジギ」という名前ではなく、単純なAndroidアラームアプリの企画としてプロジェクトの第一歩を踏み出しました。