[마음지기 캡스톤 개발일지 #4] 파인튜닝 데이터 전처리 본격 가동
· 약 2분

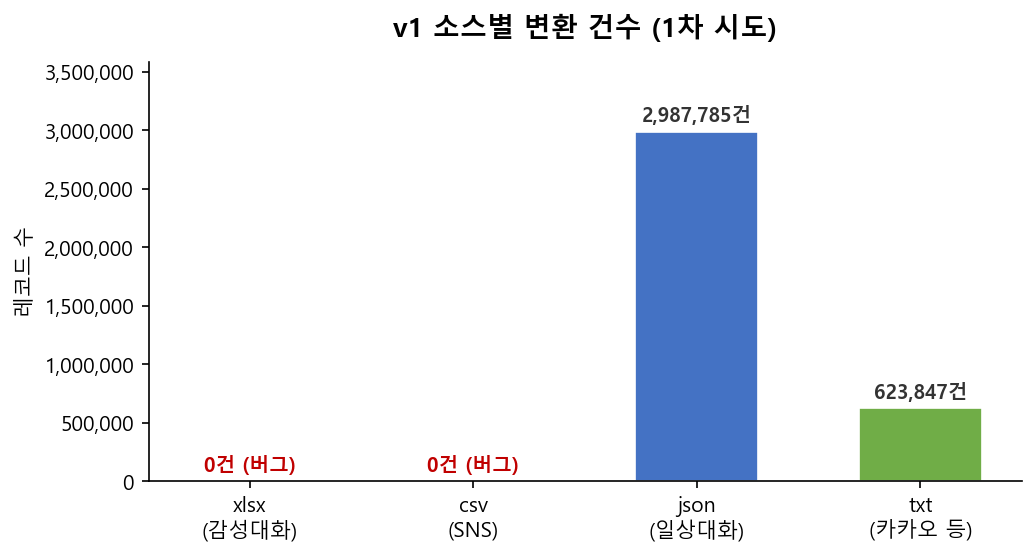
마음지기 프로젝트의 핵심 엔진이 될 Llama 3.1 모델을 훈련시키기 위해, 방대한 양의 대화 데이터를 모델이 학습할 수 있는 형식으로 가공하기 시작한 4월 1일의 기록입니다.
데이터 전처리 계획에 따른 자동화 실행
- 문제: 모델을 파인튜닝하기 위해서는 사용자의 발화와 챗봇의 응답이 담긴 원시 데이터를 Llama 3.1이 이해할 수 있는 특수한 JSONL 형식으로 완벽하게 변환해야 했습니다.
- 과정:
Claude Code에게: "llama31_finetuning_data_preprocessing_plan_short.md에 따라서 작업 진행"
- 결과: 어제 작성한 전처리 계획서(
llama31_finetuning_data_preprocessing_plan_short.md)를 바탕으로 AI 에이전트가 데이터 정제 및 가공 파이프라인을 스스로 구축하고 실행하기 시작했습니다. 사람이 직접 수만 건의 데이터를 일일이 변환하는 대신, 규칙이 적힌 마크다운 문서 하나를 던져주며 "이대로 처리해"라고 지시하는 방식입니다.
카테고리 데이터 통합 및 JSONL 변환
- 문제: 전처리 과정은 여러 단계(Step)로 쪼개져 있었고, 최종적으로 모든 데이터를 하나로 합쳐서 훈련용 데이터셋을 완성해야 했습니다.
- 과정:
Claude Code에게: "Step 4를 실행해. 두 카테고리 데이터를 통합해서 Llama 3.1 JSONL 형식으로 변환해."
- 결과: AI가 즉각적으로 Step 4를 수행하여 흩어져 있던 각 카테고리의 대화 데이터를 하나로 병합했습니다. 그리고 Llama 3.1이 요구하는 정확한 프롬프트 템플릿(System, User, Assistant 역할 구분)에 맞추어 JSONL 파일로 변환하는 스크립트를 작성하고 실행했습니다.
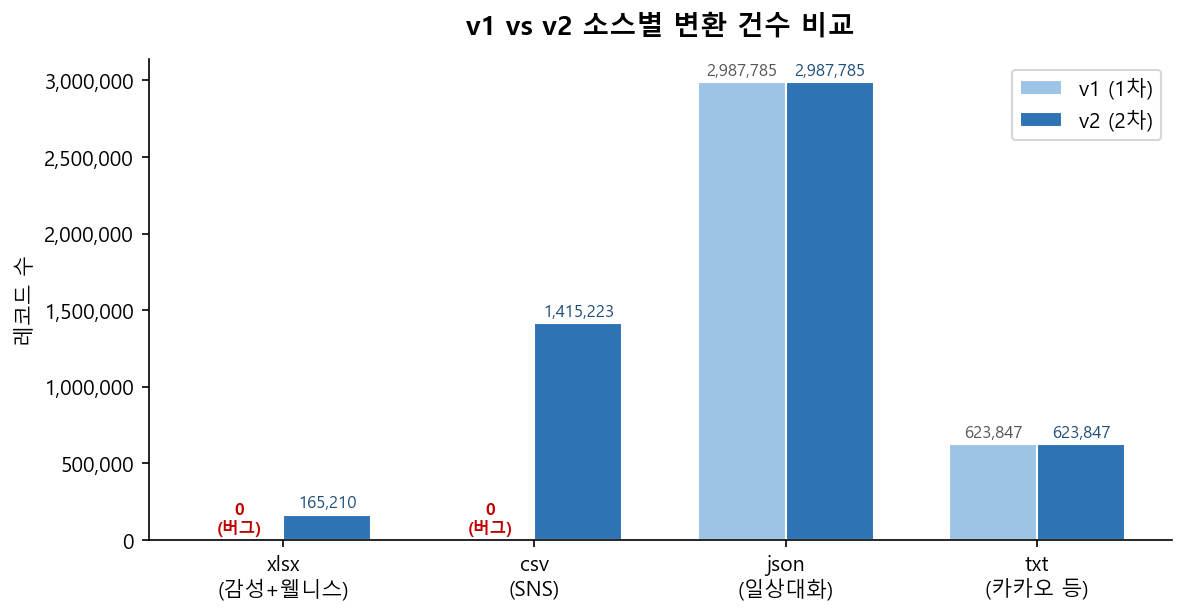
오늘은 파인튜닝의 꽃이라고 할 수 있는 '데이터 전처리' 과정이 AI를 통해 완전 자동화로 돌아가기 시작한 날입니다. "문서에 적힌 대로 알아서 해"라는 말 한마디로 수많은 데이터가 훈련 가능한 상태로 탈바꿈하는 마법 같은 경험이었습니다. 다음 연재에서는 이 전처리된 데이터들을 활용해 실제로 모델을 어떻게 훈련시키고 검증하는지, 흥미진진한 개발일지가 이어집니다!