[마음지기 캡스톤 개발일지 #11] 합성 데이터(v5) 훈련 결과 M6 모델 평가
· 약 2분

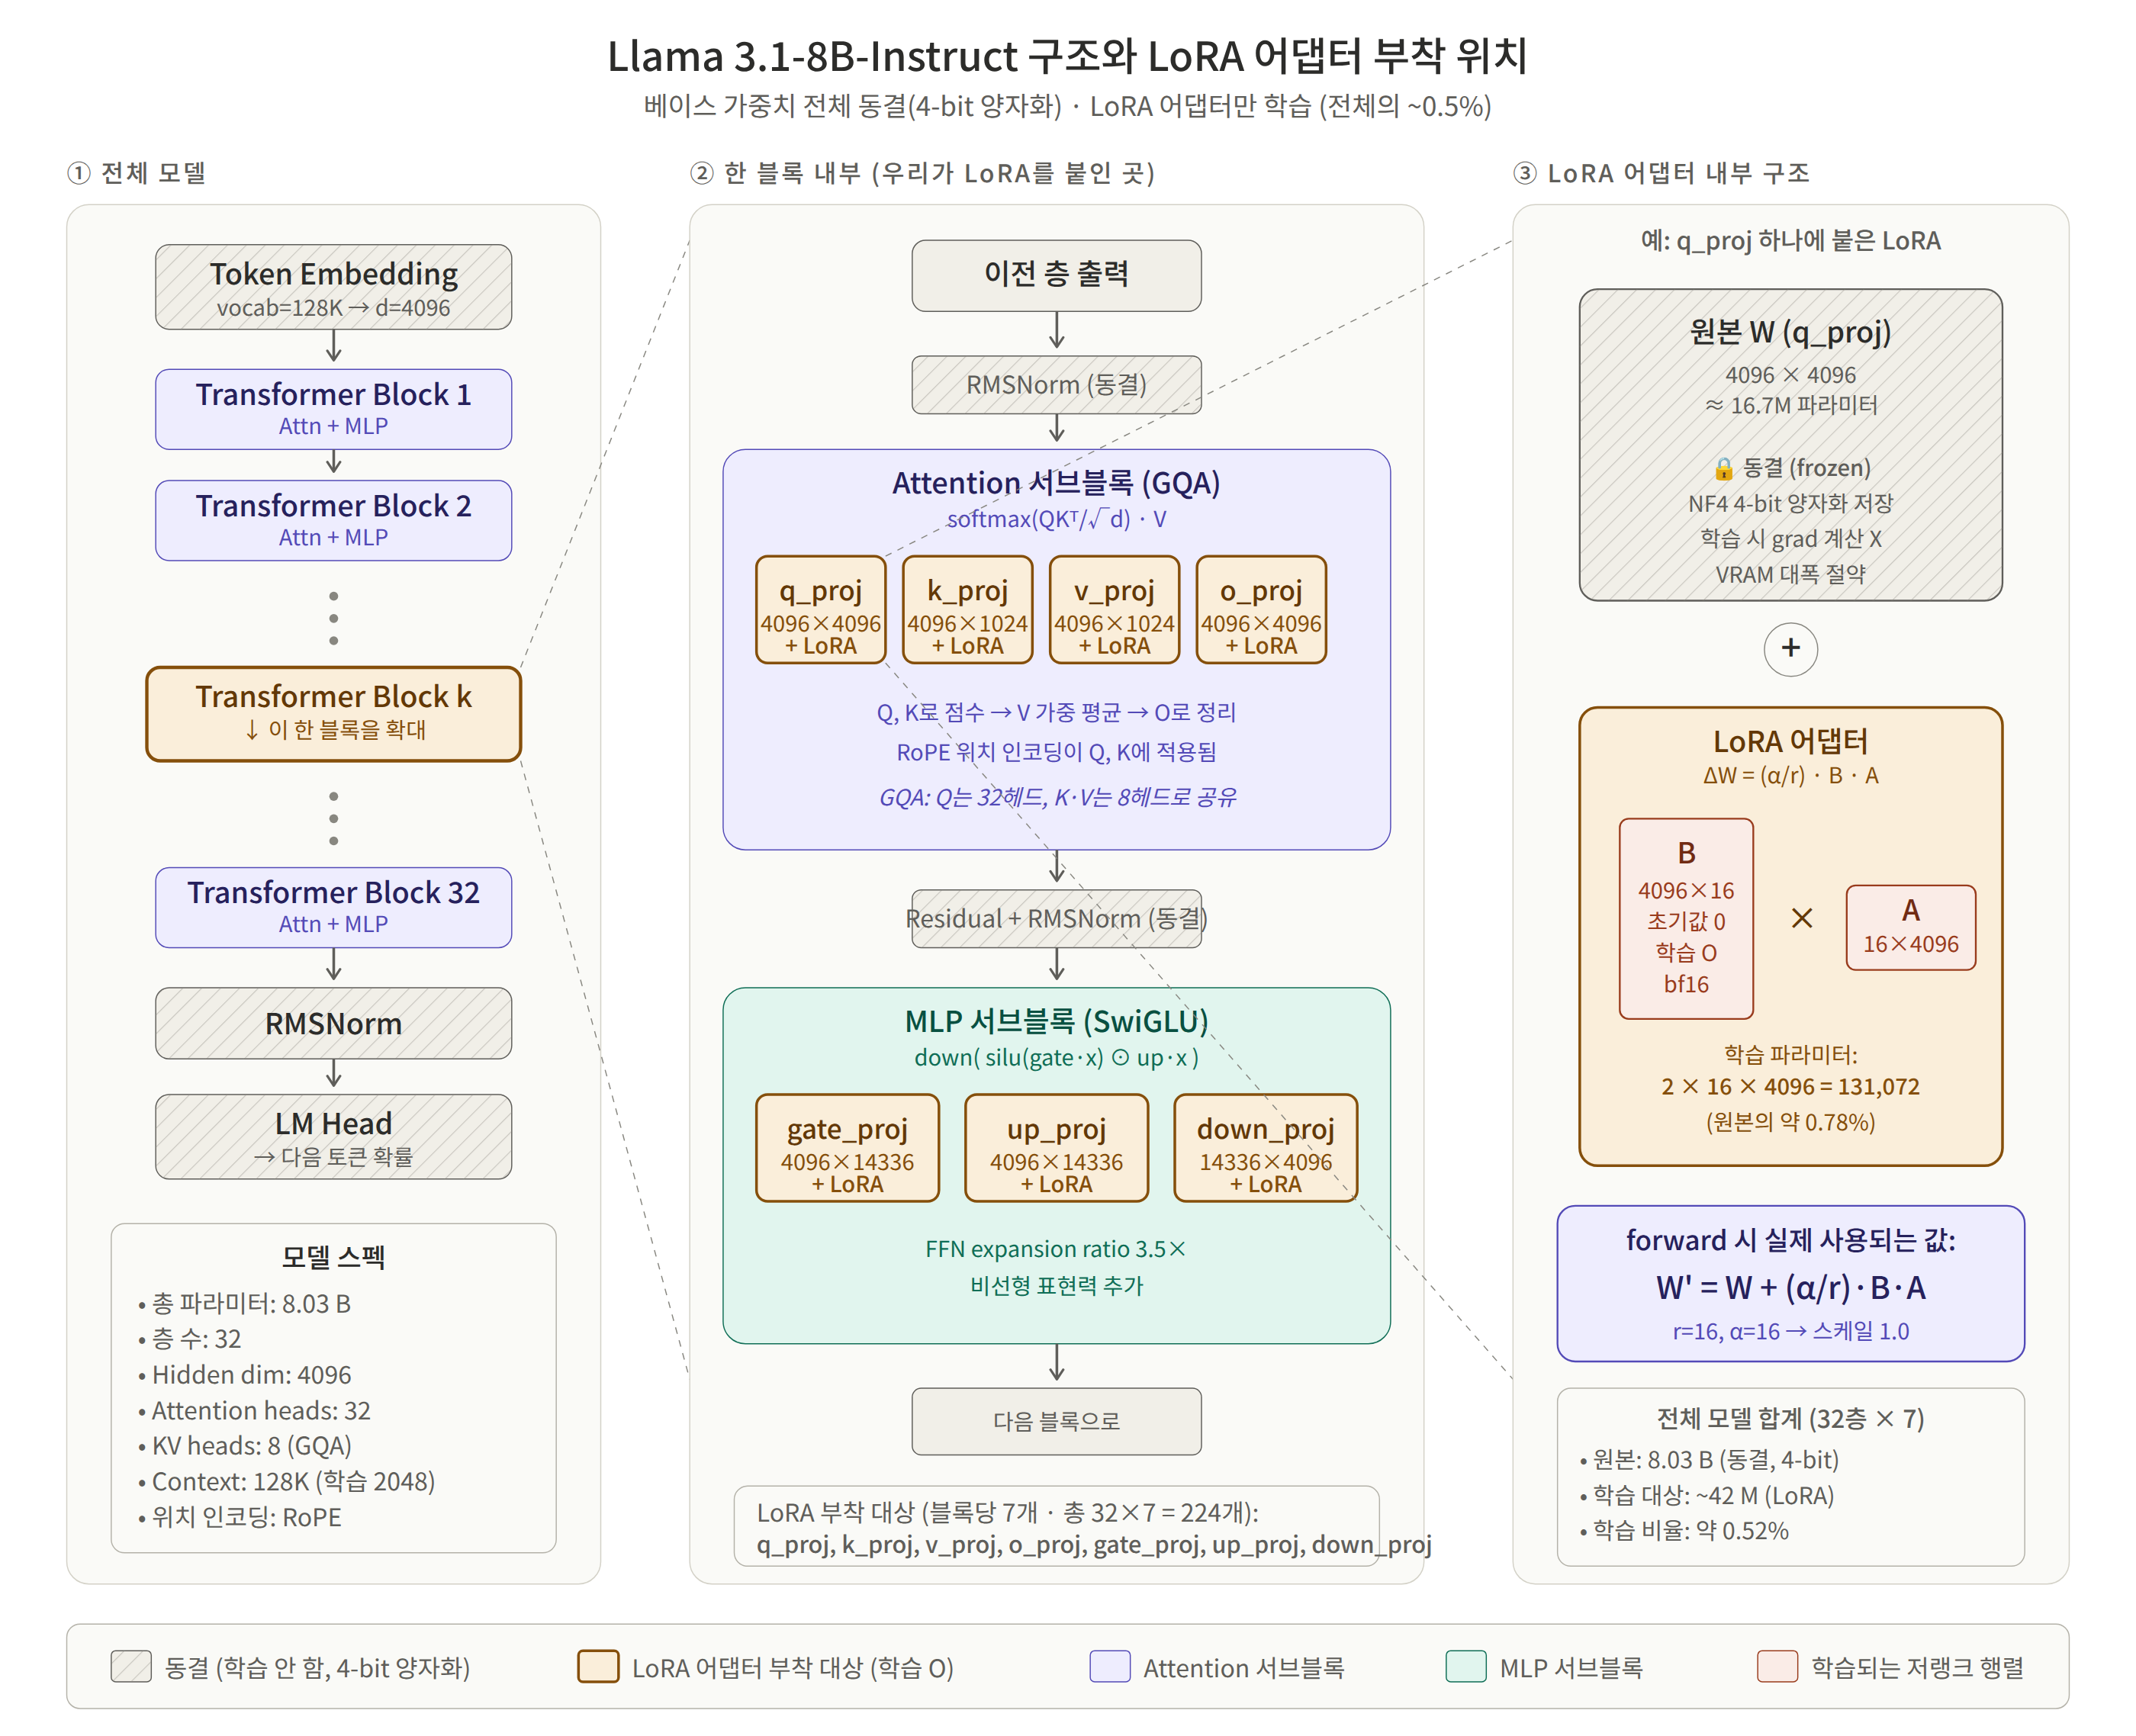
4월 19일, 피땀 흘려 만들어낸 가상의 합성 데이터셋(v5)으로 훈련시킨 모델(M6)의 성능을 평가하고, 이를 바탕으로 7주 차 주간 보고서를 작성한 날입니다. 과연 10달러의 과금 폭탄을 견뎌내며 만들어낸 데이터는 그만한 가치가 있었을까요?
모델 성능 진검승부: M0 vs M5 vs M6
- 문제: 지도교수님과 팀원들을 설득하기 위해, 단순히 "좋아졌다"가 아니라 정량적인 테스트 결과와 직관적인 비교 예시가 포함된 주간 보고서가 필요했습니다.
- 과정:
"보고서 재작성 바람. 주요 포인트는 v4를 기반으로 한 M5와 v5를 기반으로 한 M6의 비교이다... 각 데이터셋의 예시를 포함하여 작성 바람." "테스트 결과에 대해 서술할 때 튜닝 전 기본 모델(M0)과 M6의 차이도 예시를 든 설명을 포함해 줘."
- 결과: AI가 M0, M5, M6 모델이 생성한 텍스트 결과를 분석하여 비교 파일을 추출(
m0_m6_compare.json)했습니다. 그 결과, 기본 Llama 3.1 모델(M0)은 한국어 상담에 다소 어색한 모습을 보였고, 정제 데이터(v4)로 학습한 M5는 나아졌지만 깊이가 부족했던 반면, 고품질 합성 데이터(v5)로 학습한 M6 모델은 사용자의 감정에 깊이 공감하는 심리상담사 특유의 따뜻하고 전문적인 어투를 완벽하게 구사해 냈습니다.
AI가 대신 써주는 7주 차 주간 보고서 (DOCX)
- 과정:
"결과와 의의를 중점으로 7주 차 보고서를 두 버전(5장 이내 간결 버전, 상세 버전)으로 작성해 주세요. 그리고 두 md를 기반으로 각각 docx 파일을 생성해 줘."
- 결과: 지시 한 번에
7주차_보고서_v1_간결.md,7주차_보고서_v2_상세.md두 가지 버전이 뚝딱 완성되었고, 깔끔하게 워드 파일로 변환까지 완료되었습니다.
RAG 아키텍처 도입: FAISS DB 구축 평가
- 과정:
"FAISS_DB_구축을 수행하고 FAISS_DB_구축_보고서.docx를 작성했습니다. 우리의 계획과 해당 보고서 결과에 대해 평가해 주세요."
- 결과: 단순히 모델의 가중치를 깎는 파인튜닝뿐만 아니라, 외부 지식을 참조하여 할루시네이션(환각)을 줄이는 RAG(검색 증강 생성) 기법을 위해 FAISS 벡터 데이터베이스를 도입했습니다. AI에게 제가 구축한 구조를 평가해 달라고 요청했고, 긍정적인 피드백(
FAISS_DB_구축_평가.md)을 받았습니다.
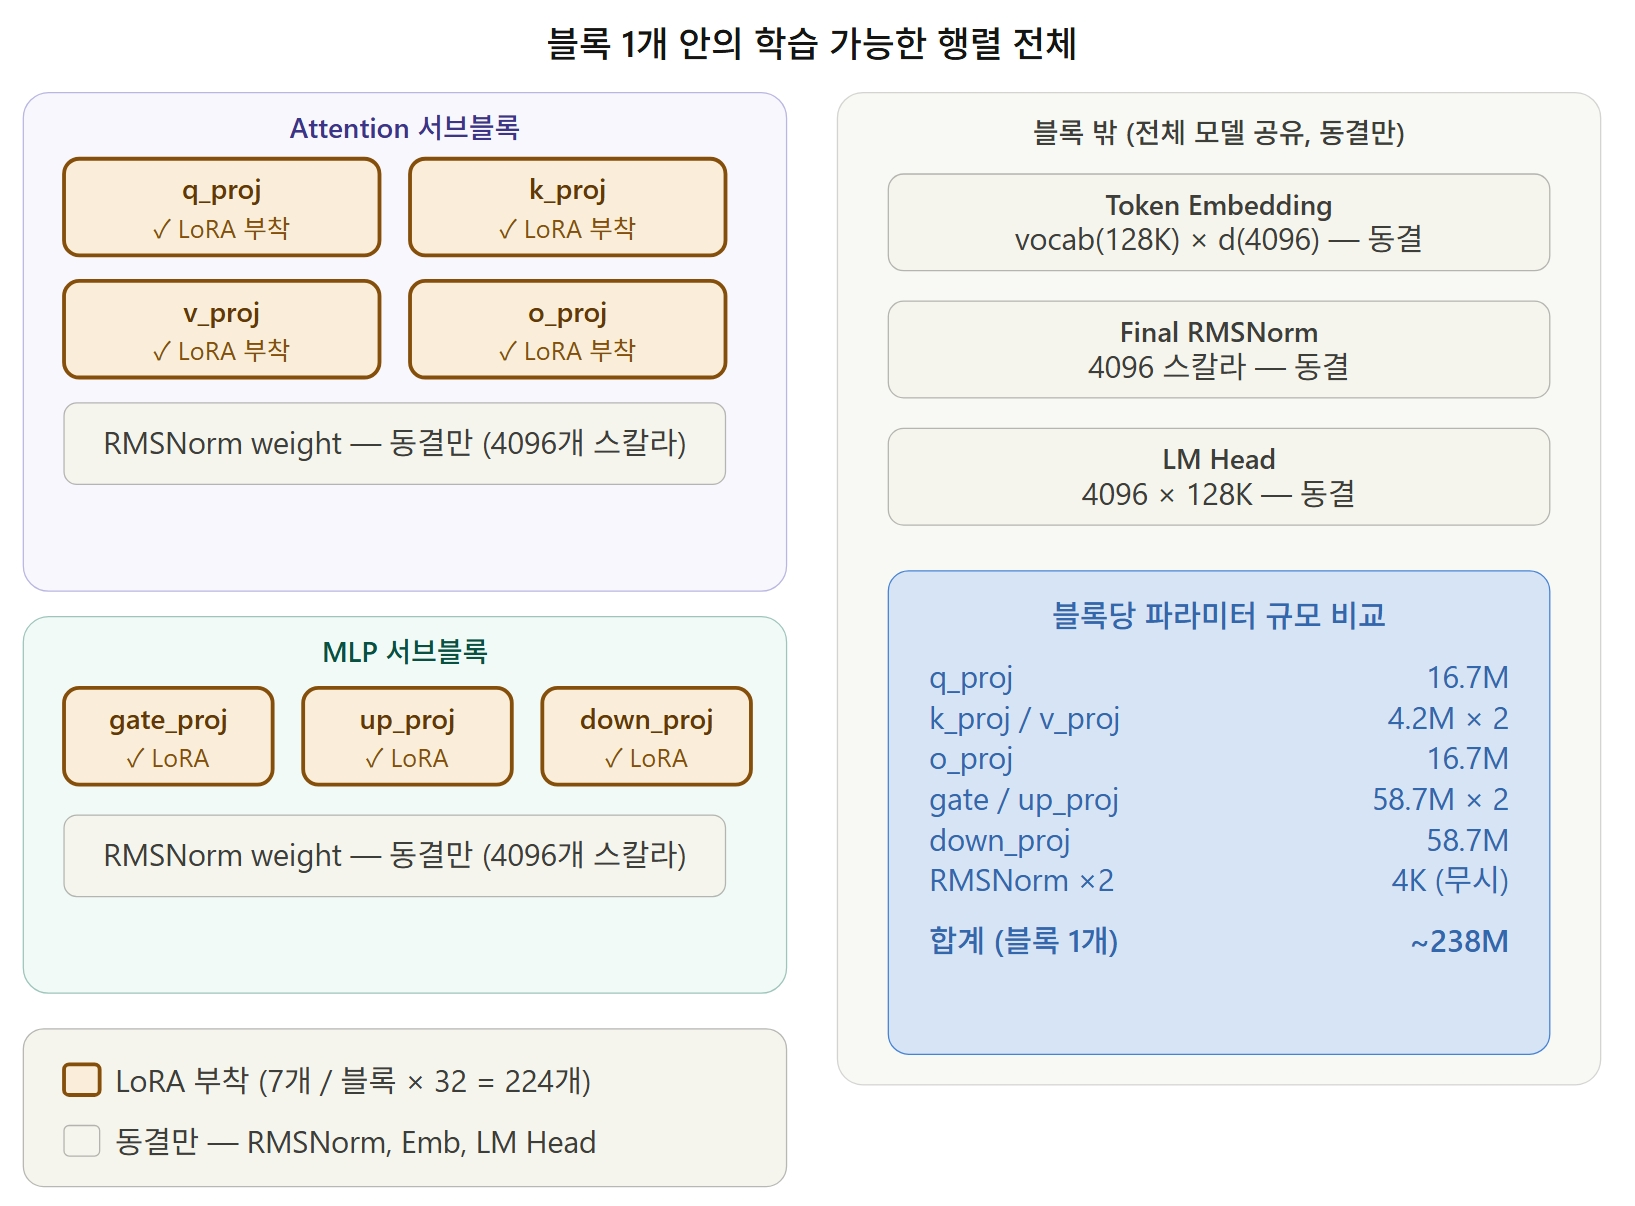
오늘은 그동안의 고생이 빛을 발한 날이었습니다. 훈련시킨 AI 모델이 정말로 눈에 띄게 똑똑해진 것을 확인했을 때의 그 짜릿함이란! 모델 성능도 입증했고, FAISS DB까지 성공적으로 연동되었으니 마음지기 챗봇이 완성에 한 걸음 더 가까워졌습니다.