[마음지기 캡스톤 개발일지 #12] 70B 초대형 모델 파인튜닝과 GPU 메모리(OOM) 사투
· 약 2분

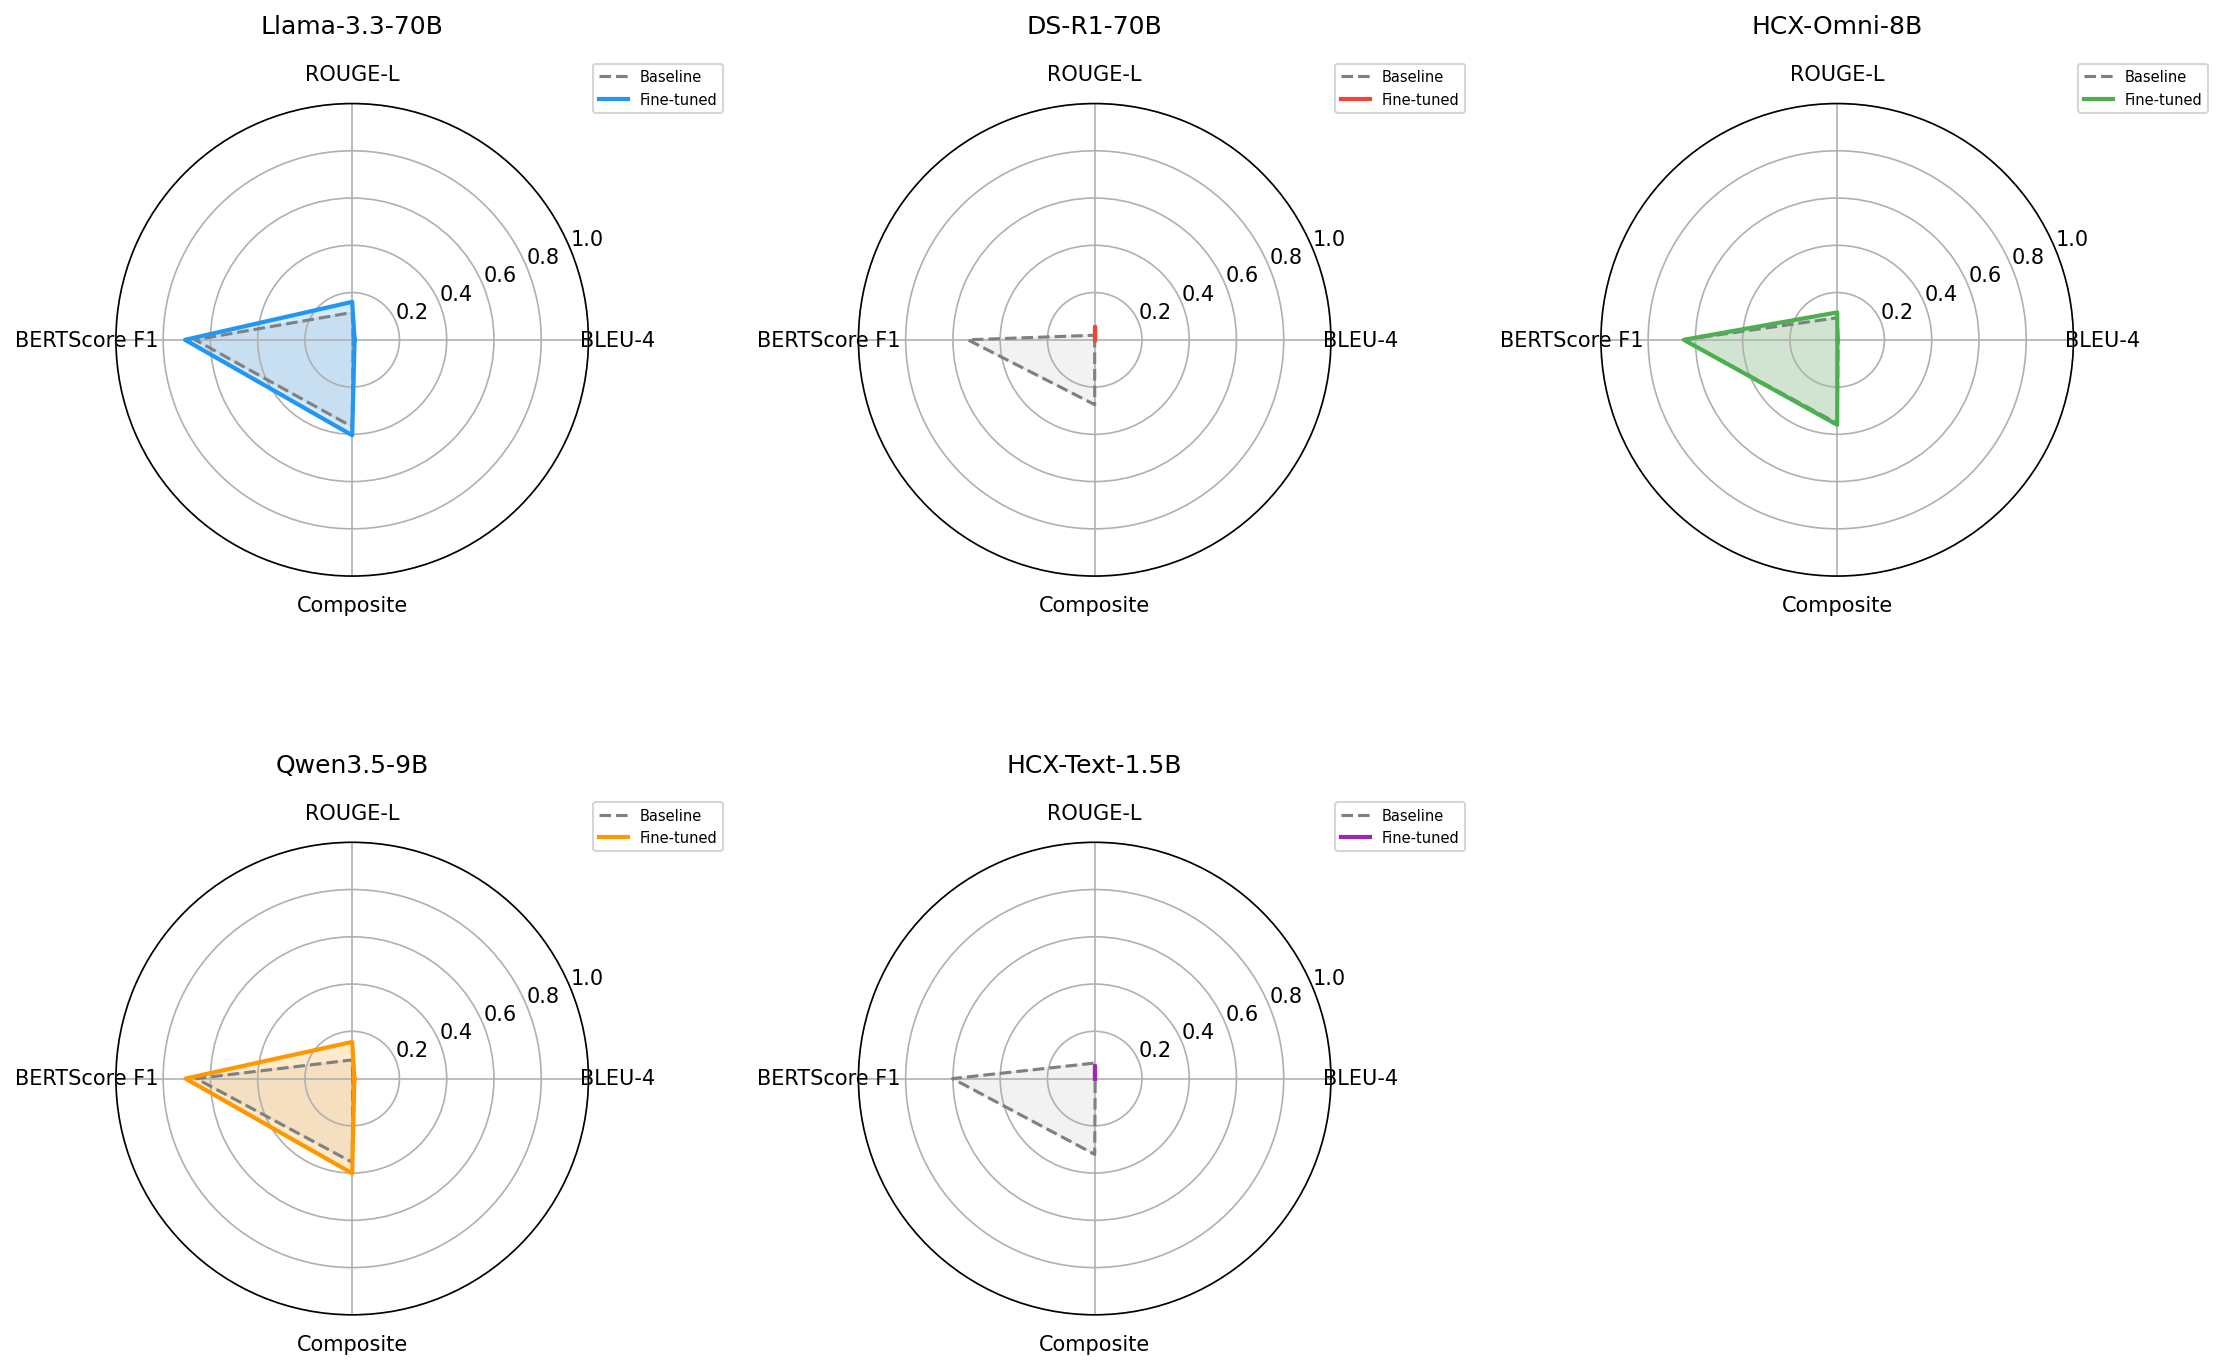
5월 3일, 그동안 8B 모델로 충분히 감을 잡은 저희 팀은 드디어 진정한 성능의 끝판왕, 70B(700억 개 매개변수) 초대형 모델의 파인튜닝에 도전했습니다. Llama 3.3 70B와 DeepSeek-R1 70B 두 가지 모델을 대상으로 학습을 시도했는데, 예상대로 엄청난 하드웨어 자원의 장벽에 부딪히고 말았습니다.
70B 모델, 그리고 OOM(Out of Memory)의 공포
- 문제: 호기롭게 서버에 70B 파인튜닝 코드를 올리고 실행하자마자 오류가 터져 나오기 시작했습니다.
- 과정:
"서버의 fine_tuning 폴더와 하위 파일을 복사했습니다. 복사한 파일 확인 후 오류 원인을 파악해 줘." "DeepSeek의 70B 모델은 수정하지 않아도 되나? 오류 가능성 확인 바람."
- 결과:
train_log.jsonl을 분석하며 남은 예상 소요 시간을 묻는 여유도 잠시, 70B 모델이 GPU 메모리를 순식간에 집어삼켜버렸습니다. (OOM 에러 발생!)
GPU 메모리 다이어트 작전
- 문제: "이미 GPU memory의 사용량은 MAX이다." 어떻게든 메모리 사용량을 줄여야 학습이 멈추지 않고 돌아갈 수 있었습니다.
- 과정:
"save_steps = 50, save_total_limit = 10, eval_steps = 50, patience = 10 으로 수정." "설정한 early stopping 조건에 대해 평가 바람." "ft_configs.yaml에서 70B 두 모델의 max_seq_length를 512로 설정했으나 서버 nvitop에서는 여전히 memory가 max로 사용됩니다. 왜 그런가?"
- 결과: 한 번에 처리하는 문맥의 길이(
max_seq_length)를 512로 과감하게 줄이고, 불필요한 저장을 줄이기 위해 하이퍼파라미터를 대폭 수정했습니다. 하지만nvitop으로 모니터링해보니 여전히 VRAM은 한계치에 달해 헐떡이고 있었습니다. 급기야 스텝 100, 150 부근에서 계속 멈춰버리는 끔찍한 현상이 반복되었습니다.
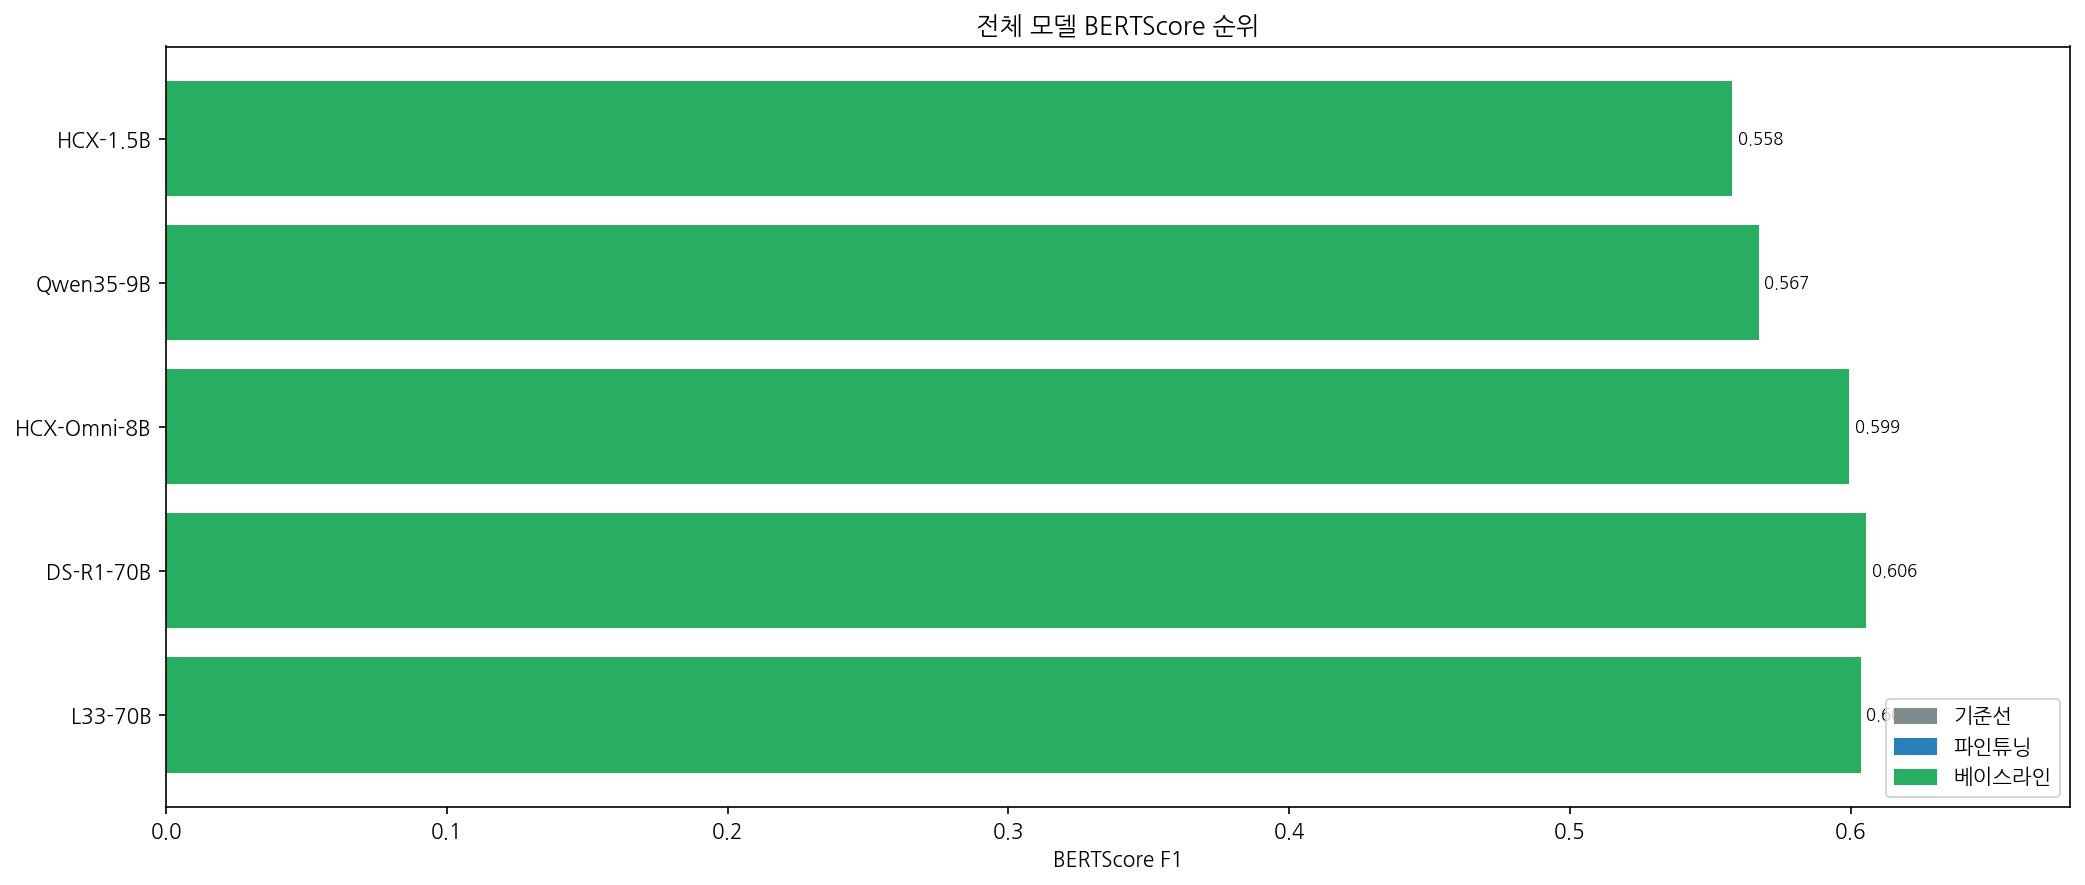
70B라는 거대한 짐승을 길들이는 것은 정말 쉽지 않습니다. AI에게 끝없이 에러 로그를 던져주며 해결책을 찾고 있지만, 물리적인 VRAM 한계를 소프트웨어 최적화 기법(LoRA, 퀀타이제이션 등)으로 극복할 수 있을지 끝없는 테스트가 필요해 보입니다. 과연 우리는 70B 모델 파인튜닝에 성공할 수 있을까요? 다음 일지에서 계속됩니다!