[마음지기 캡스톤 개발일지 #14] 모든 파인튜닝 완료 및 병렬 추론(Eval) 환경 구축

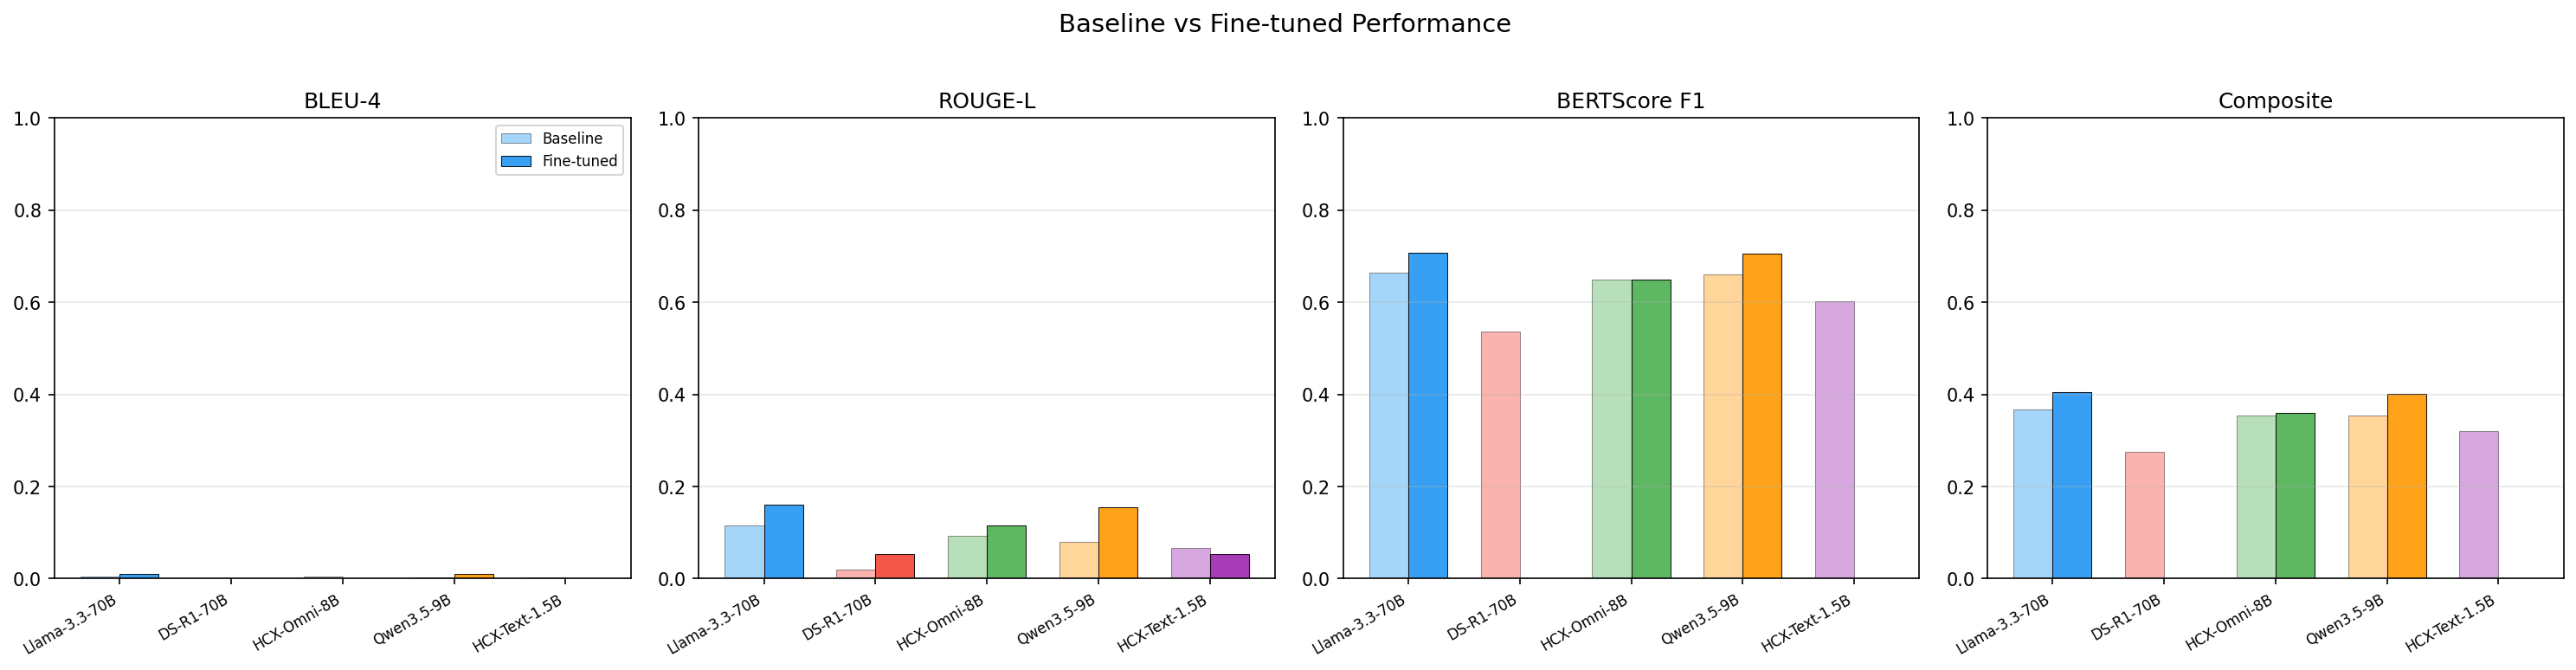
5월 6일, 드디어 길고 길었던 파인튜닝의 늪에서 빠져나왔습니다! 며칠간의 밤샘 작업과 하이퍼파라미터 조율 끝에 HCX-Omni-8B와 Qwen35-9B 등 중소형 모델들의 학습이 성공적으로 마무리되었습니다.
드디어 완료된 파인튜닝, 그리고 로그 분석
학습이 진행됨에 따라 손실(loss) 값이 안정적으로 감소하는 것을 확인할 수 있었습니다.
step= 1200  loss=0.9698  lr=1.88e-04  gpu=7.7GB
step= 1250  loss=0.8523  lr=1.86e-04  gpu=7.7GB
...
step= 1650  loss=0.8783  lr=1.73e-04  gpu=7.7GB
다만, 이 값이 train loss인지 validation loss인지 헷갈려 AI에게 물어보기도 하고, "우리 코드에서 eval loss도 기록하지 않나요?"라며 뒤늦게 평가 손실 기록이 누락되었는지 점검하는 해프닝도 있었습니다. 하지만 이미 학습이 모두 끝난 상태라(현재 파인튜닝까지 모두 완료하였으므로 지금까지 결과 평가 진행), 일단 생성된 최신 체크포인트 모델들을 바탕으로 바로 추론 및 평가(Eval) 단계로 넘어갔습니다.
병렬 추론(Parallel Inference) 환경 구축
20_eval_ft_models.ipynb 노트북을 이용해 각 모델이 사용자 대화에 어떻게 답변하는지 생성(Generation) 테스트를 시작했습니다. 추론 시 생성할 최대 토큰 수(max_new_tokens)를 1024로 넉넉하게 통일하면서, 혹시나 또 OOM이 터지지 않을까 노심초사했습니다.
그런데 추론 속도가 생각보다 너무 느렸습니다.
"학습은 두 그래픽카드로 했는데 왜 추론은 하나의 그래픽 카드만 사용하나?"
서버에 탑재된 GPU 자원을 100% 활용하기 위해, AI의 도움을 받아 추론 역시 병렬로 처리할 수 있는 run_eval_parallel.sh 스크립트를 새롭게 작성했습니다. 이를 통해 모델 추론 시간을 비약적으로 단축할 수 있었고, 모델별 추론 결과와 퍼플렉서티(Perplexity)를 엑셀 파일로 자동 집계하는 파이프라인까지 훌륭하게 구축해 냈습니다.
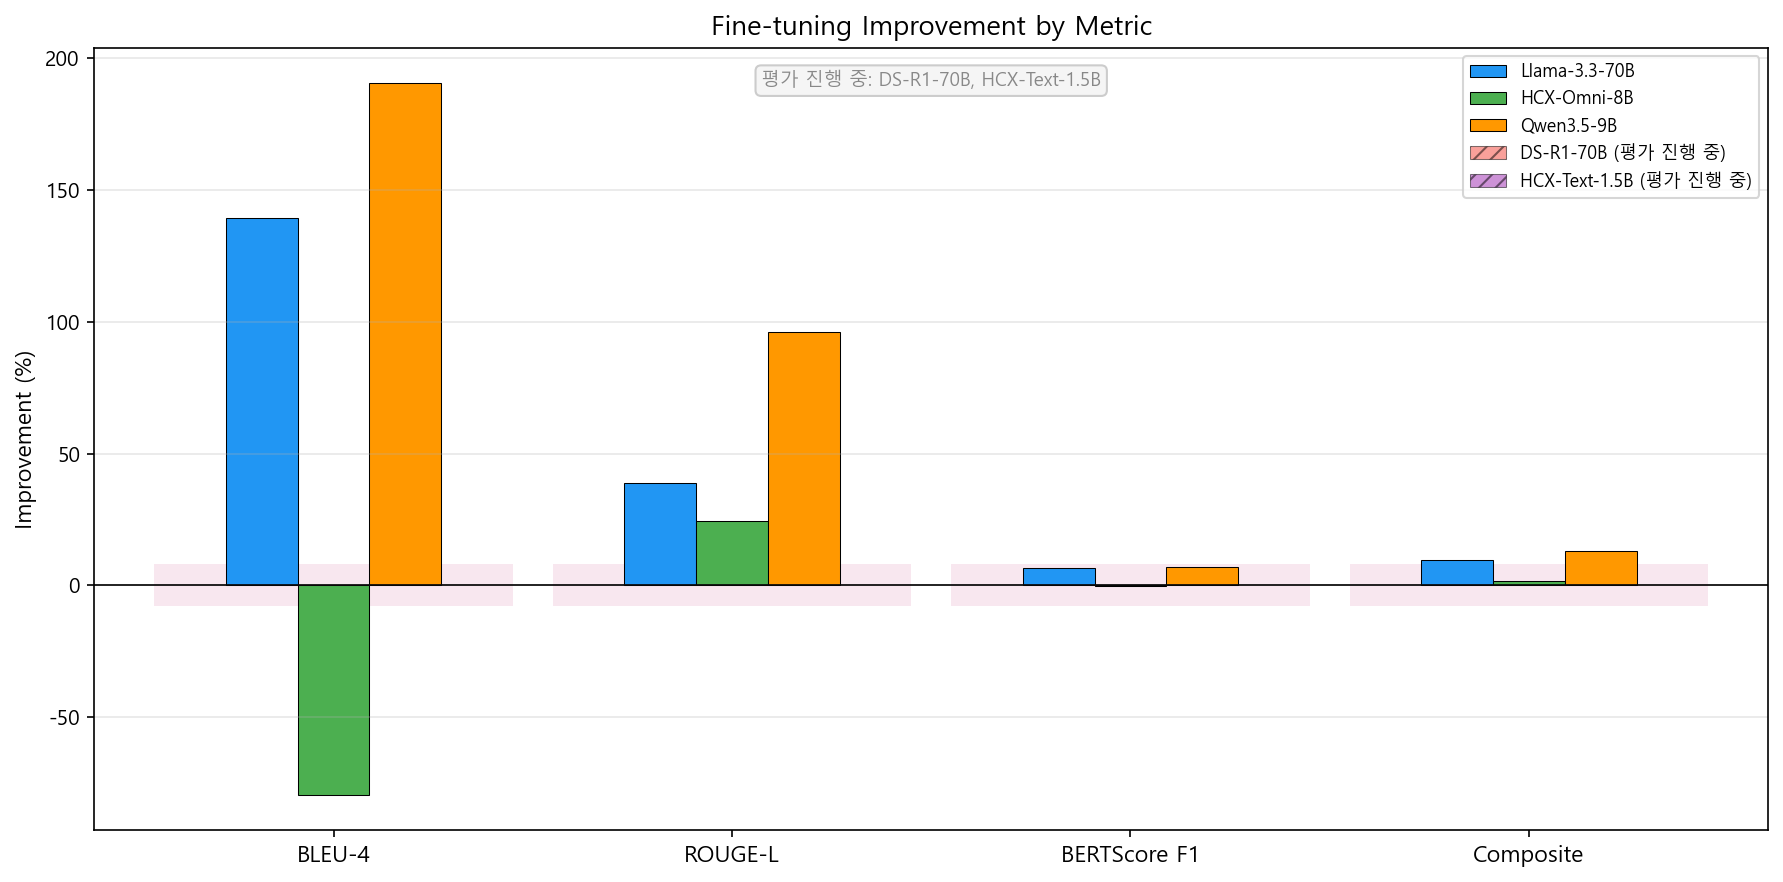
DSR1-70B 모델 추론 후 다음 모델로 넘어갈 때 VRAM이 제대로 반환되지 않아 에러가 발생하기도 했지만, 이 역시 병렬 스크립트로 환경을 격리하며 해결했습니다. 이제 진짜로 각 모델들의 답변 퀄리티를 비교해 볼 시간입니다!