[Webots 로보틱스] Q-Learning 자율주행: 648개 상태 공간 이산화와 소켓 통신 아키텍처 (#1)

📌 핵심 요약 (TL;DR)
- 문제(Problem): 연속적인 센서 거리·각도 데이터로 인해 고전적 표 기반 Q-Learning(Tabular Q-Learning) 적용 시 상태 공간 폭발 및 Webots 시뮬레이터와 학습 스크립트 간 실시간 동기화 오버헤드 발생.
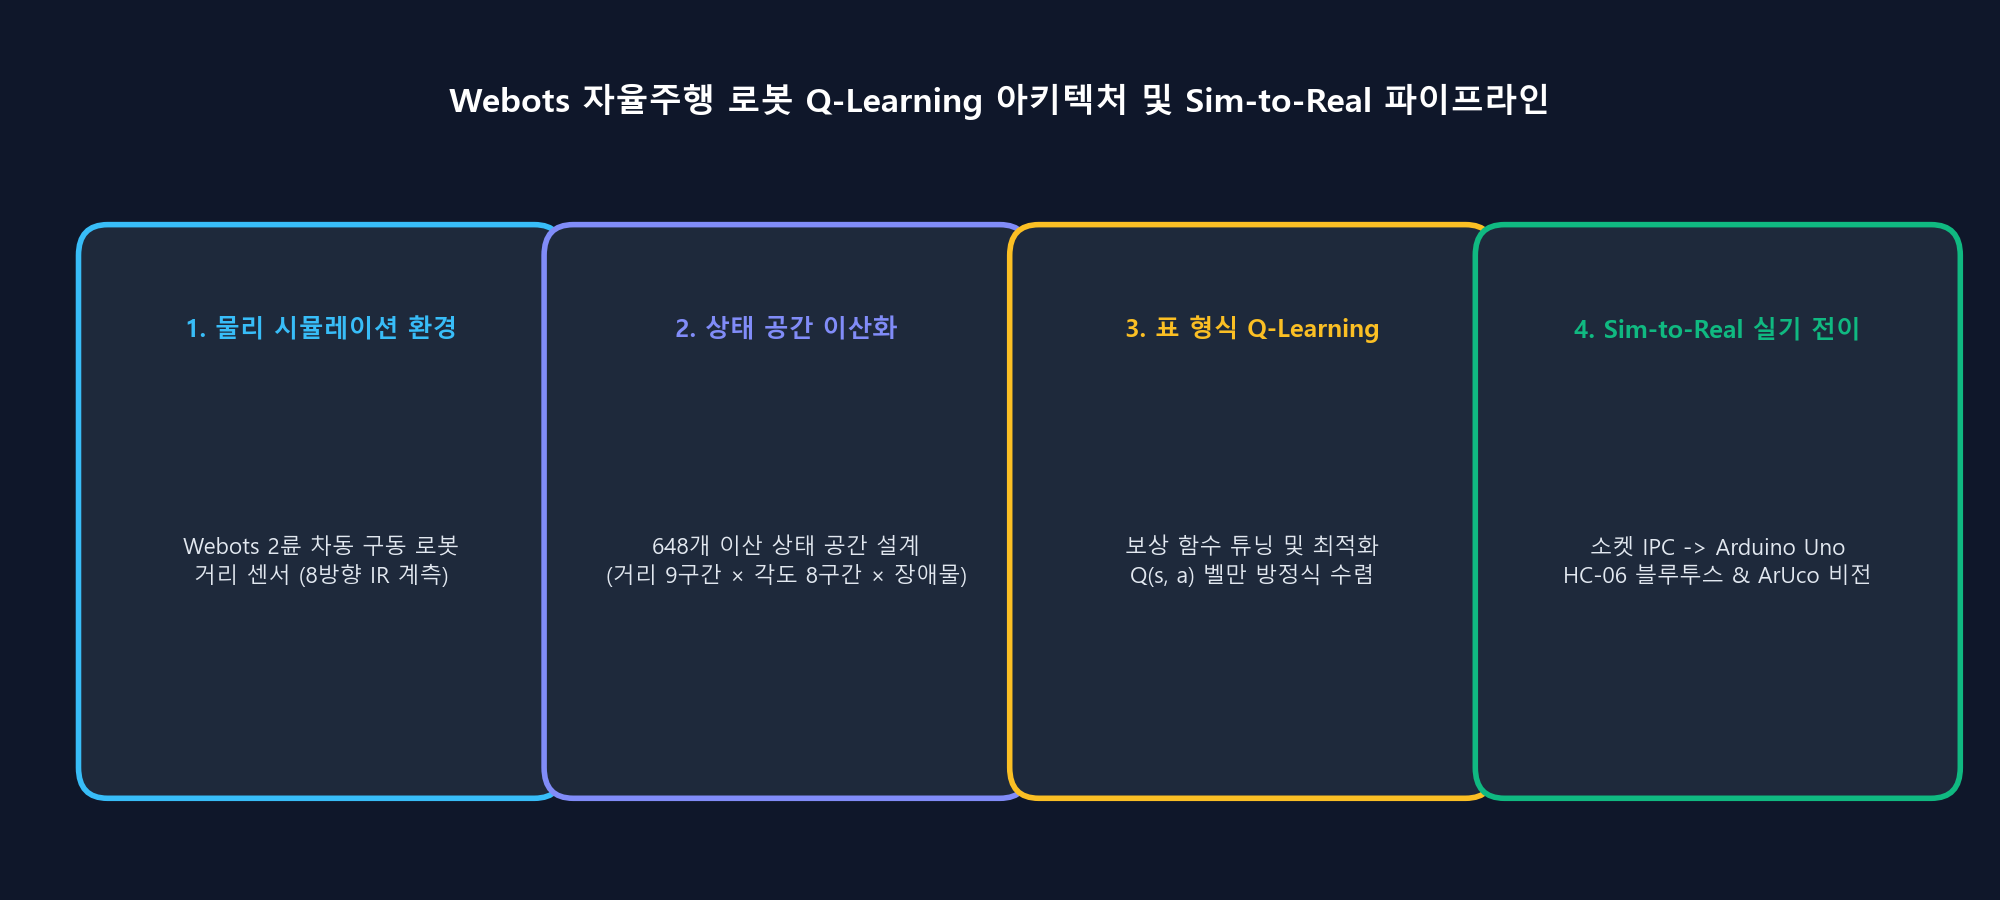
- 해결(Solution): 5차원 연속 센서 입력을 기하학적·물리적 의미를 가진 구간으로 분할하여 3 × 8 × 3 × 3 × 3 = 648개의 이산 상태(Bin)로 매핑(
discretizer.py)하고, TCP 로컬 소켓(Port 5000, Line-delimited JSON) 기반의 IPC 제어 파이프라인 구축.- 결과(Result): O(1)의 초고속 Q-Table 갱신 속도를 확보하고, 시뮬레이션 물리 스텝(32ms)에 맞춘 안정적인 동기화 루프 완성.
1. 프로젝트 배경: 왜 Webots와 Q-Learning인가?
자율주행 로봇이 미지의 실내 환경에서 장애물을 회피하며 목표 지점(Target Goal)에 도달하도록 만드는 것은 로보틱스의 고전적이면서도 까다로운 문제입니다. 심층 강화학습(DQN, PPO 등)은 복잡한 환경에 유연하게 대응할 수 있지만, 학습에 막대한 연산 자원이 소모되고 모델 가중치의 해석 가능성(Interpretability)이 낮다는 한계가 있습니다.
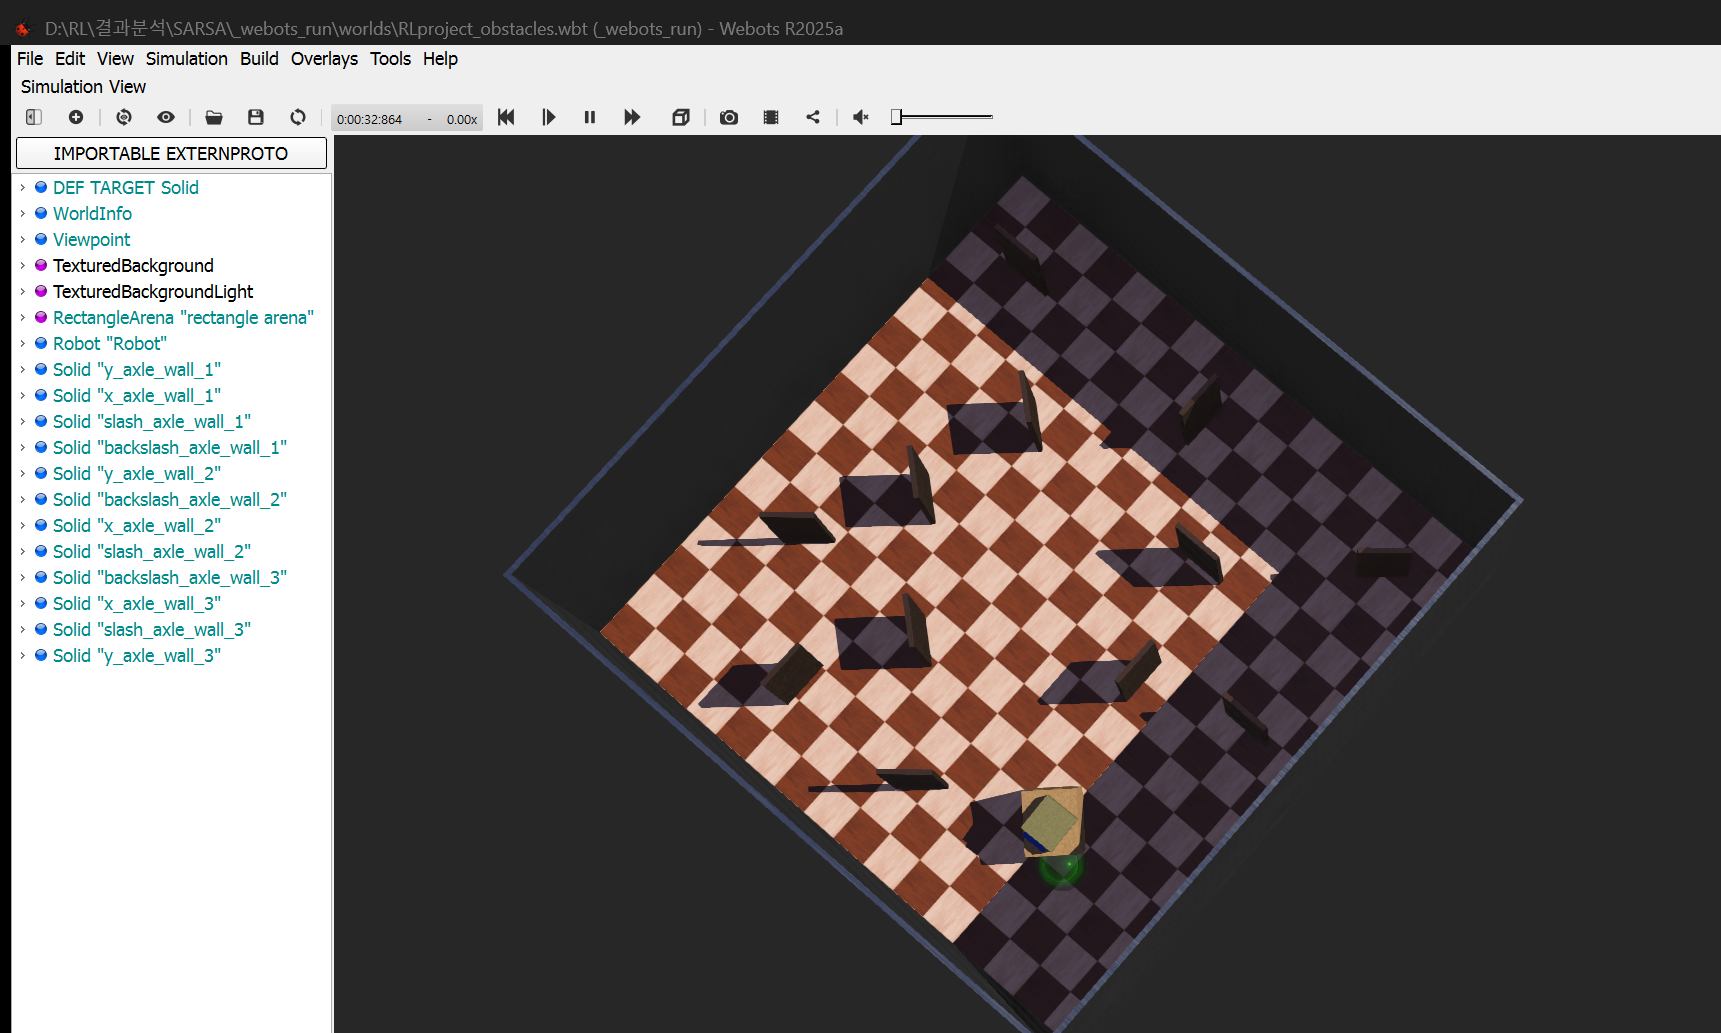
본 프로젝트에서는 **가장 직관적이면서도 수학적 수렴성이 검증된 표 기반 강화학습(Tabular Q-Learning, Off-policy TD(0))**을 Webots 물리 시뮬레이터 상의 차동 구동(Differential-drive) 모바일 로봇에 적용하여, 1.2m × 1.2m 실내 아레나에서 안정적인 목표 탐색 및 충돌 회피 정책을 달성하는 것을 목표로 설정했습니다.
2. 전체 시스템 아키텍처 (Webots ↔ Python IPC)
시스템은 크게 **시뮬레이션 물리 환경을 담당하는 Webots 컨트롤러(Server)**와 **강화학습 알고리즘을 수행하는 Python 클라이언트(Client)**로 물리적·논리적으로 분리되어 동작합니다.
flowchart LR
    subgraph Webots["Webots 3D Simulator (localhost:5000)"]
        Robot["Supervisor Robot<br>(초음파 센서 + 모터)"]
        HeadScan["헤드스캔 기구부<br>(좌/우 1.1 rad 회전)"]
        Server["TCP Socket Server<br>(Line-delimited JSON)"]
        Robot -→ HeadScan -→ Server
    end

    subgraph Python["Python RL Engine (Client)"]
        Env["WebotsEnv (gym-like)<br>reset() / step()"]
        Disc["Discretizer<br>(연속값 → 0~647 Bin)"]
        Agent["QLearningAgent<br>(Q-Table 648x4)"]
        Env -→ Disc -→ Agent
    end

    Server <-→|"request: {type: step, action: 0..3}<br>response: {state: [...], reward, done}"| Env
- Webots 컨트롤러 (
RL_controller.py): Webots의SupervisorAPI를 활용하여 매 액션 스텝마다 로봇 바퀴를 480ms(15 ticks × 32ms) 동안 구동하고, 서보 모터로 헤드를 좌우 1.1 rad 회전시켜 장애물 거리를 정밀 스캔합니다. - 통신 프로토콜: 소켓 통신 시 오버헤드를 최소화하기 위해 줄바꿈 구분자 기반의 JSON(Line-delimited JSON)을 사용합니다.
- 요청:
{"type": "step", "action": 0}(0: 전진, 1: 후진, 2: 좌회전, 3: 우회전) - 응답:
{"state": [0.45, 0.12, 0.35, 0.28, 0.40], "reward": 0.05, "done": false, "info": {...}}
- 요청:
3. 연속 센서의 648개 이산 상태 공간(Bin) 설계
초음파 센서와 목표점 간의 위치 데이터는 연속 실수(Float) 값이므로, 표 기반 Q-Learning을 적용하려면 이를 **유한한 정수 상태 인덱스(State Index)**로 변환해야 합니다.
임의로 균등 분할할 경우 상태 수가 기하급수적으로 폭발(Curse of Dimensionality)하므로, 로봇의 기하학적 주행 특성에 맞추어 5가지 핵심 관측 변수를 정의하고 아래와 같이 세심하게 구간을 분할했습니다.
| 관측 변수 | 구간 수 | 분할 기준 (Thresholds) | 물리적 의미 |
|---|---|---|---|
목표 거리 (goal_distance) | 3 | [0.6m, 1.2m] | 근거리(Near), 중거리(Mid), 원거리(Far) |
목표 상대각도 (goal_heading) | 8 | [-π, π] 균등 8등분 (각 45°) | 전방, 전우, 우, 후우, 후방, 후좌, 좌, 전좌 |
전방 장애물 (front_distance) | 3 | [0.15m, 0.30m] | 위험/충돌임박, 주의/접근, 안전 |
좌측 장애물 (left_distance) | 3 | [0.15m, 0.30m] | 위험, 주의, 안전 |
우측 장애물 (right_distance) | 3 | [0.15m, 0.30m] | 위험, 주의, 안전 |
총 상태 공간 크기: N_states = 3 × 8 × 3 × 3 × 3 = 648
이로 인해 Q-Table의 크기는 단 648 × 4 = 2,592개의 파라미터로 극적으로 압축되었으며, 일반 PC 메모리에서 수 밀리초 내에 인덱싱이 가능해졌습니다.
💻 상태 변환 구현 코드 (discretizer.py)
import numpy as np

# 상태 차원 정의
N_GOAL_D, N_GOAL_H, N_FRONT, N_LEFT, N_RIGHT = 3, 8, 3, 3, 3
N_STATES = N_GOAL_D * N_GOAL_H * N_FRONT * N_LEFT * N_RIGHT  # 648

# 임계값 정의
_HEADING_BINS = np.linspace(-np.pi, np.pi, 9)[1:-1] # 8분할 경계
_NEAR_BINS    = np.array([0.15, 0.30])               # 초음파 안전/주의/위험 경계
_DIST_BINS    = np.array([0.6, 1.2])                 # 목표 거리 경계

def discretize(state_dict: dict) → int:
    """5차원 실수 관측값을 0~647 사이의 정수 인덱스로 변환"""
    gd = int(np.digitize(state_dict["goal_distance"], _DIST_BINS))
    gh = int(np.digitize(state_dict["goal_heading"], _HEADING_BINS))
    df = int(np.digitize(state_dict["front_distance"], _NEAR_BINS))
    dl = int(np.digitize(state_dict["left_distance"], _NEAR_BINS))
    dr = int(np.digitize(state_dict["right_distance"], _NEAR_BINS))

    # 다차원 인덱스를 1차원 평탄화(Flatten) 인덱스로 변환
    index = ((((gd * N_GOAL_H + gh) * N_FRONT + df) * N_LEFT + dl) * N_RIGHT + dr)
    return int(index)
4. 헤드스캔(Head-Scan) 메커니즘과 충돌 판정
일반적인 2륜 로봇은 전방에 센서가 고정되어 있어 좌우 측면의 사각지대 장애물을 감지하기 어렵습니다. 이를 극복하기 위해 컨트롤러에 헤드스캔(Head-Scan) 메커니즘을 탑재했습니다.
- 액션 실행: 바퀴 모터를 3.0 rad/s 속도로 480ms 동안 구동.
- 헤드 회전: 서보 모터를 좌측으로 +1.1 rad (약 63°) 회전하여 좌측 거리 측정 후, 우측으로 -1.1 rad 회전하여 우측 거리를 측정.
- 정위치 복귀: 다시 정면(0 rad)으로 복귀하여 전방 거리를 최종 갱신.
- 종료 판정:
- 목표 도달: 목표물과의 유클리드 거리가 $0.10m$ 이하일 때 $\rightarrow$ 성공 (
done = True, 보상 $+1.0$) - 벽 충돌: 전방/좌/우 거리 중 하나라도 $0.08m$ 이하로 떨어질 때 $\rightarrow$ 실패 (
done = True, 보상 $-1.0$)
- 목표 도달: 목표물과의 유클리드 거리가 $0.10m$ 이하일 때 $\rightarrow$ 성공 (
5. 다음 편 예고
이번 1회차에서는 강화학습 에이전트가 주행을 시작하기 위한 Webots 가상 환경 구축, TCP 소켓 기반 IPC 인터페이스, 648개 상태 공간 이산화 기법을 정리했습니다.
다음 2회차 포스팅에서는 본격적으로 Tabular Q-Learning 수식 구현, ε-Greedy 감쇠 탐색 전략, 그리고 시뮬레이션 환경에서의 보상 함수(Reward Function) 튜닝 과정을 다루겠습니다!