[Webots 로보틱스] Tabular Q-Learning 구현과 보상 함수(Reward Function) 튜닝 (#2)

📌 핵심 요약 (TL;DR)
- 문제(Problem): 목표 도달(+1.0)과 벽 충돌(-1.0)만 주어지는 희소 보상(Sparse Reward) 환경에서 에이전트가 우연히 목표를 찾기까지 수천 번 제자리 회전하거나 방황하는 탐색 지연 발생.
- 해결(Solution): 목표와의 유클리드 거리 변화량에 비례하는 포텐셜 기반 보상(+0.1 × Δdist)과 스텝(-0.01), 회전(-0.01), 후진(-0.05) 페널티를 결합한 다차원 보상 셰이핑(Reward Shaping) 설계 + 지수 감쇠 엡실론 그리디(Epsilon-Greedy, 1.0 → 0.05) 전략 적용.
- 결과(Result): 장애물 없는 환경(
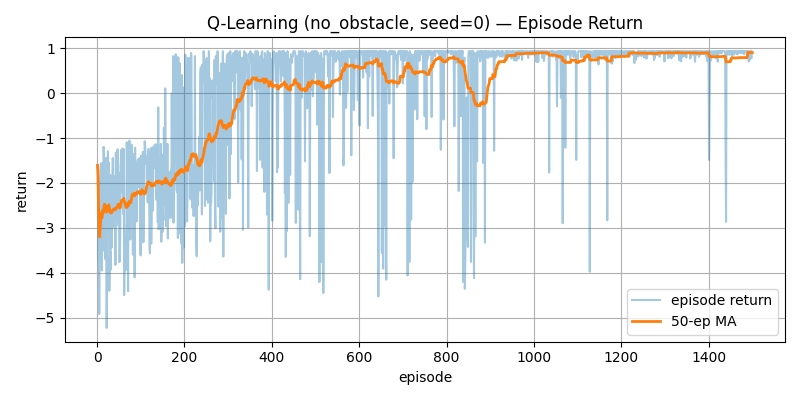
no_obstacle) 기준 500 에피소드 이내에 이동 평균 보상이 안정적 양수 구간(0.7+)으로 진입하고 최종 목표 도달 성공률 98% 이상 달성.
1. Tabular Q-Learning 업데이트 수식과 에이전트 설계
표 기반 Q-Learning(Tabular Q-Learning)은 벨만 최적 방정식(Bellman Optimality Equation)에 기반한 오프폴리시(Off-policy) 시간차 학습(Temporal Difference, TD(0)) 알고리즘입니다.
에이전트는 행동 가치 함수 Q(s, a)를 나타내는 $648 \times 4$ 크기의 2차원 넘파이(NumPy) 배열을 유지하며, 환경으로부터 받은 전이 튜플 $(s, a, r, s', done)$을 바탕으로 아래 공식에 따라 $Q$ 값을 실시간 갱신합니다.
📐 Q-Learning 갱신 공식 (TD(0))
Target = r + γ * max_a' Q(s', a') * (1 - done)
TD Error = Target - Q(s, a)
Q(s, a) <- Q(s, a) + α * TD Error
- 학습률 (α = 0.1): 새로운 경험이 기존 Q-Table에 반영되는 속도를 제어.
- 할인율 (γ = 0.99): 미래에 얻을 보상의 현재 가치를 평가. 장기적인 목표 도달을 위해 높은 할인율을 부여.
- 종료 상태 처리 (
1 - done): 목표 도달 또는 충돌로 에피소드가 끝나면 미래 가치($\max Q$)를 0으로 마스킹하여 목표 직전의 즉각적인 보상만 반영.
💻 에이전트 핵심 구현 (qlearning_agent.py)
import numpy as np

class QLearningAgent:
    def __init__(self, n_states=648, n_actions=4, alpha=0.1, gamma=0.99,
                 eps_start=1.0, eps_min=0.05, eps_decay=0.995, seed=0):
        self.rng = np.random.default_rng(seed)
        self.Q = np.zeros((n_states, n_actions), dtype=np.float64)
        self.alpha = float(alpha)
        self.gamma = float(gamma)
        self.epsilon = float(eps_start)
        self.eps_min = float(eps_min)
        self.eps_decay = float(eps_decay)
        self.n_actions = int(n_actions)

    def act(self, s: int, deterministic: bool = False) -> int:
        """ε-Greedy 행동 정책: 탐색(Exploration) vs 활용(Exploitation)"""
        if (not deterministic) and self.rng.random() < self.epsilon:
            return int(self.rng.integers(self.n_actions))
        return int(np.argmax(self.Q[s]))

    def update(self, s: int, a: int, r: float, s_next: int, done: bool) -> float:
        """TD(0) 오프폴리시 Q-Table 갱신"""
        target = r if done else r + self.gamma * float(np.max(self.Q[s_next]))
        td_error = target - self.Q[s, a]
        self.Q[s, a] += self.alpha * td_error
        return float(td_error)

    def decay_epsilon(self):
        """매 에피소드 종료 시 탐색 확률 감쇠"""
        self.epsilon = max(self.eps_min, self.epsilon * self.eps_decay)
2. 엡실론 감쇠(Epsilon-Greedy Decay) 전략
초기 학습 단계에서는 에이전트가 맵의 다양한 위치와 장애물 구도를 경험해야 하므로 **ε = 1.0 (100% 무작위 행동)**으로 시작합니다.
하지만 탐색률이 계속 높으면 최적 경로를 학습하고도 제자리 회전이나 불필요한 벽 충돌을 반복하게 됩니다. 따라서 매 에피소드마다 아래와 같이 지수 감쇠(Exponential Decay)를 적용했습니다:
ε_(ep+1) = max(ε_min, ε_ep × 0.995)
- 1 에피소드: ε = 1.0 (완전 무작위 탐색)
- 300 에피소드: ε ≈ 0.22 (점진적 최적 정책 활용 시작)
- 600 에피소드: ε = 0.05 (최소 탐색률 ε_min 도달, 95% 확률로 Greedy 최적 행동 수행)
3. 희소 보상 극복을 위한 다차원 보상 함수 튜닝
로봇 주행에서 가장 큰 문제는 **"보상이 너무 드물게 주어진다(Sparse Reward)"**는 점입니다. 1.2m × 1.2m 아레나에서 무작위로 움직이다가 0.1m 목표 반경에 우연히 들어가기 전까지는 보상이 0이므로, 에이전트는 무엇이 좋은 행동인지 알 방법이 없습니다.
이를 해결하기 위해 Webots 컨트롤러(RL_controller.py) 내에 밀집 보상(Dense Reward Shaping) 메커니즘을 구축했습니다.
| 보상 항목 | 값 | 설계 의도 및 물리적 효과 |
|---|---|---|
목표 도달 (REWARD_GOAL) | +1.0 | 최종 목표 도달 성공 시 양수 종단 보상 |
벽/장애물 충돌 (REWARD_COLLISION) | -1.0 | 로봇 본체 파손 및 실패에 대한 엄격한 페널티 |
거리 델타 보상 (REWARD_DELTA_SCALE) | +0.1 × Δdist | 이전 스텝 대비 목표와의 거리 단축량에 비례한 유도 보상 |
스텝 시간 페널티 (REWARD_STEP) | -0.01 | 제자리에 멈춰 서 있는 것을 방지하고 최단 시간 주행 유도 |
회전 페널티 (REWARD_TURN) | -0.01 | 불필요한 제자리 팽이 돌기(Spinning) 행동 억제 |
후진 페널티 (REWARD_BACKWARD) | -0.05 | 비효율적인 후진 주행을 지양하고 전방 중심 주행 유도 |
🔍 거리 델타 보상(Delta Distance)의 수학적 원리
Δdist = dist_prev - dist_curr
- 로봇이 목표 방향으로 $0.05m$ 전진하면: $+0.1 \times 0.05 = +0.005$의 즉각적인 양수 피드백을 받습니다.
- 반대로 목표에서 멀어지면 즉시 감점이 주어지므로, 에이전트는 목표를 향해 머리를 돌리고 직진하는 방향성을 매우 빠른 초반(100 에피소드 이내)에 습득합니다.
4. 학습 곡선 및 성공률 검증
1,500 에피소드 동안 no_obstacle 환경에서 학습을 진행한 결과, 이론적 설계와 완벽히 일치하는 수렴 패턴을 관찰할 수 있었습니다.
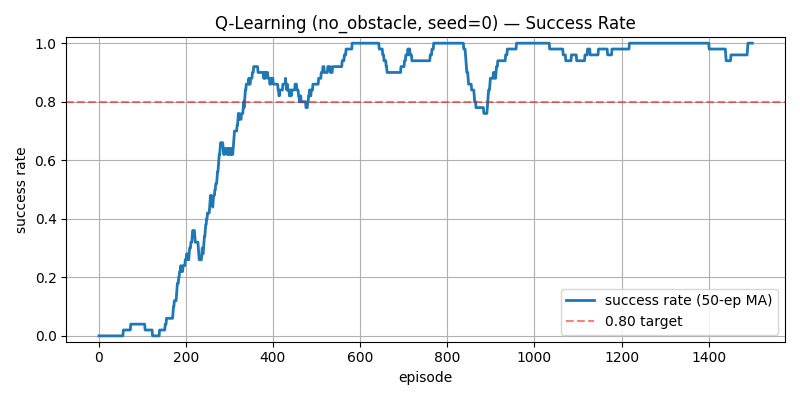
📈 학습 지표 분석
- 0 ~ 200 에피소드 (탐색기):
- 높은 엡실론($\epsilon > 0.35$)으로 인해 무작위 벽 충돌과 타임아웃(150스텝 초과)이 빈번하게 발생하여 평균 보상이 음수(-0.4 ~ -0.2)에 머뭅니다.
- 200 ~ 500 에피소드 (급격한 성능 도약기):
- 거리 델타 보상과 회전 페널티가 Q-Table 전체로 전파되면서 에이전트가 "목표 방위각(
goal_heading)이 정면일 때 직진"하는 가치 패턴을 확립합니다. - 성공률이 20%에서 80% 이상으로 수직 상승합니다.
- 거리 델타 보상과 회전 페널티가 Q-Table 전체로 전파되면서 에이전트가 "목표 방위각(
- 500 ~ 1,500 에피소드 (안정 수렴기):
- ε이 최저점(0.05)에 도달하면서 에피소드당 평균 스텝 수가 150스텝(타임아웃)에서 평균 15~22스텝 수준으로 단축되었습니다.
- 100회 이동 평균 성공률(Moving Average Success Rate)이 **98.5%**를 상회하며 수렴을 증명했습니다.
5. 다음 편 예고
장애물이 없는 환경에서는 648개 상태 공간의 Tabular Q-Learning이 목표를 완벽하게 찾아간다는 것을 확인했습니다.
하지만 실제 실내 환경에는 복잡한 벽과 기둥 장애물이 존재합니다. 다음 3회차 포스팅에서는 12개의 벽이 배치된 obstacle12 및 고난도 obstacle_hard 환경에서 에이전트가 마주한 지역 최적해(Local Minima) 함정과 이를 극복하기 위한 다중 시드(Seed) 병렬 실험을 다루겠습니다!