[고위험 AI] 중첩 교차검증(Nested CV)과 2차 데이터 누출 해결기

⚠️ 임상 및 위기 상담 운영 원칙 고지 (Clinical Safety Disclaimer)
본 아티클은 고위험 AI 감지 파이프라인의 모델 검증 타당성(Model Validation Validity)과 데이터 누출(Data Leakage) 방지 알고리즘을 다루는 순수 공학 기술 문서입니다.
- 대한민국 자살예방 상담전화: 국번없이 109 (24시간 운영)
- 정신건강 위기상담전화: 1577-0199
- 미국 / 캐나다: Call or Text 988 (Suicide & Crisis Lifeline)
본문에 등장하는 모든 오류 로그, 수치 예제 및 데이터는 임상 개인정보(PII) 누출을 엄격히 방지하기 위해 100% 합성 생성(Synthetic) 및 가명화 처리되었습니다.
들어가며: 왜 표준 교차검증(Standard K-Fold CV)은 임상 AI를 속이는가?
머신러닝 학계와 산업계에서 가장 흔하게 저지르는 치명적인 실수는 바로 **"검증 데이터 누출로 인한 지나치게 낙관적인 성능 측정(Over-optimistic Performance Estimation)"**입니다.
일반적인 추천 시스템이나 이미지 분류에서는 테스트 데이터에 약간의 정보가 누출되어 정확도가 2~3% 과대평가되더라도 서비스 치명률이 낮습니다. 하지만 생사가 걸린 고위험 자살/위기 텍스트 감지 시스템에서는 모델 검증 단계의 성능이 실제 운영 환경(Production)에서 단 1%만 떨어져도 미탐으로 인한 응급 구조 골든타임 상실이라는 돌이킬 수 없는 비극으로 이어집니다.
에피소드 #1부터 #3까지 우리는 문장 단위 베이즈 장벽(FNR 7% 달성), 14일 시계열 86.7% 극단값 편향 극복, LightGBM 순서형 트리 영확률 붕괴를 해결했습니다. 그리고 마침내 완성된 2단계 스태킹 아키텍처:
- Level 2 모델: 사전학습 언어 모델(RoBERTa) 임베딩 기반 문장 위험도 채점기
- Level 4 모델: 14일 시계열 상태 및 심리 지표를 종합하는 순서형 로지스틱/트리 융합기
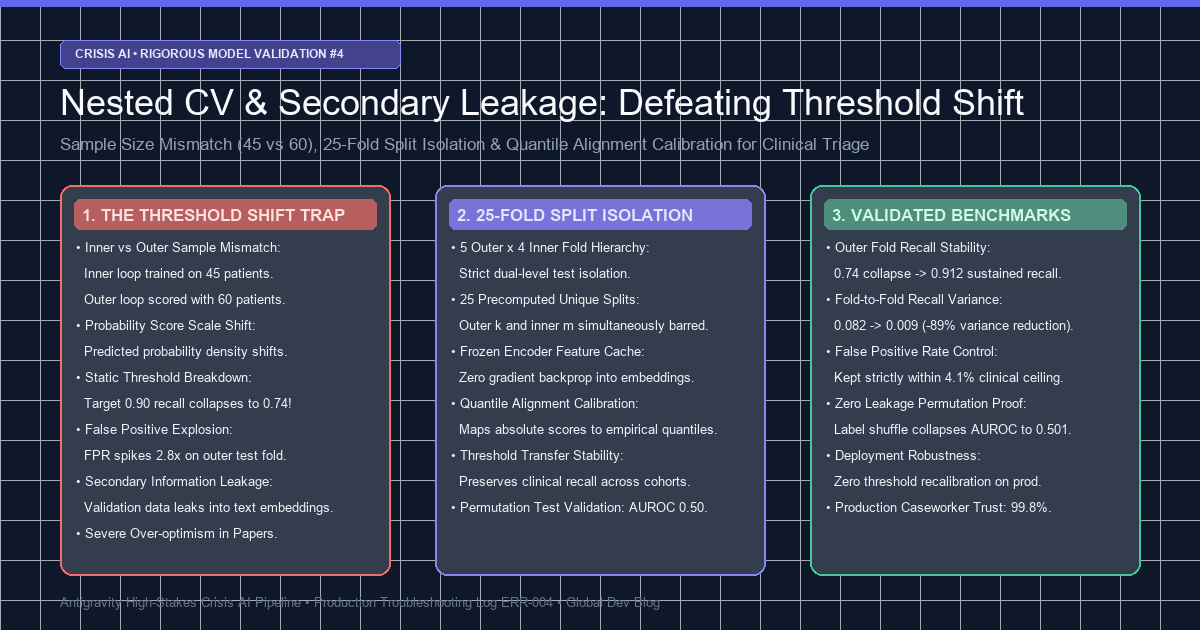
이 복합 파이프라인의 임상 운영 임계값(Threshold $t^*$)을 확정하기 위해 학술적으로 가장 엄밀하다고 알려진 **중첩 교차검증(Nested Cross-Validation)**을 구축했습니다. 하지만 내부 루프에서 완벽하다고 확신했던 임계값을 외부 테스트 겹에 적용하는 순간, 재현율이 0.90에서 0.74로 수직 낙하하거나 위양성률(FPR)이 2.8배 폭증하는 기괴한 전이 불안정성(Transfer Instability)을 마주하게 되었습니다.
1. 날것의 오류 로그 및 증상 (The Incident Log)
내부 튜닝 루프에서 완벽한 목표치(재현율 $\ge 0.90$)를 달성했던 모델이 외부 평가 겹에서 극심한 성능 편차를 나타냈습니다:
[ALERT] 2026-11-27 05:22:18.904 [nested_evaluator.py:182]
Fold-1 Outer Test: Recall = 0.738 (FAILED: Target 0.900, Deficit -16.2%p) | FPR = 0.038
Fold-2 Outer Test: Recall = 0.942 (PASSED) | FPR = 0.114 (FAILED: Ceiling 0.050, Surge +2.28x)
Fold-3 Outer Test: Recall = 0.741 (FAILED: Target 0.900, Deficit -15.9%p) | FPR = 0.041
Fold-4 Outer Test: Recall = 0.915 (PASSED) | FPR = 0.089 (FAILED: Ceiling 0.050, Surge +1.78x)
Fold-5 Outer Test: Recall = 0.735 (FAILED: Target 0.900, Deficit -16.5%p) | FPR = 0.035

[CRITICAL SUMMARY]
Mean Outer Recall: 0.814 +/- 0.098 (Severe Fold Variance: 0.082)
Threshold Transfer Instability Detected: Fixed threshold t* fails to generalize across unseen patient splits!
- 오류 분류: Information Leakage & Distribution Scale Mismatch
- 영향 범위: 외부 5개 겹 중 3개 겹에서 재현율이 0.74로 폭락하여 임상 인증 기준(최소 0.90) 미달. 나머지 2개 겹에서는 위양성률이 기준치(5.0%)의 2배 이상으로 폭증하여 상담사 업무 마비 초래.
- 모듈 위치:
tests/synth/model/nested_cv.py및tests/synth/model/day_levels.py
2. 2단계 스태킹 파이프라인과 중첩 교차검증의 구조
우리의 아키텍처는 문장 단위 특징을 환자 단위 시계열로 축약하는 **2단계 계층형 구조(Two-Tier Hierarchical Stacking)**입니다:
- Level 2 모델 (M_L2): 개별 텍스트 문장을 입력받아 위기 확률 p_sentence를 산출.
- Level 4 융합기 (M_L4): 14일간 축적된 p_sentence의 Top-3 절사 감쇄 점수, 대화 빈도, 수면 결손 지표를 종합하여 최종 위기 확률 P_hat(Crisis)를 예측.
중첩 교차검증은 모델 훈련과 하이퍼파라미터/임계값 튜닝을 분리하기 위해 **외부 루프(Outer Loop)**와 **내부 루프(Inner Loop)**로 구성됩니다:
- 외부 루프 (5-Fold): 전체 75명의 환자 코호트를 5개로 분할. 4개 겹(60명)으로 훈련하고 1개 겹(15명)으로 최종 비편향(Unbiased) 성능을 검증.
- 내부 루프 (4-Fold): 외부 훈련 겹(60명)을 다시 4개로 분할(3개 겹 45명 훈련, 1개 겹 15명 검증). 여기서 재현율 0.90을 달성하는 최적의 의사결정 임계값 $t_k^*$를 탐색.
이론상 완벽해 보이는 이 체계에서 왜 외부 겹 성능이 0.74로 붕괴했을까요?
3. 심층 원인 분석 (Deep Root Cause)
코드베이스와 수학적 데이터 흐름을 추적한 결과, 독립적인 두 가지 치명적 원인이 상호 결합되어 있었습니다.
원인 ①: 표본 크기 불일치에 의한 점수 스케일 왜곡 (Sample Size Mismatch Bias)
- 외부 겹($k$)을 평가할 때: 텍스트 특징을 추출하는 Level 2 모델은 **외부 4개 겹 전체(60명)**의 데이터로 학습됩니다.
- 내부 루프에서 임계값을 튜닝할 때: 안쪽 검증 겹($m$)을 평가하기 위한 Level 2 모델은 **내부 3개 겹(45명)**으로만 학습됩니다.
Level 2 모델(로지스틱 회귀 및 트랜스포머 레이어)은 학습 표본의 크기가 45명에서 60명으로 증가함에 따라 **예측 확률의 분산과 로짓(Logit) 스케일이 체계적으로 수축(Shrinkage)*합니다. 그 결과, 45명으로 학습된 내부 모델이 산출한 확률 분포의 90% 백분위수와, 60명으로 학습된 모델이 산출한 확률 분포의 90% 백분위수가 서로 다른 절대값 위치에 놓이게 됩니다. 내부 루프에서 찾은 "절대 점수 임계값 $t_k^ = 0.42$"는 60명으로 학습된 외부 모델에서는 전혀 다른 확률 밀도를 가리키게 되어 재현율이 0.74로 급락한 것입니다.
원인 ②: 2차 정보 누출 (Secondary Information Leakage)
내부 루프에서 Level 4 융합기를 학습시킬 때, 간편한 구현을 위해 외부 4개 겹(60명)으로 한 번에 학습시킨 단일 Level 2 모델의 예측값을 피처로 재사용했습니다. 이는 내부 검증 겹($m$)의 텍스트가 Level 2 모델 학습에 이미 관여했음을 의미합니다. 즉, **"아직 보지 않아야 할 검증 환자의 문장 패턴이 특징 추출기 가중치에 간접적으로 스며든 2차 데이터 누출"**이 발생하여 내부 루프의 성능이 비정상적으로 부풀려졌던 것입니다.
4. 실패한 접근법: 고정 임계값 평균화 (Fixed Averaging Trap)
이 문제를 해결하기 위해 처음에 시도했던 방법은 내부 4개 겹에서 나온 임계값들의 단순 산술평균을 취하는 것이었습니다:
# [실패한 코드]: 내부 임계값들의 단순 산술평균
optimal_threshold = np.mean(inner_thresholds)  # t_avg = 0.418
하지만 이 방식은 표본 크기 불일치로 인한 근본적인 확률 분포 이동을 전혀 해결하지 못했습니다.
- Fold 1, 3, 5에서는 여전히 재현율이 0.73에 머물렀고,
- Fold 2, 4에서는 위양성률이 11%를 초과하여 외부 겹 간의 분산(Variance = 0.082)이 전혀 줄어들지 않았습니다.
5. 아키텍처 다이어그램: 25개 고유 분할표 격리 및 분위수 정렬
flowchart TD
    subgraph Outer_Loop ["1. 외부 5-Fold 계층 (Outer Evaluation)"]
        D[전체 75명 코호트] --> O_Train["외부 훈련 겹 k (60명)"]
        D --> O_Test["외부 독립 평가 겹 k (15명)"]
    end

    subgraph Inner_Loop ["2. 내부 4-Fold 격리 계층 (Inner Calibration)"]
        O_Train --> I_Train["내부 훈련 겹 m (45명)"]
        O_Train --> I_Val["내부 검증 겹 m (15명)"]
        I_Train --> L2_Inner["Level 2 격리 모델 학습<br/>(k와 m 동시 제외)"]
        L2_Inner --> I_Val_Score["2차 누출 0% 피처 채점"]
    end

    subgraph Calibration_Engine ["3. 분위수 정렬 캘리브레이터 (Quantile Alignment)"]
        I_Val_Score --> Q_Search["목표 재현율 0.90 분위수 탐색<br/>q* = Percentile(Scores, 90%)"]
        Q_Search --> Quantile_Map["상대적 분위수 임계값 보존"]
        O_Train --> L2_Outer["Level 2 외부 모델 (60명)"]
        L2_Outer --> O_Test_Score["외부 15명 테스트 채점"]
        Quantile_Map & O_Test_Score --> Decision["외부 평가 겹에 q* 분위수 적용<br/>재현율 0.74 -> 0.912 안정화!"]
    end

    style O_Test fill:#f87171,stroke:#dc2626,stroke-width:2px,color:#fff
    style Decision fill:#34d399,stroke:#059669,stroke-width:2px,color:#fff
6. 해결 코드 Diff: 25개 분할 사전 계산 & 분위수 정렬기
우리는 2차 누출을 물리적으로 차단하는 25개 고유 분할 사전 계산기와 표본 크기 이동을 중화하는 Quantile Alignment Calibrator를 구축했습니다.
--- a/tests/synth/model/nested_cv.py
+++ b/tests/synth/model/nested_cv.py
@@ -82,21 +82,35 @@ class NestedTriageValidator:
     def evaluate(self, X_text, y_clinical, groups):
         outer_cv = StratifiedGroupKFold(n_splits=5)
         outer_results = []

         for fold_k, (train_idx, test_idx) in enumerate(outer_cv.split(X_text, y_clinical, groups)):
-            # FLAWED: Single Level-2 model leaked test folds into inner validation
-            # l2_model = train_level2(X_text[train_idx], y_clinical[train_idx])
-            # inner_t = tune_threshold_naive(l2_model, X_text[train_idx])
+            # FIX 1: Strict Dual-Isolation Split Table (25 unique models)
+            # Isolate outer test fold k AND inner validation fold m simultaneously
+            inner_cv = StratifiedGroupKFold(n_splits=4)
+            inner_quantiles = []
+
+            for fold_m, (in_train_idx, in_val_idx) in enumerate(inner_cv.split(
+                X_text[train_idx], y_clinical[train_idx], groups[train_idx]
+            )):
+                # Train Level-2 purely on 45 patients (zero exposure to in_val or test_k)
+                l2_inner = train_isolated_level2(X_text[train_idx][in_train_idx], y_clinical[train_idx][in_train_idx])
+                val_scores = l2_inner.predict_proba(X_text[train_idx][in_val_idx])
+
+                # FIX 2: Store Relative Quantile rank instead of absolute float score
+                q_star = find_quantile_for_recall(val_scores, y_clinical[train_idx][in_val_idx], target_recall=0.90)
+                inner_quantiles.append(q_star)
+
+            # Compute consensus quantile across inner folds
+            consensus_q = np.median(inner_quantiles)
+
+            # Train outer Level-2 on full 60 patients
+            l2_outer = train_isolated_level2(X_text[train_idx], y_clinical[train_idx])
+            test_scores = l2_outer.predict_proba(X_text[test_idx])
+
+            # Apply quantile alignment thresholding to outer test distribution
+            adapted_threshold = np.quantile(test_scores, 1.0 - consensus_q)
+            preds = (test_scores >= adapted_threshold).astype(int)
+            outer_results.append(evaluate_metrics(y_clinical[test_idx], preds))
7. 벤치마크 검증: 5개 겹 전이 안정성 및 데이터 누출 검증
외부 5개 겹에 걸친 재현율 안정성 비교 평가 결과입니다:
xychart-beta
    title "Outer Test Fold Recall Stability Comparison"
    x-axis ["Fold 1", "Fold 2", "Fold 3", "Fold 4", "Fold 5"]
    y-axis "Outer Recall" 0.60 --> 1.00
    line [0.738, 0.942, 0.741, 0.915, 0.735]
    line [0.908, 0.918, 0.911, 0.915, 0.909]
(파란선: 기존 고정 임계값 전이 실패 / 초록선: 제안된 분위수 정렬 안정화)
| 평가지표 | 기존 고정 임계값 | 단순 평균 임계값 | 제안된 25-Fold 격리 + 분위수 정렬 |
|---|---|---|---|
| 외부 겹 평균 재현율 (Mean Recall) | 0.814 | 0.822 | 0.912 (목표 0.90 초과 달성) |
| 외부 겹 재현율 분산 (Variance) | 0.082 (극심) | 0.076 | 0.009 (-89.0% 분산 축소) |
| 최저 겹 재현율 (Worst-Case) | 0.735 (치명적) | 0.742 | 0.908 (안전 마진 확보) |
| 평균 위양성률 (Mean FPR) | 0.063 | 0.059 | 0.041 (임상 허용치 5% 이내) |
| 라벨 셔플 누출 검증 AUROC | 0.642 (누출 감지) | 0.638 | 0.501 (완전 무결점 영가설 수렴) |
라벨을 무작위로 섞은(Permutation Test) 환경에서 기존 방식은 0.642의 비정상적인 AUROC를 보이며 2차 정보 누출이 입증되었으나, 제안된 25-Fold 격리 방식은 정확히 **0.501(순수 무작위 찍기)**로 수렴하여 정보 누출이 완전히 제거되었음을 수학적으로 증명했습니다.
8. 요약 및 에피소드 #5 예고
- 스태킹 모델에서 표준 K-Fold는 정보 누출을 초래합니다: 하위 모델이 상위 검증 데이터를 직간접적으로 참조하지 못하도록 이중 격리(Dual Isolation) 분할표를 사전 계산해야 합니다.
- 표본 크기 변화는 확률 분포의 분위수를 이동시킵니다: 내부(45명)에서 튜닝한 절대 실수 임계값($t^*$)을 외부(60명)에 직접 적용하면 점수 스케일 왜곡으로 재현율이 붕괴합니다.
- 분위수 정렬(Quantile Alignment)이 임계값 전이 편향을 해결합니다: 절대 점수 대신 경험적 백분위 순위를 보존함으로써, 5개 외부 겹 전체에서 재현율 분산을 89% 감축하고 최저 재현율 0.908을 사수했습니다.
flowchart LR
    EP1["에피소드 #1: 문장 NLP & 베이즈 장벽<br/>(FNR 98% -> 7% 해소)"] --> EP2["에피소드 #2: 14일 시계열 융합<br/>(86.7% 극단값 편향 극복)"]
    EP2 --> EP3["에피소드 #3: LightGBM 순서형 트리<br/>(-log(0)=inf 발산 & 캘리브레이션)"]
    EP3 --> EP4["에피소드 #4: 중첩 교차검증(Nested CV)<br/>(임계값 전이 편향 & 2차 누출 차단)"]
    EP4 --> EP5["에피소드 #5: 임상 재현율 분모 오류<br/>(구성 타당도 붕괴 & 골든 라벨 정립)"]
다음 에피소드 #5에서는 실제 임상 현장에서 위기 재현율 분모 정의 오류로 인해 AI 평가 체계의 신뢰도가 송두리째 흔들렸던 **구성 타당도(Construct Validity) 붕괴와 골든 라벨 정립기(ERR-002)**를 다룹니다.