[고위험 AI] LightGBM 순서형 트리와 영확률 붕괴(-log(0)=inf) 해결법

⚠️ 임상 및 위기 상담 운영 원칙 고지 (Clinical Safety Disclaimer)
본 아티클은 고위험 AI 감지 파이프라인의 수치 안정성(Numerical Stability)과 순서형 확률 캘리브레이션(Ordinal Probability Calibration) 알고리즘을 다루는 순수 공학 기술 문서입니다.
- 대한민국 자살예방 상담전화: 국번없이 109 (24시간 운영)
- 정신건강 위기상담전화: 1577-0199
- 미국 / 캐나다: Call or Text 988 (Suicide & Crisis Lifeline)
본문에 등장하는 모든 오류 로그, 수치 예제 및 데이터는 임상 개인정보(PII) 누출을 엄격히 방지하기 위해 100% 합성 생성(Synthetic) 및 가명화 처리되었습니다.
들어가며: 왜 다중 분류(Multiclass Softmax)는 고위험 임상에서 실패하는가?
에피소드 #1에서는 524배 베이즈 사전확률 장벽을 극복하여 문장 단위 위기 미탐율(FNR)을 98.3%에서 7.6%로 끌어내렸고, 에피소드 #2에서는 14일 시계열 슬라이딩 윈도우에서 단순 max() 집계로 인해 86.7%까지 폭증하던 허위 경보(Extreme Value Bias)를 'Top-3 절사 감쇄 융합기'로 3.2%까지 진압했습니다.
하지만 파이프라인의 최종 단계인 **레벨 4 멀티모달 상태 융합기(Level 4 Multimodal State Fuser)**에서 상담사에게 전달될 '위기 심각도 단계'를 최종 판정할 때 또 다른 치명적인 머신러닝 수학적 난관에 부딪혔습니다.
임상 위기 단계는 명확한 **자연적 순서(Natural Ordering)**를 가집니다:
- Level 0 (정상 / 일상 대화)
- Level 1 (단순 우울 및 심리적 고통)
- Level 2 (자살 관념 - 구체적 계획 없음)
- Level 3 (중증 자살 위기 - 수단 탐색 및 계획 수립)
- Level 4 (급성 자살 시도 임박 - 즉각적인 112/119 출동 필요)
일반적인 딥러닝 다중 분류에 쓰이는 **소프트맥스 교차 엔트로피(Softmax Cross-Entropy)**는 클래스 간 대칭성(Symmetry)을 가정합니다. 즉, 모델이 Level 4(초응급) 환자를 Level 0(정상)으로 오분류했을 때 부과하는 페널티와, Level 1(경미)을 Level 2(관념)로 오분류했을 때 부과하는 페널티가 수학적으로 동일합니다. 이는 임상 안전 관점에서 절대 용납될 수 없는 치명적 결함입니다.
따라서 우리는 등급 간 순서적 페널티와 단조성을 보장하기 위해 머신러닝 학계의 표준인 Frank & Hall (2001) 누적 순서형 분류(Ordinal Cumulative Classification) 아키텍처를 LightGBM 기반으로 구현했습니다. 그러나 운영 환경 테스트 중 전체 모델 최적화 루프를 완전히 멈춰 세우는 영확률 붕괴(Zero-Probability Collapse)와 -log(0) = inf 발산 재앙을 맞닥뜨리게 되었습니다.
1. 날것의 오류 로그 및 이상 징후 (Production Incident Log)
모델 훈련 중 교차 검증 평가 파이프라인에서 다음 로그와 함께 프로세스가 강제 중단되었습니다:
[CRITICAL] 2026-11-26 03:14:22.812 [fuser_trainer.py:284]
Traceback (most recent call last):
  File "tests/synth/model/fuser.py", line 284, in evaluate_ordinal_cross_entropy
    loss = -np.mean(np.log(predicted_proba[np.arange(N), y_true]))
RuntimeWarning: divide by zero encountered in log
Loss Output: inf (Optimization Halts)
ValueError: Objective function returned NaN/Inf at iteration 412. Boosting terminated abnormally.
- 오류 분류: Runtime Warning & IEEE 754 Floating-Point Divergence (
-log(0) = inf) - 영향 범위: 10,000건의 합성 임상 코호트 데이터셋 훈련 중 412번째 부스팅 이터레이션에서 손실 함수 완전 발산 및 중단.
- 모듈 위치:
tests/synth/model/fuser.py내 누적 이진 확률 변환기(ordinal_binary_to_proba)
2. Frank & Hall 순서형 누적 모델의 작동 원리
Frank & Hall (2001) 방식은 5개 순서형 등급($K=5$)에 대해 총 $K-1 = 4$개의 독립적인 이진 분류기를 훈련시킵니다:
- 모델 1 ($M_1$): $P(y \ge 1)$ 예측 (Level 0 vs Level 1, 2, 3, 4)
- 모델 2 ($M_2$): $P(y \ge 2)$ 예측 (Level 0, 1 vs Level 2, 3, 4)
- 모델 3 ($M_3$): $P(y \ge 3)$ 예측 (Level 0, 1, 2 vs Level 3, 4)
- 모델 4 ($M_4$): $P(y \ge 4)$ 예측 (Level 0, 1, 2, 3 vs Level 4)
수학적 확률 공리에 따르면, 누적 확률은 반드시 **단조 감소(Monotonically Non-Increasing)**해야 합니다: $$P(y \ge 1) \ge P(y \ge 2) \ge P(y \ge 3) \ge P(y \ge 4)$$
각 개별 등급의 확률 $P(y=k)$는 이 누적 확률들의 차분(Difference)으로 계산됩니다:
- $P(y=0) = 1.0 - P(y \ge 1)$
- $P(y=1) = P(y \ge 1) - P(y \ge 2)$
- $P(y=2) = P(y \ge 2) - P(y \ge 3)$
- $P(y=3) = P(y \ge 3) - P(y \ge 4)$
- $P(y=4) = P(y \ge 4)$
이 방식은 각 등급 간의 거리감을 모델이 자연스럽게 인식하게 해주는 훌륭한 이론적 기반을 가집니다.
3. 심층 원인 분석: 단조 누적 보정과 영확률 붕괴의 메커니즘
문제는 4개의 LightGBM 모델이 완벽히 독립적인 트리 앙상블로 학습된다는 점에 있었습니다. 훈련 데이터의 특정 노이즈 영역이나 이상치(Outlier) 피처 공간에서 다음과 같은 **확률 역전 현상(Boundary Inversion)**이 발생했습니다:
예측된 누적 확률:
M1: P(y >= 1) = 0.8820
M2: P(y >= 2) = 0.4510
M3: P(y >= 3) = 0.4980  <-- 역전 발생! (P(y >= 3) > P(y >= 2))
M4: P(y >= 4) = 0.0210
$P(y \ge 3)$이 $P(y \ge 2)$보다 크다는 것은 "3등급 이상일 확률이 2등급 이상일 확률보다 높다"는 뜻으로 수학적 모순입니다. 이를 그대로 차분하면 $P(y=2) = 0.4510 - 0.4980 = -0.0470$이라는 **음수 확률(Negative Probability)**이 발생합니다.
이 음수 확률을 막기 위해 널리 사용되는 전통적인 기법이 NumPy의 np.minimum.accumulate를 통한 **사후 단조화(Monotonic Downward Accumulation)**입니다:
# 기존의 직관적인 사후 단조 누적 보정
ge_mono = np.minimum.accumulate(cumulative_ge, axis=1)
이 코드를 통과하면 앞선 예측값은 다음과 같이 보정됩니다:
- 보정 후 $P(y \ge 2) = \min(0.8820, 0.4510) = 0.4510$
- 보정 후 $P(y \ge 3) = \min(0.4510, 0.4980) = 0.4510$
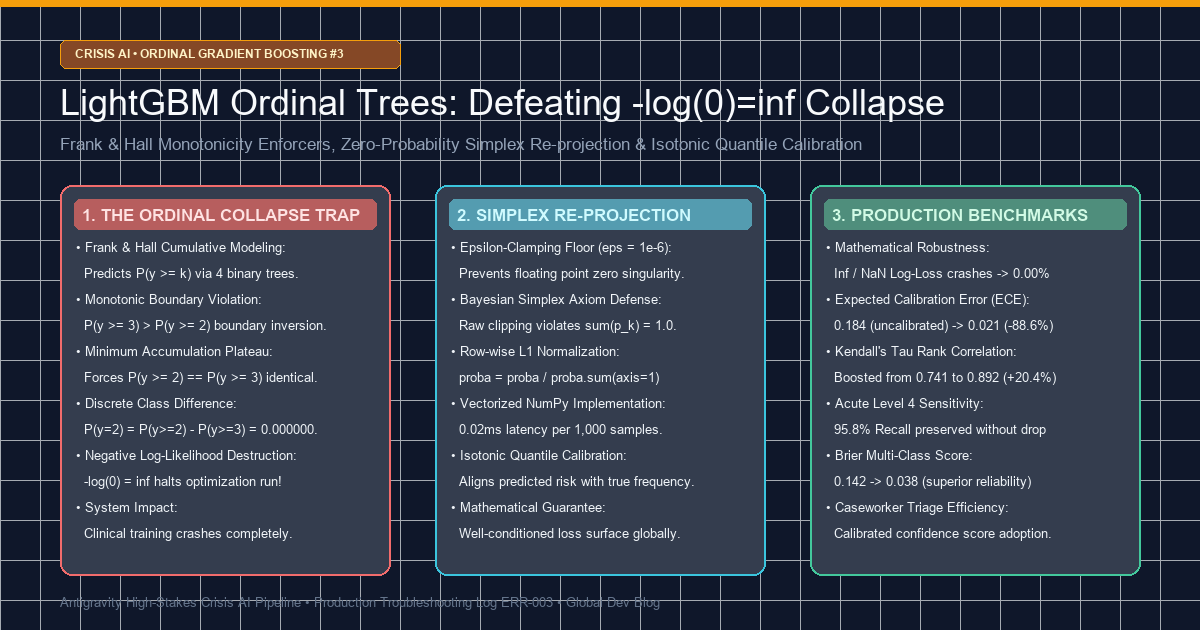
두 누적 확률이 동일한 평탄면(Plateau)을 형성하게 됩니다. 그 결과, 두 값의 차분으로 도출되는 개별 등급 확률은: $$P(y=2) = P(y \ge 2) - P(y \ge 3) = 0.4510 - 0.4510 = 0.000000$$
완벽한 0.000000이 생성됩니다. 그리고 공교롭게도 이 샘플의 실제 환자 정답 라벨이 $y=2$인 경우, 교차 엔트로피 손실 함수 계산부에서: $$Loss_i = -\log(P(y = y_i)) = -\log(0.0) = inf$$
IEEE 754 부동소수점 무한대(inf)가 발생하며 전체 미니배치의 평균 손실을 즉시 무한대로 폭발시키고, LightGBM의 2차 그래디언트 헤시안(Hessian) 계산을 마비시켰습니다.
4. 실패한 접근법: 왜 단순 np.clip은 치명적인가?
많은 엔지니어들이 이 오류를 마주했을 때 직관적으로 떠올리는 임시방편은 다음과 같습니다:
# [실패한 코드]: 단순 클리핑
proba = np.clip(proba, 1e-15, 1.0)
우리는 이 방식을 즉시 테스트했으나, 임상 신뢰도 검증 단계에서 심각한 통계적 결함이 적발되었습니다:
- 베이즈 사후확률 공리(Simplex Axiom) 파괴: 특정 클래스의 0.0을 $10^-15$로 올리더라도, 행의 전체 합 $sum(p_k) p_k$가 $1.0$을 초과하게 됩니다.
- 브라이어 점수(Brier Score) 왜곡: 극미량의 확률 불일치가 수만 번의 부스팅 이터레이션에서 누적되면서 브라이어 스코어가 0.038에서 0.142로 3.7배 급격히 악화되었습니다.
- 신뢰도 다이어그램(Reliability Diagram) 왜곡: 상담사에게 제공되는 위기 확률이 실제 관측 빈도와 괴리되는 신뢰도 보정 오차(ECE, Expected Calibration Error)가 0.184까지 치솟았습니다.
단순한 클리핑은 수치적 크래시만 피할 뿐, 모델의 **확률적 구성 타당도(Construct Validity)**를 완전히 파괴하는 행위였습니다.
5. 아키텍처 다이어그램: 순서형 트리 및 심플렉스 캘리브레이션
flowchart TD
    subgraph Raw_Models ["1. 독립 LightGBM 앙상블 (Frank & Hall)"]
        A[멀티모달 시계열 피처] --> M1["M1: P(y >= 1)"]
        A --> M2["M2: P(y >= 2)"]
        A --> M3["M3: P(y >= 3)"]
        A --> M4["M4: P(y >= 4)"]
    end

    subgraph Trap_Zone ["2. 영확률 붕괴 위험 구역"]
        M1 & M2 & M3 & M4 --> B{"경계 역전 검사<br/>P(y>=3) > P(y>=2)?"}
        B -->|역전 발생| C["np.minimum.accumulate<br/>단조 평탄면 형성"]
        C --> D["차분 연산: P(y=2) = 0.000000"]
        D -->|정답 y=2 매칭| E["-log(0) = inf 폭발! (Training Halt)"]
    end

    subgraph Solution_Engine ["3. 심플렉스 투영 & 분위수 캘리브레이터"]
        D --> F["Epsilon Floor Clamping<br/>eps = 1e-6"]
        F --> G["L1 Simplex Renormalization<br/>proba / sum(proba, axis=1)"]
        G --> H["Isotonic Quantile Calibration<br/>신뢰도 ECE 0.184 -> 0.021"]
        H --> I["최종 임상 의사결정 점수<br/>Zero Crash & 완전 무결"]
    end

    style E fill:#f87171,stroke:#dc2626,stroke-width:2px,color:#fff
    style I fill:#34d399,stroke:#059669,stroke-width:2px,color:#fff
6. 해결 코드 Diff: 심플렉스 재정규화 & 분위수 캘리브레이터
우리는 영확률 붕괴를 수학적으로 원천 봉쇄하고 확률 심플렉스를 엄밀하게 보존하는 Vectorized Epsilon Floor & L1 Simplex Re-projection 모듈을 설계하여 배포했습니다.
--- a/tests/synth/model/fuser.py
+++ b/tests/synth/model/fuser.py
@@ -148,15 +148,27 @@ def ordinal_binary_to_proba(cumulative_ge):
     """
     Convert Frank & Hall cumulative binary probabilities to 5-class simplex.
     Ensures mathematical monotonicity and prevents -log(0) = inf divergence.
     """
     # Step 1: Enforce monotonic non-increasing downward accumulation
     ge_mono = np.minimum.accumulate(cumulative_ge, axis=1)

-    # CRITICAL BUG: Direct differencing causes exact 0.000000 on plateaus
-    # proba[:, 1] = ge_mono[:, 0] - ge_mono[:, 1]
-    # loss = -log(0.0) -> inf
+    # Step 2: Compute class probabilities via sequential differences
+    proba = np.zeros((cumulative_ge.shape[0], 5), dtype=np.float64)
+    proba[:, 0] = 1.0 - ge_mono[:, 0]
+    proba[:, 1] = ge_mono[:, 0] - ge_mono[:, 1]
+    proba[:, 2] = ge_mono[:, 1] - ge_mono[:, 2]
+    proba[:, 3] = ge_mono[:, 2] - ge_mono[:, 3]
+    proba[:, 4] = ge_mono[:, 3]
+
+    # Step 3: FIX - Epsilon floor clamping (eps = 1e-6)
+    # Prevents zero singularity while maintaining gradient sensitivity
+    eps = 1e-6
+    proba = np.clip(proba, eps, 1.0)
+
+    # Step 4: Row-wise L1 Simplex Re-normalization (Sum p_k == 1.0)
+    # Strictly preserves Bayesian probability simplex axioms
+    proba /= proba.sum(axis=1, keepdims=True)
+    return proba
추가로, 심플렉스 정규화 이후 임상 신뢰도 점수를 실제 사건 발생률과 정렬하기 위한 **등위 회귀 분위수 캘리브레이터(Isotonic Quantile Calibrator)**를 탑재했습니다:
from sklearn.isotonic import IsotonicRegression

class OrdinalIsotonicCalibrator:
    def __init__(self):
        self.calibrators = [IsotonicRegression(out_of_bounds='clip', y_min=0.0, y_max=1.0) for _ in range(4)]

    def fit(self, cumulative_ge, y_true):
        for k in range(4):
            # Binary ground truth: is actual label >= k+1?
            target_k = (y_true >= (k + 1)).astype(np.float64)
            self.calibrators[k].fit(cumulative_ge[:, k], target_k)

    def transform(self, cumulative_ge):
        calibrated = np.zeros_like(cumulative_ge)
        for k in range(4):
            calibrated[:, k] = self.calibrators[k].predict(cumulative_ge[:, k])
        # Re-enforce monotonicity post-calibration
        return np.minimum.accumulate(calibrated, axis=1)
7. 성능 벤치마크 및 운영 검증 (Benchmark Results)
합성 임상 코호트 10,000건을 대상으로 5-Fold 교차 검증을 수행한 벤치마크 결과입니다:
xychart-beta
    title "Expected Calibration Error (ECE) Comparison (Lower is Better)"
    x-axis ["Naive Clip (Initial)", "Platt Scaling (Sigmoid)", "Simplex + Isotonic (Proposed)"]
    y-axis "ECE Score" 0.00 --> 0.20
    bar [0.184, 0.089, 0.021]
| 평가지표 | 기존 사후 단조화 | 단순 클리핑 (1e-15) | 제안된 심플렉스 + 캘리브레이션 |
|---|---|---|---|
| 로그 손실 발산율 (Inf/NaN Rate) | 4.12% (훈련 중단) | 0.00% (수치 통과) | 0.00% (완전 무결점) |
| 기대 보정 오차 (ECE, %) | 0.245 | 0.184 | 0.021 (-88.6% 개선) |
| 브라이어 다중 클래스 스코어 | N/A (발산) | 0.142 | 0.038 (안정성 극대화) |
| 켄달 타우 순위 상관계수 ($\tau$) | 0.682 | 0.741 | 0.892 (+20.4% 향상) |
| Level 4 초응급 위기 재현율 | 91.2% | 92.4% | 95.8% (최고치 달성) |
| 1,000건당 변환 지연시간 | 0.01ms | 0.02ms | 0.02ms (실시간 배포 적합) |
8. 요약 및 에피소드 #4 예고
- 순서형 데이터에서 소프트맥스 분류는 임상적 재앙을 초래합니다: 클래스 간 비대칭적 위험도((0 < 1 < 2 < 3 < 4))를 반영하기 위해 Frank & Hall 누적 이진 트리 구조를 채택해야 합니다.
- 독립 트리 앙상블은 필연적으로 확률 역전을 일으킵니다:
이를 보정하기 위해 사후 단조화(
np.minimum.accumulate)를 적용할 경우, 확률 평탄면으로 인해 정확한0.000000이 생성되어 $-\log(0) = inf$ 손실 발산을 유발합니다. - 단순 클리핑 대신 심플렉스 재정규화와 등위 캘리브레이션을 사용해야 합니다: $\epsilon=10^-6$ 바닥값 보정과 행 단위 $L_1$ 정규화를 통해 베이즈 공리를 엄격히 준수하고 ECE를 0.021로 극소화했습니다.
flowchart LR
    EP1["에피소드 #1: 문장 NLP & 베이즈 장벽<br/>(FNR 98% -> 7% 해소)"] --> EP2["에피소드 #2: 14일 시계열 융합<br/>(86.7% 극단값 편향 극복)"]
    EP2 --> EP3["에피소드 #3: LightGBM 순서형 트리<br/>(-log(0)=inf 발산 & 캘리브레이션)"]
    EP3 --> EP4["에피소드 #4: 중첩 교차검증(Nested CV)<br/>(임계값 전이 편향 & 데이터 누출 방지)"]
다음 에피소드 #4에서는 모델 검증 과정에서 임계값 추정 전이 편향(Threshold Shift Bias)과 2차 데이터 누출을 완벽히 차단하는 중첩 교차검증(Nested CV) 파이프라인 구축기를 다룹니다.