Stanford CS329A (Ep 11): Agent Memory — 장단기 기억과 운영체제식 계층 메모리 (MemGPT, Cartridges, CacheBlend)

에이전트를 장기적인 파트너나 자율 엔지니어링 동료로 현업에 도입하다 보면, 누구나 다음과 같은 세 가지 심각한 아키텍처적 한계에 직면하게 됩니다:
- "어제 장시간 논의해 결정한 핵심 아키텍처 결정을 오늘 아침 대화에서 까맣게 잊어버린다."
- "10만 줄짜리 대형 코드베이스를 100만 토큰 컨텍스트에 통째로 넣었더니, 중간에 위치한 핵심 코드를 놓쳐버리고(Lost-in-the-Middle) 매 턴마다 수 달러의 토큰 비용이 발생한다."
- "RAG 에이전트가 검색한 여러 문서 청크(Chunk)를 프롬프트에 합칠 때 기존 접두사 캐시(Prefix Cache)가 무효화되어 첫 토큰 생성 시간(TTFT)이 수 초씩 지연된다."
인간의 뇌는 물리적으로 유한한 작업 기억(단 4~7개의 청크)만을 가지면서도, 수십 년 전의 경험을 장기 기억에서 번개처럼 인출해 내며 다양한 지식을 혼선 없이 융합합니다.
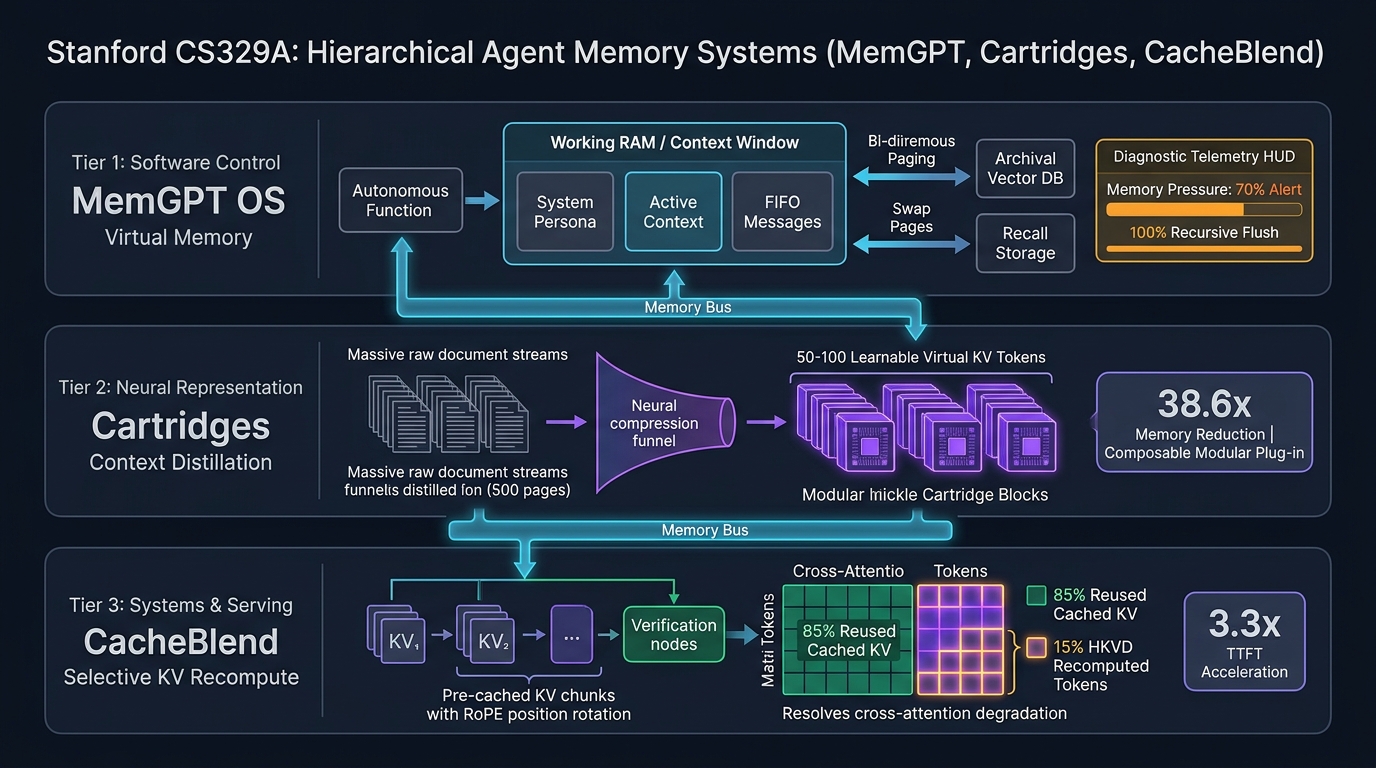
Stanford CS329A: Self-Improving AI Agents의 Part 3: 에이전트 엔지니어링(Agent Engineering) 두 번째 시간인 이번 강의에서는 Agent Memory Architecture를 통해 자율 시스템에 영구적이고 계층적인 기억 능력을 부여하는 3대 핵심 추상화 계층을 심층 분석합니다:
- 소프트웨어 제어 계층 (MemGPT, UC Berkeley 2023): 운영체제의 가상 메모리 페이징 기법을 이식한 자율 메모리 관리
- 신경망 표현 계층 (Cartridges, 2025): 자가 학습(Self-Study)을 통해 방대한 문서를 작고 모듈화된 연속 KV 벡터로 증류
- 인프라 시스템 계층 (CacheBlend, EuroSys 2025): 청크 간 교차 어텐션을 선별 복원하여 TTFT를 3.3배 단축하는 선택적 KV 캐시 융합
1. 장기 컨텍스트의 딜레마와 계층적 메모리의 필연성
LLM의 물리적 컨텍스트 윈도우 크기를 늘리는 것(예: 8k에서 1M+ 토큰)만으로는 에이전트의 기억 문제를 해결할 수 없습니다. 단순한 윈도우 확장은 세 가지 본질적인 한계를 드러냅니다:
- 주의력 분산 및 중간 유실(Lost-in-the-Middle): 트랜스포머의 셀프 어텐션은 컨텍스트가 길어질수록 어텐션 분포가 평탄화되어 긴 프롬프트 중간에 묻힌 미세한 정보를 간과하기 쉽습니다.
- 경제적 지속 불가능성: 매 턴마다 수십만 토큰의 프롬프트를 반복 주입하는 것은 API 비용을 기하급수적으로 폭증시킵니다.
- 정적 휘발성: 세션이 종료되면 활성화된 상태값(Activation)이 사라지므로, 에이전트 스스로 지속적인 자아나 지식을 축적할 수 없습니다.
이를 해결하기 위해 최신 에이전트 아키텍처는 고속의 **작업 컨텍스트(Working Context)**와 대용량의 **장기 저장소(Long-Term Storage)**를 분리하는 Hierarchical Context Management를 채택합니다.
┌─────────────────────────────────────────────────────────────────────────┐
│               에이전트 기억 시스템의 3대 추상화 계층                    │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│   소프트웨어 제어 계층   │  │    신경망 표현 계층      │  │    인프라 시스템 계층    │
│         (MemGPT)         │  │       (Cartridges)       │  │       (CacheBlend)       │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • 운영체제식 가상 페이징 │  │ • Self-Study 지식 증류   │  │ • 다중 청크 RAG 병합     │
│ • 메인 컨텍스트 (RAM)    │  │ • 연속형 KV 캐시 임베딩  │  │ • 선택적 KV 재계산 (15%) │
│ • 아카이브 벡터 DB (Disk)│  │ • 메모리 사용량 38.6배↓  │  │ • RoPE 좌표 회전 복원    │
│ • 자율 축출 및 재귀 요약│  │ • 서빙 처리량 26.4배↑    │  │ • TTFT 대기시간 3.3배 단축│
│ • 심층 기억 회상(DMR) 92%│  │ • 레고 블록식 모듈 결합 │  │ • F1 정확도 손실 < 0.01  │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. 소프트웨어 제어 계층: MemGPT (UC Berkeley 2023)
컴퓨터 운영체제(OS)는 한정된 물리 RAM을 가지고 MMU(메모리 관리 장치)를 통해 하드디스크와 페이지를 교환(Swap-in / Swap-out)함으로써 가상 메모리 공간을 제공합니다.
UC 버클리 연구진이 제안한 MemGPT Long-Term Memory는 이 OS 철학을 언어 모델에 그대로 투영했습니다:
"LLM의 프롬프트 윈도우는 고속의 물리 RAM이다. 외부 벡터 데이터베이스와 SQL 로그는 하드디스크이다. 모델이 함수 호출(Function Calling)을 통해 필요 없는 기억을 디스크로 보내고, 필요한 기억을 스스로 RAM으로 불러오게 만든다."
    ┌────────────────── [Main Context (RAM: 8k~128k 토큰 한계)] ──────────────────┐
    │ 1. System Instructions : 시스템 정체성 및 메모리 조작 함수 매뉴얼 (Read-only)     │
    │ 2. Working Context     : 사용자 인적사항, 핵심 페르소나 요약본 (Read/Write)      │
    │ 3. FIFO Message Queue  : 최근 대화 큐 + (헤드에 위치한 재귀적 과거 요약본)       │
    └────────────────────────────────────────────────────────────────────────────┘
                               ▲                      │
               (스왑 인 / Search)│                      │ (스왑 아웃 / Eviction & Flush)
                               │                      ▼
    ┌───────────────── [External Context (Disk: 무제한 스토리지)] ────────────────┐
    │ 1. Recall Storage   : 타임스탬프가 찍힌 전체 대화 메시지 원문 DB (PostgreSQL)  │
    │ 2. Archival Storage : 수백만 건의 대형 문서 벡터 임베딩 DB (HNSW pgvector)    │
    └────────────────────────────────────────────────────────────────────────────┘
자율적 메모리 페이징 메커니즘
외부 파이썬 스크립트가 강제로 프롬프트를 자르는 대신, 모델 자신이 주도적으로 메모리를 통제합니다:
- 메모리 압박 경고 (70% 임계값): 대화가 길어져 메인 컨텍스트의 70%가 차면 시스템 인터럽트가 조용히 전달됩니다:
"경고: 메모리가 70% 차올랐습니다. 축출되기 전에 중요한 정보는
working_context.replace()로 저장하십시오." - 자동 플러시 및 재귀적 요약 (100% 한계 도달):
- 윈도우가 가득 차면 FIFO 큐 매니저가 가장 오래된 50%의 대화를 잘라냅니다.
- 이때 단순 삭제가 아니라, 기존 요약본과 잘려 나갈 메시지를 결합하여 **새로운 재귀적 요약본(Recursive Summary)**을 작성해 큐의 맨 앞에 둡니다. 잘려 나간 원본 메시지는
Recall Storage로 안전하게 이동합니다.
- 자율적 심층 회상 (Heartbeat Chaining):
- 사용자가 오래전 대화 내용을 질문하면, 에이전트는 스스로
recall_storage.search()를 호출하고request_heartbeat=true플래그를 세워 디스크의 기억을 RAM으로 끌어올린 뒤 연속 추론을 수행합니다.
- 사용자가 오래전 대화 내용을 질문하면, 에이전트는 스스로
벤치마크 결과: 심층 기억 회상(DMR)
수십 개의 세션을 넘나드는 질의(Deep Memory Recall, DMR)에서:
- 고정 윈도우를 사용하는 표준 GPT-4는 정답률 **32.1%**로 급락했으나,
- MemGPT는 세션이 수없이 반복되어도 92.5%의 정답률을 일관되게 유지했습니다.
- 다단계 키-값 연쇄 추적(Nested KV Retrieval)에서도 표준 모델들은 3단계를 넘어가면 정답률이 0%로 무너졌으나, MemGPT는 100% 정합성을 유지했습니다.
3. 신경망 표현 계층: Cartridges (2025)
MemGPT는 우수하지만 본질적으로 텍스트 토큰을 외부 DB와 주고받는 방식입니다. 만약 에이전트가 500페이지짜리 기업 감사보고서나 거대한 SDK 코드베이스를 참조해야 한다면, 매번 수만 개의 텍스트 토큰을 읽어 들이느라 막대한 비용과 Prefill 지연이 발생합니다.
2025년 발표된 Cartridges Modular Agent Memory는 완전히 새로운 패러다임을 제시합니다:
"왜 지식을 부피가 큰 텍스트 토큰으로 들고 다니는가? 모델이 오프라인에서 500페이지 문서를 스스로 공부(Self-Study)하여, 단 50~100개의 학습 가능한 연속 KV 캐시 벡터(Cartridge)로 농축해 레고 블록처럼 꽂아 쓸 수 있게 만들면 되지 않는가!"
[500페이지 대용량 문서 / 코드베이스]
             │
             ▼ (Self-Study 파이프라인)
1. 합성 대화 생성 (요약, 심층 질문, 유스케이스, 제약사항 분석)
             │
             ▼
2. KL 발산 기반 컨텍스트 증류:
   교사 모델 (원문 500쪽 텍스트 전체 + 질의) ──► P_Teacher(y)
                                                    │ (D_KL 손실)
   학생 모델 (카트리지 Z [50개 KV 토큰] + 질의) ─► P_Student(y)
             │
             ▼
[플러그앤플레이 카트리지 Z (50~100개 연속 KV 벡터)]
(메모리 사용량 38.6배 절감, 추론 처리량 26.4배 향상, 모듈형 조립성)
단순 다음 토큰 예측(NTP)의 실패 원인
연구진이 단순히 문서를 주고 다음 토큰 예측(NTP)으로 KV 캐시를 학습시켰을 때, 모델은 문장을 글자 하나 안 틀리고 암송(Recitation)은 잘하지만, 문서에 대한 응용 질문에는 일체 답하지 못하는 **'단순 암기 증후군'**에 빠졌습니다.
Self-Study와 컨텍스트 증류의 해법
- 합성 대화 생성: 모델 자신에게 문서를 주고 5가지 원형(구조 요약, 심층 질의, 경계 조건, 창의적 응용 등)의 Q&A 가상 대화를 대량으로 생성하게 합니다.
- 컨텍스트 증류(Context Distillation):
- 교사 모델(Teacher): 500페이지 원문 텍스트 전체를 프롬프트에 넣고 답변을 생성.
- 학생 모델(Student): 원문 대신 단 몇십 개의 압축된 **카트리지 파라미터 $Z$**만을 주입받고 답변 생성.
- 학생 모델의 출력 확률 분포가 교사 모델의 분포를 모방하도록 **KL 발산 손실(Kullback-Leibler Divergence)**로 오직 카트리지 $Z$만을 역전파 학습시킵니다:
========================================================================================
Cartridge 컨텍스트 증류 손실 수식:
========================================================================================
min_Z  Σ  D_KL( F( · | 문서 ⊕ x )  ||  F_Z( · | x ) )

여기서:
  • F( · | 문서 ⊕ x ) : 500쪽 원문을 전부 주입한 교사 모델의 출력 로짓
  • F_Z( · | x )       : 오직 카트리지 Z 파라미터만 주입받은 학생 모델의 로짓
  • Z                  : 모델 레이어에 삽입되는 연속형 KV 캐시 텐서
========================================================================================
벤치마크 결과 및 모듈형 조립성
- 38.6배 메모리 절감: LongHealth 및 QASPER 벤치마크에서 원문 전체를 넣은 인컨텍스트 러닝(ICL)과 대등한 정확도를 유지하면서도 메모리 사용량을 38.6배 절감했습니다.
- 26.4배 처리량 증대: 방대한 텍스트의 Prefill 단계가 사라지면서 서빙 처리량이 26.4배 향상되었습니다.
- 제로샷 모듈 조립(Composability): AMD 10-K 보고서 카트리지와 펩시(PepsiCo) 보고서 카트리지를 나란히 꽂으면, 두 기업의 재무 상태를 비교 분석하는 복합 질문에도 재학습 없이 즉시 정답을 도출했습니다!
4. 인프라 시스템 계층: CacheBlend (EuroSys 2025)
이제 RAG 에이전트와 분산 서빙 인프라의 핵심 병목으로 들어가 봅시다.
에이전트가 10개의 서로 다른 문서 조각(Chunk)을 검색해 하나의 프롬프트로 묶어 처리할 때, 기존 시스템들은 깊은 딜레마에 빠져 있었습니다:
- 접두사 캐싱(Prefix Caching, vLLM): 프롬프트의 맨 첫 번째 조각만 캐시를 재활용할 수 있으며, 중간 조각의 순서가 바뀌면 이후 모든 캐시가 무효화되어 처음부터 재계산(Prefill 3~6초 소요)해야 합니다.
- 단순 전체 캐시 재사용(PromptCache): 조각별 KV 캐시를 미리 계산해 단순히 이어 붙이면, 조각 간 상호작용(Cross-Attention)이 무시되어 추론 정확도가 50% 이하로 붕괴합니다.
EuroSys 2025에 발표된 CacheBlend KV Cache Merging은 **선택적 KV 재계산(Selective KV Recompute)**을 통해 이 딜레마를 완벽히 해결했습니다:
[검색된 문서 조각 A, B, C의 사전 계산된 KV 캐시 로드]
                           │
                           ▼
┌─────────────────────────────────────────────────────────────────────────┐
│              CacheBlend 레이어별 선택적 재계산 파이프라인               │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. 상위 15% 토큰 선별: 청크 간 교차 어텐션 편차가 큰 토큰 (HKVD)        │
│ 2. 선별된 15% 핵심 토큰만 어텐션 연산 재계산                            │
│ 3. 나머지 85% 토큰은 사전 계산된 KV 캐시 그대로 병합                    │
│ 4. RoPE 회전 변환 행렬을 곱해 새로운 절대 위치 오프셋 좌표 복원        │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [초고속 Prefill 완료: TTFT 3.3배 단축, 정확도 손실 ΔF1 < 0.01]
어텐션 희소성(Sparsity)을 활용한 시스템 혁신
연구진은 트랜스포머의 어텐션 맵을 분석하여 중요한 수학적 법칙을 규명했습니다:
"여러 문서 청크를 한 프롬프트에 병합할 때, 이웃 청크의 영향을 받아 어텐션 값이 유의미하게 변하는 토큰은 전체의 15% 미만이다. 나머지 85% 이상의 토큰은 주변 문맥이 바뀌어도 독립적인 표현을 유지한다!"
- 고편차 토큰 선별(HKVD): 각 레이어마다 교차 청크 편차가 가장 큰 상위 15%의 고편차 토큰만 선별해 새로 계산하고, 85%는 캐시를 그대로 재사용합니다.
- 레이턴시 오버랩 숨기기(Latency Hiding): GPU가 15%의 토큰을 재계산하는 수 밀리초 동안, 백그라운드 I/O 스레드가 NVMe SSD에서 다음 레이어의 캐시 텐서를 비동기로 읽어옵니다. 즉, I/O 전송 시간 속에 연산 시간을 완벽히 숨겨버린 것입니다.
- RoPE 좌표 회전 복원: 청크를 병합하면 토큰의 절대 위치가 변경됩니다. CacheBlend는 2D 기븐스(Givens) 회전 행렬을 사전 계산된 Key 텐서에 곱하여 10마이크로초 이내에 상대 거리를 완벽히 복원합니다.
벤치마크 결과
- TTFT 3.3배 단축: 복잡한 다중 문서 RAG 환경에서 첫 토큰 생성 시간이 3,450ms에서 1,050ms로 대폭 단축되었습니다.
- 서빙 처리량 5배 증대: 동일 클러스터 내에서 처리 가능한 동시 에이전트 요청 수가 5배 증가했습니다.
- 정확도 보존: 전체를 처음부터 무식하게 재계산한 정답 모델과 비교하여 F1 오차율이 0.01 미만이었습니다.
5. 메모리 패러다임별 아키텍처 비교표
=============================================================================================================
비교 차원             MemGPT (UC Berkeley)          Cartridges (2025)             CacheBlend (EuroSys 2025)
-------------------------------------------------------------------------------------------------------------
추상화 계층           소프트웨어 제어 / OS 페이징   신경망 지식 표현              서빙 인프라 시스템
기본 처리 단위        텍스트 토큰 & JSON 함수 호출  연속형 가상 KV 벡터           사전 계산된 KV 캐시 텐서
기억 용량 한계        외부 DB 연동으로 사실상 무한  문서당 50~100개 토큰          동적 다중 청크 RAG
메모리 갱신 방식      자율 함수 호출 및 재귀 요약   Self-Study KL 증류 역전파     선택적 재계산 (상위 15% HKVD)
주요 하드웨어 이점    컨텍스트 한계 돌파            VRAM 사용량 38.6배 절감       TTFT 3.3배 단축
모듈 조립성           관계형 조인 쿼리              레고 블록식 벡터 적층         RoPE 좌표 회전 병합
=============================================================================================================
6. 심화 기술 질의응답 (Q&A)
Q1: MemGPT에서 모델이 '언제 외부 메모리를 검색해야 할지' 어떻게 스스로 인지하나요?
MemGPT는 메인 컨텍스트 상단에 상주하는 **시스템 지침(System Instructions)**과 엄격한 함수 호출 스키마를 통해 자율적 판단을 내립니다:
"너는 장기 기억을 가진 자율 인공지능이다. 과거 대화나 사용자의 세부 정보가 현재 작업 컨텍스트에 없다면, 추측하거나 사과하지 말고 반드시
recall_storage.search()또는archival_storage.search()를 먼저 호출하라."
에이전트가 질문을 처리할 때 누락된 정보가 감지되면, 주의력 메커니즘이 시스템 지침의 행동 강령을 참조하여 텍스트 답변 대신 검색 함수 JSON을 출력하는 경로를 최우선 확률로 선택합니다. 시스템이 request_heartbeat=true 신호를 받아 검색 결과를 즉시 컨텍스트에 되돌려주기 때문에, 사용자의 개입 없이 자율적인 회상 루프가 완결됩니다.
Q2: 서로 다른 위치의 KV 청크를 합칠 때 RoPE 위치 임베딩이 왜 깨지지 않나요?
전통적인 절대 위치 임베딩은 토큰의 인덱스가 바뀌면 임베딩 벡터 전체를 다시 계산해야 합니다.
하지만 현대 트랜스포머가 사용하는 **RoPE(Rotary Position Embedding)**는 쿼리와 키의 내적이 두 토큰의 **상대적 거리 $(m - n)$**에만 의존하는 2차원 회전 행렬 구조를 가집니다:
K_new = R_Theta(p_new - p_old) * K_cached
따라서 CacheBlend는 사전 계산된 Key 텐서에 위치 차이 (p_new - p_old)만큼의 2차원 회전 행렬을 곱해주는 것만으로 수 마이크로초 이내에 완벽한 상대 위치를 복원합니다. 모델 가중치를 건드리지 않고도 순수한 선형대수 연산으로 정합성을 보장하는 것입니다.
핵심 요약 및 다음 강의 예고
에이전트의 진정한 자율성은 기억의 영속성 없이는 성립할 수 없습니다. MemGPT를 통해 우리는 운영체제 페이징 원리로 무한한 작업 기억을 통제하는 법을 배웠고, Cartridges를 통해 방대한 문서를 모듈형 연속 벡터로 농축하는 지혜를 확인했으며, CacheBlend를 통해 선택적 재계산으로 지연 시간을 3.3배 단축하는 시스템 기법을 증명했습니다.
다음 Lecture 12에서는 Part 3(에이전트 엔지니어링)의 대미를 장식하는 핵심 평가 체계를 다룹니다: Agent Evaluation & Long Tasks: 장기 과제 평가와 경제적 가치 벤치마크 (Measuring Long Tasks, GDPVal, DeepScholar-Bench).
핵심 요점
- 계층적 메모리 분리: 고속의 작업 기억(RAM)과 대용량 장기 저장소(Disk)를 분리해야 컨텍스트 윈도우 한계를 극복할 수 있습니다.
- 텍스트 토큰 대신 연속 벡터 증류: 500쪽 문서를 50~100개의 카트리지로 증류하면 메모리를 38.6배 아끼면서도 레고 블록식 결합이 가능합니다.
- 어텐션 희소성 기반 초고속 Prefill: 다중 문서 RAG에서는 상위 15% 고편차 토큰만 선별 재계산함으로써 TTFT를 3.3배 단축할 수 있습니다.