Stanford CS329A (Ep 16): Multimodal & Embodied Agents — 물리 세계를 조작하는 로보틱스 파운데이션 모델 (VLA, RT-2, OpenVLA, π₀)

지난 강의에서 우리는 소프트웨어 에이전트가 격리된 가상 샌드박스 안에서 다중 경계 방어 하네스와 AI Control 프로토콜을 통해 안전성을 유지하는 원리를 배웠습니다. 하지만 인공지능 커뮤니티에는 근본적인 의문이 남아 있습니다:
"컴퓨터 화면 안에서 텍스트를 생성하고 코드를 실행하는 것만으로 '완전한 인공 일반 지능(AGI)'이라고 부를 수 있을까요? 우리가 발을 딛고 살아가는 현실 세계는 가상 터미널이 아니라 중력, 마찰력, 3차원 공간, 그리고 딱딱하거나 부드러운 물리적 물체들로 가득 차 있습니다."
만약 거대 파운데이션 모델에게 2개의 고해상도 눈(RGB 카메라)과 강철로 된 7자유도 관절 팔(로봇 매니퓰레이터)을 달아준다면 어떤 일이 벌어질까요?
- 깨지기 쉬운 날달걀을 껍데기 손상 없이 집어 프라이팬에 올리고,
- 어질러진 거실 바닥에서 아이의 장난감을 색상별로 분류해 상자에 정리하며,
- 공장 조립 라인에서 미세한 전자 부품을 0.1밀리미터 오차로 정밀하게 결합하는 일!
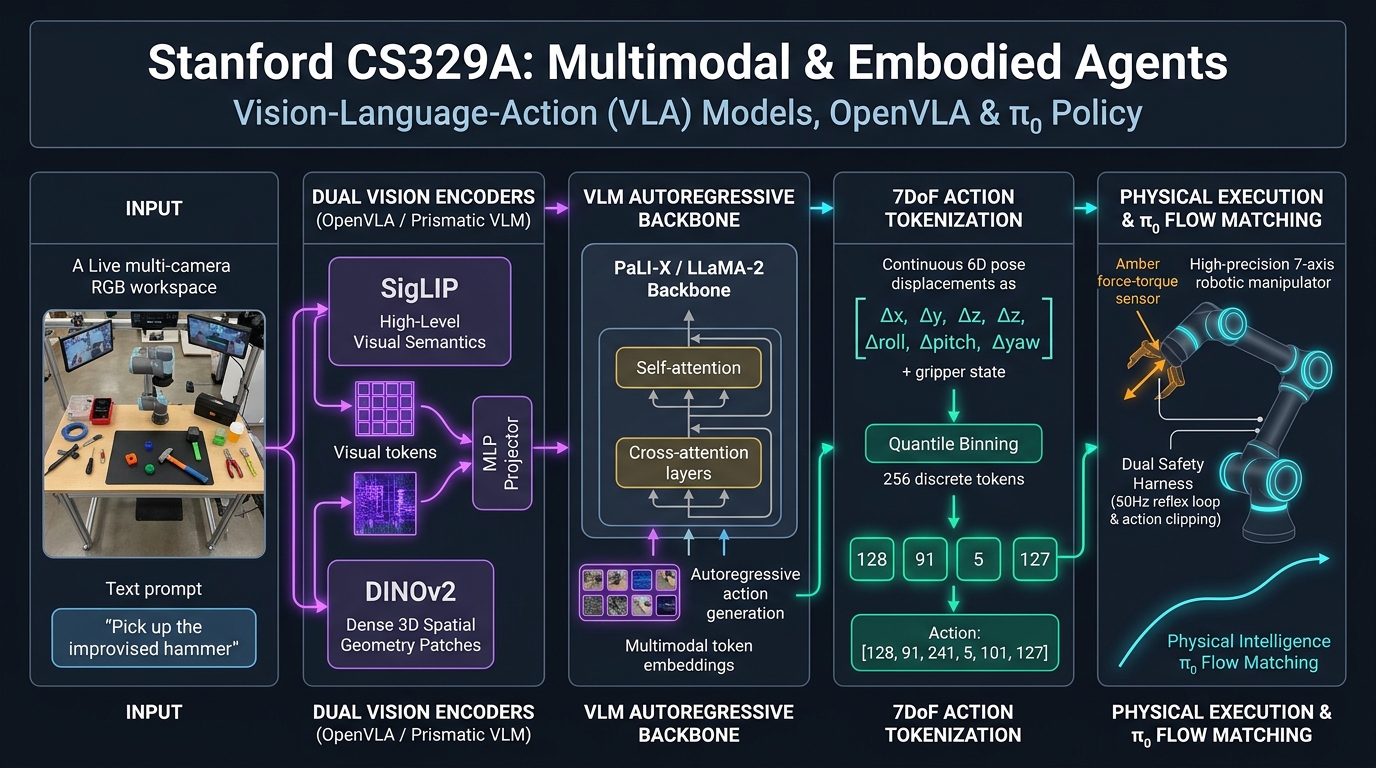
Stanford CS329A: Self-Improving AI Agents의 Part 4: 프런티어(Frontiers in Reasoning & Autonomy) 네 번째 강의인 Lecture 16에 오신 것을 환영합니다. 구글 딥마인드 로보틱스 출신이자 피지컬 인텔리전스(Physical Intelligence)의 창립 연구원인 대니 드리스(Danny Driess) 박사의 선구적 연구를 바탕으로, 시각-언어 모델(VLM)이 로봇 팔의 물리적 모터 신경망으로 직접 진화한 **비전-언어-행동 모델(VLA, Vision-Language-Action)**의 혁명적 구조를 분석합니다:
- 행동도 언어의 일종이다 (RT-2, DeepMind 2023): 7자유도 연속 모터 제어 신호를 256개 이산 토큰으로 변환하여 55B 거대 VLM의 어휘집에 이식한 발상의 전환.
- 오픈소스와 경량화의 승리 (OpenVLA, 2024): SigLIP과 DINOv2의 이중 시각 융합, 분위수 빈닝(Quantile Binning), LoRA 미세조정을 통해 단 1장의 소비자용 게이밍 GPU에서 55B 모델을 꺾은 7B 모델의 기적.
- 연속 제어와 물리 피드백 ($\pi_0$): 이산 토큰의 미세 떨림을 극복하고 빨래 개기와 상자 접기 등 유연 물체를 정복한 플로우 매칭(Flow Matching) 확산 정책.
- 체화된 지능의 2중 안전 하네스: 소프트웨어 임계 토큰 클리핑과 하드웨어 힘-토크 센서 반사 신경망.
1. 물리 세계의 프런티어: 로보틱스 '데이터 기근'의 돌파구
수십 년 동안 로봇 연구는 지독한 데이터 기근에 시달려 왔습니다. 텍스트 언어 모델은 인터넷의 수조 개 토큰을 학습하며 폭발적으로 성장했지만, 물리적 로봇 데이터는 수집하기가 극도로 어렵습니다:
- 실제 로봇 하드웨어를 물리 시설에서 24시간 동안 인간 전문가가 조종해야 합니다.
- 구글 연구소가 13대의 로봇 팔을 17개월 동안 풀가동해 모은 데이터는 겨우 13만 개의 궤적에 불과했습니다.
- 따라서 좁은 연구실 데이터만 학습한 기존 로봇들은 연구실 조명이 10%만 어두워지거나 물체 위치가 5센티미터만 틀어져도 허공을 휘저으며 실패했습니다.
대니 드리스 박사와 딥마인드 연구진은 웹 스케일의 거대 시각 지능을 물리적 로봇 팔로 직접 전이시키는 혁명적 발상을 제안했습니다:
"로봇 제어 정책(Policy)을 밑바닥부터 좁은 로봇 데이터로만 학습시키지 마라. 인터넷의 수십억 개 이미지와 텍스트를 통달한 거대 VLM을 그대로 가져와, 모터의 관절 이동 값을 '새로운 외국어 단어'로 취급하여 VLM의 어휘집에 집어넣어라!"
┌──────────────────────────────────────────────────────────────────────────┐
│              비전-언어-행동 모델(VLA)의 패러다임 전환                    │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────────────┐   ┌──────────────────────────────────┐
│ 기존 로보틱스 제어 정책          │   │ VLA (Vision-Language-Action)     │
├──────────────────────────────────┤   ├──────────────────────────────────┤
│ • 소규모 CNN을 연구실 데이터로만 │   │ • 7B~55B 거대 멀티모달 백본     │
│   몇천 번 지도학습               │   │ • 인터넷 전 영역 시각 사전학습  │
│ • 의미론적 일반화 능력 0%        │   │ • 풍부한 상식적 물리 추론 탑재: │
│ • 물체가 5cm만 틀어져도 실패     │     "돌멩이를 임시 망치로 쓸 수 있다"│
│ • 작업마다 코드를 새로 짜야 함   │   │ • 처음 보는 물체와 어질러진     │
│ • 고립된 태스크 사일로           │     환경에서도 제로샷 일반화 수행│
└──────────────────────────────────┘   └──────────────────────────────────┘
2. 행동을 단어로 바꾸다: RT-2 (Brohan et al., DeepMind 2023)
2023년 7월, 구글 딥마인드는 거대 멀티모달 모델(PaLI-X 55B, PaLM-E 12B)을 엔드투엔드 로봇 제어기로 변환한 **Robotic Transformer 2 (RT-2)**를 발표했습니다.
[입력: RGB 카메라 피드] + [지시문: "축구공을 메시(Lionel Messi) 사진 옆으로 옮겨라"]
                                     │
                                     ▼
     ┌───────────────────────────────────────────────────────────────┐
     │             거대 VLA 백본 모델 (PaLI-X 55B)                   │
     │  • 웹 상식 지식: 리오넬 메시의 얼굴을 시각적으로 식별         │
     │  • 공간 추론: 축구공과 사진의 3차원 상대 좌표 계산            │
     └───────────────────────────────┬───────────────────────────────┘
                                     │
                                     ▼ (자기회귀적 다음 토큰 방출)
                   "Action: 1 128 91 241 5 101 127"
                     │       │  │   │   │  │   │   └─ 그리퍼 닫기 (127)
                     │       │  │   │   └──┴───┴───── 3차원 회전 변화량 (Δroll, Δpitch, Δyaw)
                     │       └──┴───┴──────────────── 3차원 위치 이동량 (Δx, Δy, Δz)
                     └─────────────────────────────── 에피소드 종료 여부 플래그
7자유도(7DoF) 행동 공간과 256개 빈(Bin) 균등 이산화
산업용 로봇 팔은 7자유도 연속 공간에서 모션을 제어합니다:
- 3차원 병진 변위 ($\Delta x, \Delta y, \Delta z$): 로봇 손끝(End-Effector)의 공간 이동.
- 3차원 회전 변위 ($\Delta roll, \Delta pitch, \Delta yaw$): 손목의 각도 변화.
- 그리퍼 개폐 상태 ($gripper$): 물체를 집고 놓는 모터 상태.
부동소수점 실수 벡터를 트랜스포머의 어휘집으로 변환하기 위해 RT-2는 **균등 행동 이산화(Uniform Action Discretization)**를 설계했습니다:
- 각 모션 축의 이동 한계 구간
[a_min, a_max](예:[-30cm, +30cm])을 256개의 구간(Bin)으로 균등하게 분할합니다.
\text{bin\_index} = \left\lfloor 256 \times \frac{a - a_{\min}}{a_{\max} - a_{\min}} \right\rfloor, \quad [0, 255] \text{ 범위로 클리핑}
- 평소 언어 모델에서 거의 쓰이지 않는 특수 토큰 256개를 골라 이 모터 인덱스에 일대일 매핑합니다.
- 디코딩 시 **출력 제약 마스크(Output Constraint Mask)**를 걸어, 모터를 제어할 때는 오직 이 256개의 유효한 행동 토큰만을 방출하도록 강제합니다.
상식 지식의 물리적 전이
웹 사전 학습 지식을 그대로 품고 있는 RT-2는 놀라운 지능을 보였습니다:
- 훈련 데이터에 "망치를 집어라"는 데이터가 전혀 없었음에도, 로봇 앞에 돌멩이와 못을 두고 *"즉석 망치로 쓸 수 있는 물건을 집어라"*라고 지시하자 망설임 없이 돌멩이를 집어 올렸습니다.
- "가장 피곤해 보이는 동물 인형을 골라라", "다 마신 음료수 캔을 쓰레기통에 버려라" 같은 복잡한 의미론적 지시를 수행하며, 기존 최고 로봇 모델 대비 3배 이상의 일반화 성공률을 기록했습니다.
공동 미세조정(Co-Fine-Tuning): 파멸적 망각 차단
수십억 개의 파라미터를 가진 거대 VLM에 오직 로봇 제어 궤적만 주입하면, 신경망은 기존 웹 텍스트에서 배운 상식을 잊어버리는 **파멸적 망각(Catastrophic Forgetting)**을 겪습니다. RT-2는 이를 방지하기 위해 학습 배치의 일정 비율에 기존 웹 시각-언어 데이터를 상시 혼합하는 공동 미세조정(Co-Fine-Tuning) 기법을 도입했습니다.
3. 오픈소스와 경량화의 민주화: OpenVLA (2024)
RT-2는 뛰어났지만 55B의 거대한 몸집 탓에 구글 클라우드 TPU 수십 대가 연결된 서버에서만 돌아갔고, 코드가 공개되지 않은 폐쇄적 시스템이었습니다.
2024년 여름, 스탠퍼드 대학교와 UC 버클리 연구진은 대규모 로봇 데이터셋(Open X-Embodiment, 97만 궤적)을 기반으로 훈련된 세계 최초의 7B급 오픈소스 범용 VLA 모델인 OpenVLA를 공개했습니다.
               +-------------------------------------------+
               |             RGB 카메라 이미지 입력        |
               +---------------------+---------------------+
                                     |
                       +-------------+-------------+
                       |                           |
                       v                           v
             +--------------------+     +--------------------+
             |   SigLIP 인코더    |     |   DINOv2 인코더    |
             | (고수준 시각 의미) |     | (저수준 3차원 공간 |
             |                    |     |  패치 기하학 정보) |
             +---------+----------+     +----------+---------+
                       |                           |
                       +-------------+-------------+
                                     | (채널 축 특징 결합 / Concatenation)
                                     v
                        +----------------------------+
                        |    2계층 MLP 프로젝터      |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |   Llama-2 7B 언어 백본     |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |  256개 분위수 행동 토큰    |
                        +----------------------------+
1. 이중 시각 융합: SigLIP + DINOv2 (Prismatic VLM)
로봇 제어는 일반 텍스트 캡셔닝과 다릅니다. "컵이 있다"는 의미뿐 아니라, **"컵 손잡이가 오른쪽으로 정확히 몇 밀리미터 돌출되어 있는가"**라는 정밀한 공간 기하학이 핵심입니다:
- SigLIP (의미 인코더): 언어-시각 고차원 의미 연결에 탁월.
- DINOv2 (기하 공간 인코더): 고해상도 픽셀 깊이와 경계선 윤곽 추출에 탁월.
- 두 인코더의 특징 텐서를 채널 축으로 결합함으로써, 로봇의 미세 잡기 정확도를 20% 이상 향상시켰습니다.
2. 분위수 빈닝 (Quantile Binning)
RT-2의 균등 분할 방식은 심각한 문제를 안고 있었습니다. 실제 로봇 조작 데이터의 90%는 '1밀리미터 단위의 섬세한 미세 조작'이고, 빠르게 팔을 휘두르는 모션은 1% 미만입니다.
- OpenVLA는 97만 개 궤적의 실제 누적 분포에서 분위수(Quantile)를 계산하여 구간을 지능적으로 분할했습니다:
\text{구간 경계값: } q_k = \text{Quantile}\left(\mathcal{D}_{\text{actions}}, \frac{k}{256}\right), \quad k \in [0, 256]
- 미세 모션이 집중된 구간에 토큰 해상도를 집중 배정함으로써 정밀 조작 성공률을 극대화했습니다.
3. LoRA 1.4% 파라미터 미세조정과 단일 RTX 4090 구동
- 시각 인코더를 동결하고 Llama-2 백본의 단 1.4% 파라미터만 LoRA로 미세조정하여, 새로운 로봇 팔 환경에 단 15시간 만에 완벽히 적응합니다.
- 4비트 양자화(NF4)를 적용해 GPU 메모리를 7GB로 압축, 연구실의 흔한 단일 게이밍 GPU(RTX 4090) 1장에서도 6Hz의 실시간 제어를 달성했습니다.
- 결과적으로 OpenVLA는 55B 크기의 RT-2-X보다 7배 작으면서도 29개 실제 로봇 과제에서 평균 성공률이 16.5% 더 높은 압도적인 성능을 기록했습니다.
4. 연속 제어의 최전선: 피지컬 인텔리전스 $\pi_0$ (2024)
RT-2와 OpenVLA의 대성공에도 불구하고 이산 토큰 방식에는 한계가 존재합니다:
- 256개 구간으로 쪼개는 과정에서 생기는 양자화 오차가 고주파 제어($>50\textHz$) 시 모터의 미세한 떨림(Jittering)을 유발합니다.
- 빨래 개기, 종이 상자 접기, 유연한 전선 다루기 같은 비정형 유연 물체 조작은 매끄러운 연속 제어를 요구합니다.
대니 드리스 박사가 몸담은 Physical Intelligence 연구진은 최신 모델 **$\pi_0$ (pi-zero)**를 통해 플로우 매칭(Flow Matching) 확산 정책을 선보였습니다:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Physical Intelligence π₀ 아키텍처                      │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ 고수준 VLM 계획기        │                   │ 연속 확산 플로우 매칭 정책│
├──────────────────────────┤                   ├───────────────────────────┤
│ • 시각 장면 의미 파악    │                   │ • 50Hz 초고속 실시간 추론 │
│ • 장기 계획 수립         │ ── 잠재 목표 벡터 ─► • 연속 벡터장 역확산 생성 │
│ • 다단계 하위 목표 추적  │                   │ • 모터 떨림(Jittering) 0% │
└──────────────────────────┘                   └─────────────┬─────────────┘
                                                             │
                                                             ▼
                                               [매끄러운 다차원 연속 궤적]
                                               (빨래 개기, 상자 접기 정복)
$\pi_0$는 언어 모델이 고수준 목표를 수립하면, 말단 제어기에서 이미지 생성 AI처럼 매끄러운 연속 다차원 궤적(Continuous Trajectory)을 노이즈 제거 방식으로 실시간 생성하여 인간 수준의 부드러운 유연 물체 조작을 최초로 달성했습니다.
5. 아키텍처 비교: 로보틱스 파운데이션 모델
+-----------------------+----------------------------------+----------------------------------+
| 비교 항목             | RT-2 (Google DeepMind)           | OpenVLA (Stanford / Berkeley)    |
+-----------------------+----------------------------------+----------------------------------+
| 모델 크기             | 55B (PaLI-X) / 12B (PaLM-E)      | 7B (Llama-2 언어 백본)           |
| 시각 인코더           | 단일 ViT                         | 이중 융합 (SigLIP + DINOv2)      |
| 행동 이산화 방식      | 256개 균등 빈닝 (Uniform)        | 256개 분위수 빈닝 (Quantile)     |
| 하드웨어 요구사항     | 멀티 TPU 클라우드 서버           | 단일 게이밍 GPU (RTX 4090 1장)   |
| 파라미터 효율성       | 전 가중치 미세조정               | 1.4% LoRA + 4비트 양자화         |
| 오픈소스 공개 여부    | 비공개 (Closed / Proprietary)    | 100% 가중치 및 코드 완전 공개    |
+-----------------------+----------------------------------+----------------------------------+
6. 체화된 인공지능의 안전: 2중 반사 신경망 하네스
물리적 로봇 팔은 오작동 시 사람을 다치게 하거나 주변 기물을 파손할 수 있습니다. 엔지니어링 현장에서는 2중 안전 하네스를 필수로 탑재합니다:
[VLA 모델 행동 출력: 7자유도 모터 델타]
                 │
                 ▼
[1계층: 소프트웨어 속도 및 작업 영역 클리핑]
  ├── 최대 이동 속도 제한: 1스텝당 ||Δpos|| <= 5cm
  └── 3차원 안전 가상 펜스(Bounding Box) 이탈 방지
                 │
                 ▼
[2계층: 하드웨어 힘-토크 센서 반사 루프 (1000 Hz)]
  ├── 외부 접촉 저항력 F_contact > 20N 감지 시:
  └── VLA 명령 즉각 무시 -> 비상 정지 / 유연 순응 모드 강제 전환
- 소프트웨어 행동 클리핑: VLA 모델이 출력한 관절 변화량이 물리적 안전 기준을 초과하면 하위 모터 드라이버에서 강제로 한계치로 자르고 안전 펜스를 벗어나지 못하게 차단합니다.
- 하드웨어 힘-토크 반사 루프: 1000Hz 주기로 작동하는 하드웨어 센서가 예상치 못한 충돌(사람의 팔 접촉 등)을 감지하는 순간, VLA의 지시를 무시하고 즉시 모터의 전원을 차단하거나 부드럽게 힘을 빼는 물리적 반사신경을 발동합니다.
7. 핵심 엔지니어링 요약
- 물리적 행동은 언어의 또 다른 모달리티: 연속 모터를 이산 토큰으로 변환함으로써, 인터넷 규모의 사전 학습 지식을 물리적 제어기로 성공적으로 전이시켰습니다.
- 이중 시각 융합의 필수성: 의미론(SigLIP)과 고해상도 3D 공간 기하학(DINOv2)의 결합이 로봇의 미세 조작 성공률을 결정합니다.
- 분위수 빈닝의 위력: 실제 데이터 분포에 맞춘 분위수 분할이 섬세한 1밀리미터 제어 해상도를 확보해 줍니다.
- 연속 확산 정책이 로보틱스의 미래: $\pi_0$와 같은 플로우 매칭 정책이 이산 토큰의 떨림을 제거하고 유연 물체 조작을 가능하게 합니다.
다음 **Lecture 17 (GRAND FINALE)**에서는 전 17개 강의를 총결산하며, **《Future Research Directions: 자가 진화 에이전트의 미래 연구 방향과 미해결 과제》**를 통해 인공 일반 지능(AGI)을 향한 마지막 대서사시를 완성하겠습니다. 최종화에서 뵙겠습니다!