[마음지기 캡스톤 개발일지 #7] 합성 데이터(v5) 생성 최적화와 프론트엔드 연동
· 약 2분

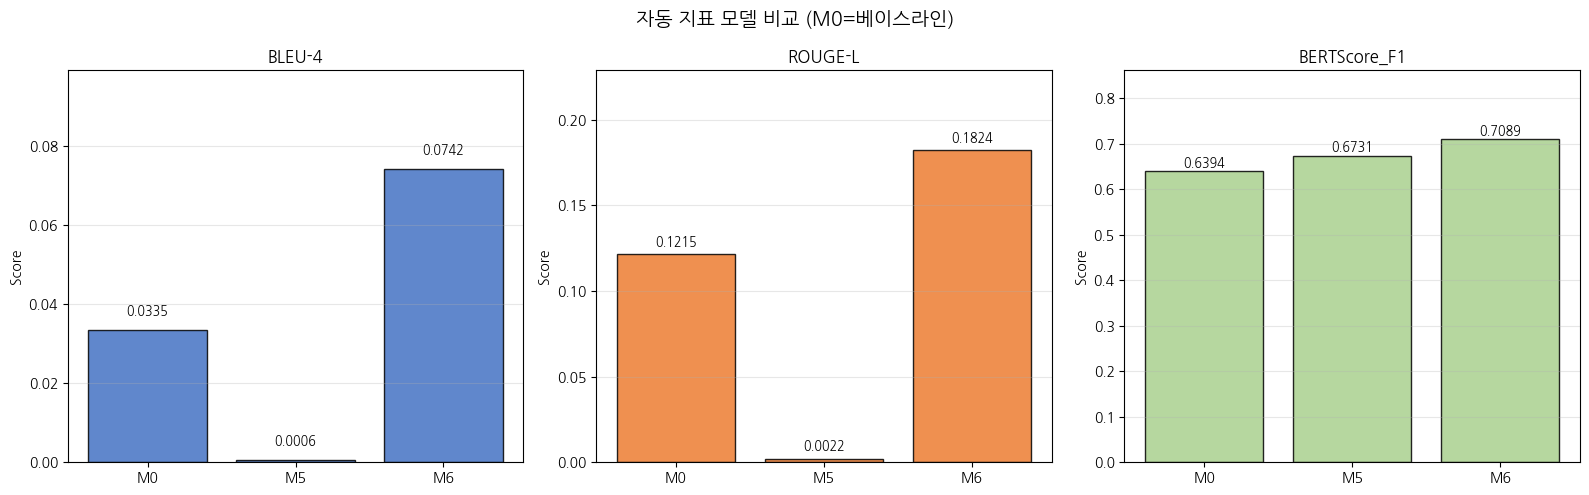
4월 7일은 팀원이 구축한 프론트엔드(mental-health) 코드를 로컬 환경에서 실행해 보며 통합을 시도한 날이자, AI를 활용해 부족한 상담 데이터를 6만 건이나 새롭게 '합성(Synthesis)'해내는 거대한 스크립트를 가동한 날입니다.
4월 7일은 팀원이 구축한 프론트엔드(mental-health) 코드를 로컬 환경에서 실행해 보며 통합을 시도한 날이자, AI를 활용해 부족한 상담 데이터를 6만 건이나 새롭게 '합성(Synthesis)'해내는 거대한 스크립트를 가동한 날입니다.
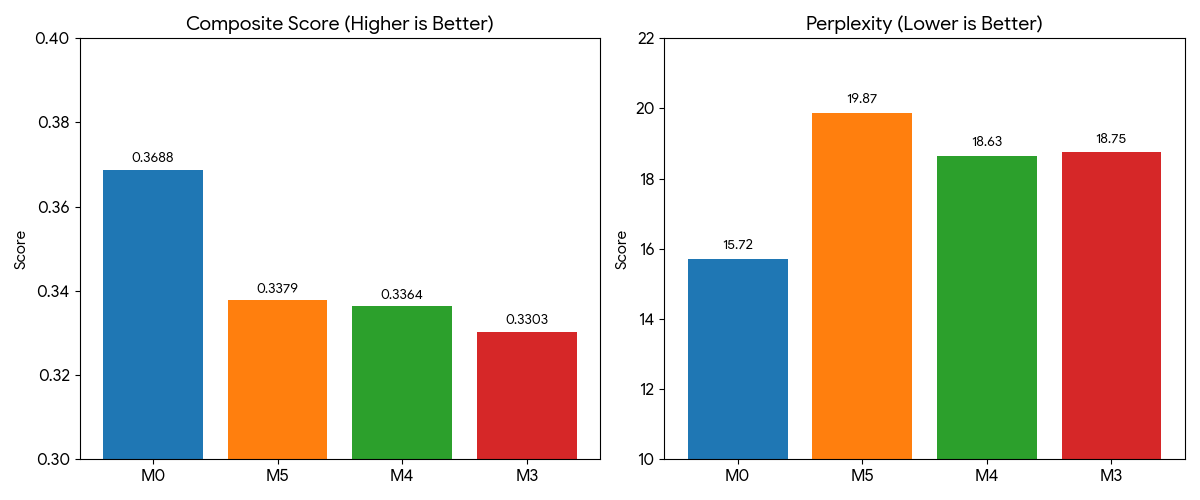
4월 3일, 본격적으로 딥러닝 모델(Llama 3.1)에 먹일 훈련용 대화 데이터를 정제하는 작업에 착수한 날의 기록입니다. 단순히 데이터를 합치는 것을 넘어, AI가 텍스트를 보고 스스로 감정을 판별하게 만드는 거대한 파이프라인을 돌려본 날이기도 합니다.