[Stanford CS329A #4] 도구 사용과 코드 실행 피드백: ReAct, RLEF, 그리고 헌법적 자가 교정

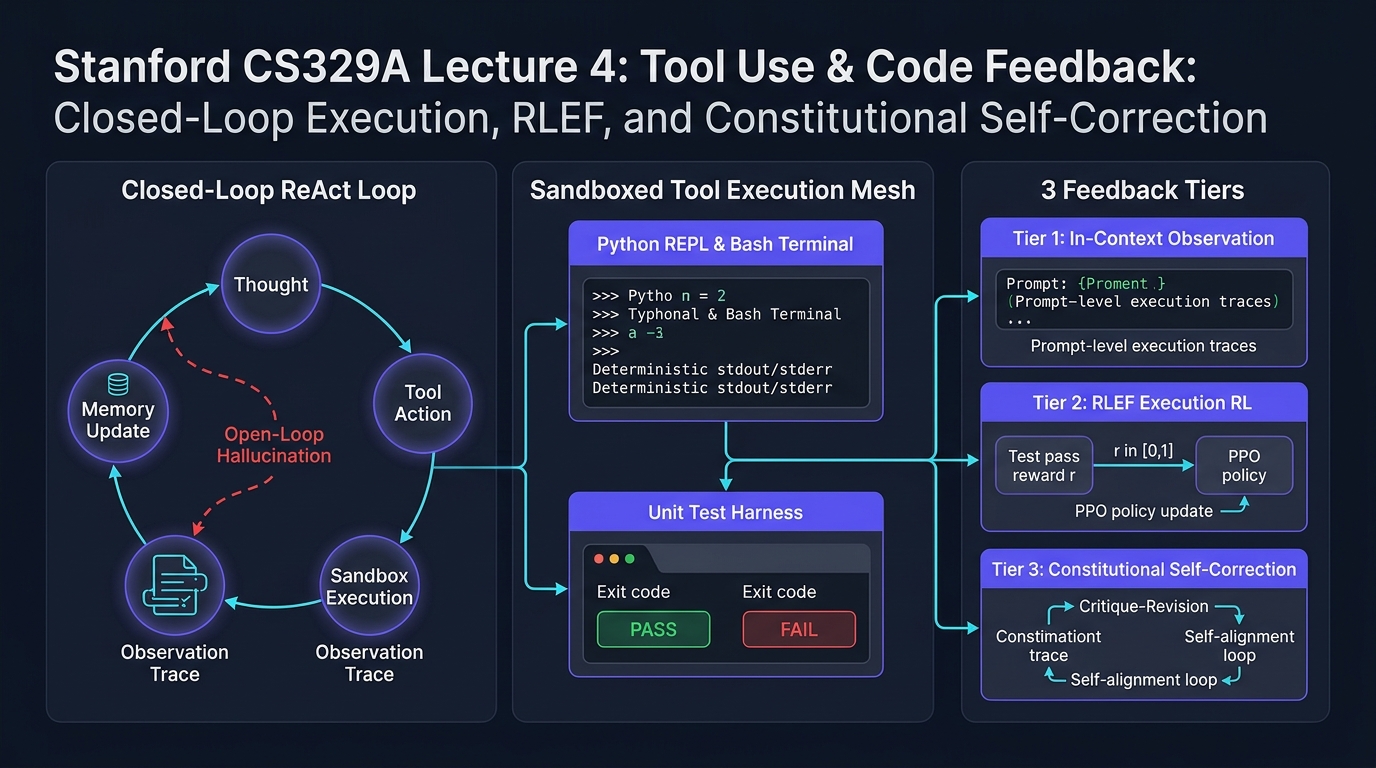
스탠포드 대학교의 최신 2025 가을학기 대학원 강좌, CS329A: Self-Improving AI Agents (스스로 발전하는 AI 에이전트) 네 번째 기술 해설에 오신 것을 환영합니다.
지난 제2강과 제3강에서 우리는 추론 시간 연산 확장(Test-time Compute Scaling)과 프로세스 보상 모델(PRM)을 통해 언어 모델이 추론 트리를 탐색하고 중간 수학적 단계를 스스로 검증하는 원리를 깊이 있게 살펴보았습니다. 그러나 정교한 추론 체인을 아무리 전개할지라도, 순수 텍스트 생성에만 머무르는 언어 모델은 여전히 **"방 안에 갇혀 시험지만 푸는 수험생"**과 같습니다. 모델은 사전 훈련 과정에서 습득한 정적이고 동결된 파라미터 기억(Parametric Memory)에만 전적으로 의존하기 때문입니다. 끊임없이 변하는 외부 사실, 동적 API, 혹은 문법적으로 엄격한 코드 실행 환경과 마주했을 때, 현실 세계와 단절된 모델은 필연적으로 그럴듯한 환각(Hallucination)에 빠지고 맙니다.
오늘 제4강은 모델을 폐쇄된 방 밖으로 끄집어내는 결정적인 패러다임 전환점입니다. 바로 **도구 사용(Tool Use)과 실행 피드백 루프(Execution Feedback Loops)**를 다룹니다.
현대 자율형 에이전트는 코드나 API 호출을 단순한 텍스트 출력 결과물로 취급하지 않고, 외부 환경과 상호작용하는 센서이자 액추에이터로 활용합니다. 이번 강의에서는 정적 언어 모델을 자율형 폐쇄 루프 에이전트로 탈바꿈시키는 3대 핵심 피드백 계층을 분해하고 재설계합니다:
- 프롬프트 수준 환경 피드백 (Prompt-Level): 사고와 행동을 유기적으로 엮어내는 ReAct (Yao et al., 2022)
- 정책 수준 실행 피드백 (Policy-Level): 컴파일러와 테스트 러너의 실행 진단 결과를 신경망 가중치에 직접 새겨넣는 RLEF (Reinforcement Learning from Execution Feedback, 2024)
- 자가 감독 가치 정렬 (Self-Supervision): 고비용 인간 평가자를 자연어 원칙 기반의 비평-수정 루프로 대체하는 Constitutional AI (Anthropic, 2022)
flowchart TD
    subgraph ClosedLoop ["폐쇄 루프 에이전트 아키텍처 (Closed-Loop)"]
        direction TB
        Agent["자율 에이전트 코어 (LLM Policy)"]
        Thought["내부 언어 사고 (Thought Space L)"]
        Action["실행 가능한 도구 호출 (Action Space A)"]
        Sandbox["격리 실행 샌드박스 (Python REPL / Shell / Search)"]
        Obs["결정론적 환경 관찰 결과 (Stdout / Stderr)"]

        Agent --> Thought
        Thought --> Action
        Action --> Sandbox
        Sandbox --> Obs
        Obs -->|"피드백 컨텍스트 갱신 (c_{t+1})"| Agent
    end

    subgraph FeedbackTiers ["에이전트 피드백의 3대 진화 계층"]
        direction TB
        T1["계층 1: 인컨텍스트 환경 피드백 (ReAct)<br/>• 교차 사고-행동 루프: Thought + Action + Observation<br/>• 지식 검색 시 사실 날조 환각율 0% 달성"]
        --> T2["계층 2: 정책 수준 실행 피드백 (RLEF)<br/>• 마르코프 결정 과정(MDP) 정식화: State, Action, Sandbox Reward<br/>• 공개/비공개 이원화 테스트셋 기반 PPO 최적화<br/>• Llama-3.1-70B: CodeContests 1@3 정답률 27.5%에서 40.1%로 폭증"]
        --> T3["계층 3: 자율적 가치 자가 교정 (Constitutional AI)<br/>• 자연어 원칙(헌법) 기반 비평-수정 SFT 데이터 구축<br/>• AI 피드백 강화학습(RLAIF) 기반 선호 보상 모델 학습<br/>• 인간 라벨링 확장성 병목의 완전한 해소"]
    end

    ClosedLoop ==> FeedbackTiers