[Stanford CS329A #6] 훈련 시점 확장과 강화학습: DeepSeekMath, GRPO, 그리고 대규모 추론 최적화

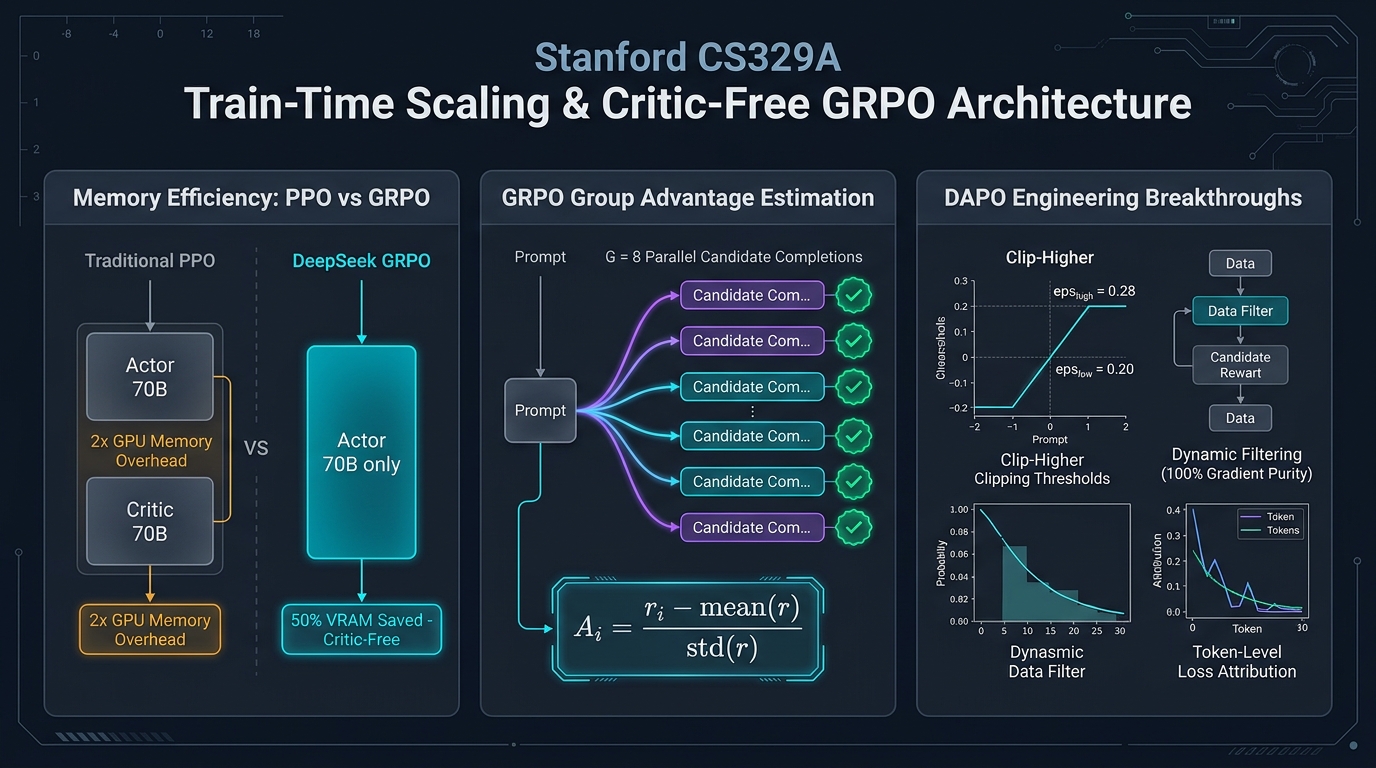
스탠포드 대학교의 2025 가을학기 최신 대학원 강좌, CS329A: Self-Improving AI Agents (스스로 발전하는 AI 에이전트) 여섯 번째 기술 해설에 오신 것을 환영합니다.
지난 제1강부터 제5강까지의 **Part 1 (Foundation · 기초 이론)**을 통해, 우리는 이미 훈련이 완료되어 동결된 언어 모델에 추론 시간 연산(Test-time Compute)을 쏟아부어 성능을 한계까지 끌어올리는 법을 배웠습니다. MCTS 트리 탐색을 돌리고, 터미널 실행 에러를 주입하며, 약한 검증기 앙상블로 오답을 걸러냈습니다.
하지만 이제 냉정하게 현실적인 한계를 직시해야 합니다: 초등학생에게 시험 시간을 10분 더 준다고 해서 대학 미적분학의 복잡한 증명을 풀어낼 수 있을까요? 모델 자체의 동결된 신경망 시냅스(가중치 파라미터, $\theta$) 내부에 해당 수학적 개념과 논리 체계가 전혀 존재하지 않는다면, 수천 번의 주사위를 굴리고 빔 서치를 돌려본들 그것은 진정한 지능이 아니라 확률적 요행수에 불과합니다.
오늘부터 시작되는 **Part 2: Training & Evolution (훈련 및 자가 진화, 제6강~제9강)**은 바로 이 근본적인 질문에 답하는 대장정입니다:
"추론 시간에 비싼 탐색 꼼수를 쓰는 대신, 훈련 시간(Train-time)에 대규모 연산량을 투입하여 모델의 두뇌 가중치 자체를 영구히 똑똑하게 진화시킬 수는 없는가?"
오늘 제6강에서는 인간의 라벨링 병목을 깨부수고 최첨단 추론 모델을 탄생시킨 **사후 강화학습(Post-Training RL)**의 핵심 알고리즘 3가지를 깊이 있게 해체하고 재설계합니다:
- 자가 생성 추론으로 자기를 가르치는: STaR (Self-Taught Reasoner, Zelikman et al., Stanford 2022)
- 크리틱(Critic)을 제거한 강화학습 혁명: DeepSeekMath와 GRPO (Group Relative Policy Optimization, 2024)
- 천 개 GPU 규모의 산업용 엔지니어링 기법: DAPO (Decoupled Clip & Dynamic Sampling, 2025)
flowchart TD
    subgraph ParadigmShift ["패러다임의 거대한 전환: 추론 시간 vs 훈련 시간"]
        direction TB
        TestTime["Part 1: 추론 시간 확장 (Test-Time Scaling)<br/>• 신경망 가중치 동결 (θ = 불변)<br/>• 외부 런타임 탐색 (MCTS, ReAct, RLEF)<br/>• 사용자 응답 지연 시간 및 서빙 비용 증가"]
        --> TrainTime["Part 2: 훈련 시간 확장 (Train-Time RL)<br/>• 능동적 가중치 경사 하강 업데이트 (θ ← θ + Δθ)<br/>• 강화학습을 통해 전략적 계획 직관을 시냅스에 내재화<br/>• 단일 패스(Single-Pass) 초고속 추론 달성"]
    end

    subgraph RLEvolution ["수학적 추론 강화학습의 3단계 진화"]
        direction TB
        M1["STaR (스탠포드 2022)<br/>• 모델이 스스로 맞힌 풀이만 모아 자가 지도학습<br/>• 사후 합리화(Rationalization): 정답 힌트로 역방향 다리 놓기<br/>• 6B 모델로 175B GPT-3 수준 성능 달성"]
        --> M2["GRPO (DeepSeekMath 2024)<br/>• 별도의 Critic 가치 모델 완전 제거 (GPU VRAM 50% 절감)<br/>• G개 그룹 롤아웃 간 상대적 Z-score로 Advantage 계산<br/>• 7B 오픈소스 모델로 구글 Minerva 540B 격파"]
        --> M3["DAPO (대규모 실전 엔지니어링 2025)<br/>• 비대칭 Clip-Higher (0.28 vs 0.20)로 엔트로피 붕괴 차단<br/>• 다이내믹 샘플링으로 분산 0인 무효 배치 100% 필터링<br/>• Qwen-32B로 DeepSeek-R1-Zero의 AIME 기록 50% 스텝만에 돌파"]
    end

    ParadigmShift ==> RLEvolution