[Stanford CS329A #3] 견고한 답변 검증: 프로세스 보상 모델(PRM), 앙상블, 그리고 확장 가능한 감독

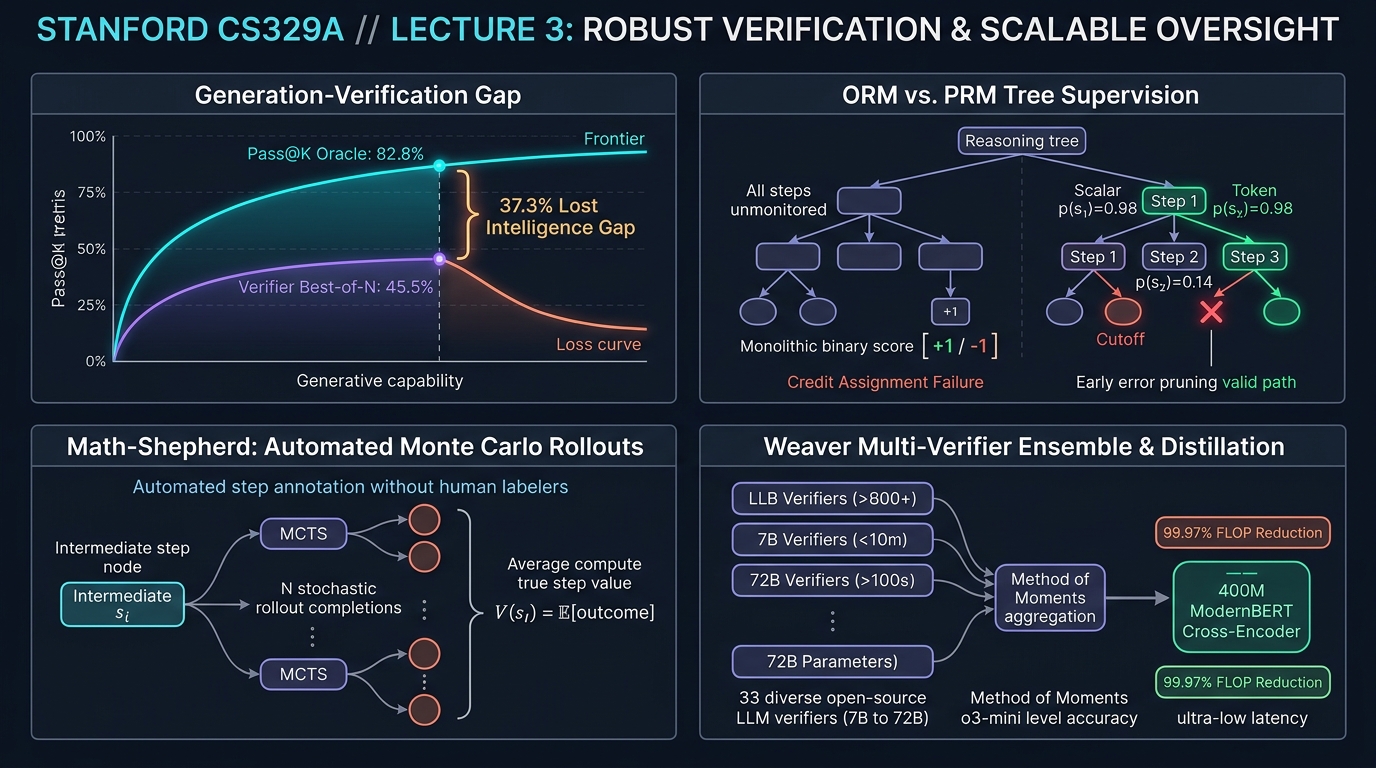
스탠포드 대학교의 2025년 가을 학기 최신 대학원 강좌, CS329A: Self-Improving AI Agents (스스로 발전하는 AI 에이전트) 세 번째 엔지니어링 해설에 오신 것을 환영합니다.
지난 제2강에서 우리는 추론 시간 연산 확장(Test-time Compute Scaling)을 배우며 매우 중요하고 본질적인 결론에 도달했습니다: 수천 개의 답변 후보($pass@k$)를 생성하면 정답 커버리지는 99%를 상회하지만, **"그 수많은 오답의 더미 속에서 진짜 정답을 골라낼 정밀한 검증기(Verifier)가 없다면 다수결 투표(Majority Vote)든 뭐든 성능이 완전히 정체(Plateau)된다"**는 사실이었습니다.
오늘 제3강에서는 이 병목을 정면으로 돌파하는 핵심 시스템 기술, 바로 **견고한 답변 검증 (Robust Verification)**을 다룹니다.
인간 수학자나 소프트웨어 엔지니어도 복잡한 문제를 풀 때 한 번의 거침없는 직진으로 정답에 도달하지 않습니다. 한 줄의 논리를 전개하고, 수식의 정합성을 검토하며, 사소한 부호 실수를 발견하면 즉시 이전 단계로 되돌아가(Backtracking) 수정을 거칩니다. 반면, 표준적인 자기회귀(Autoregressive) 언어 모델은 오직 앞 방향으로만 토큰을 방출합니다. 초반에 사소한 논리적 비약이 발생하면, 모델은 자신의 초기 오류를 정당화하기 위해 갈수록 더 그럴듯한 환각(Hallucination)을 지어내게 됩니다.
그렇다면 "모델이 생성한 중간 추론 단계를 다른 검증 모델이 꼼꼼하게 검사하고 가지치기(Pruning)하게 만들 수는 없을까?"
OpenAI의 기념비적 연구인 Cobbe의 GSM8K 검증기부터, Lightman의 단계별 과정 감독(PRM800K), 인간 라벨러 없이 몬테카를로 롤아웃으로 자가 채점하는 Math-Shepherd, 그리고 여러 개의 약한 검증기를 통계역학적으로 엮어 o3-mini급 성능을 뽑아내는 최신 Weaver(NeurIPS 2025) 연구까지, 검증기 엔지니어링(Verifier Engineering)의 정점을 체계적으로 마스터해 보겠습니다.
flowchart TD
    subgraph Gap ["핵심 문제: 생성-검증 격차 (Generation-Verification Gap)"]
        direction TB
        G1["Pass@100 오라클 상한선: 82.8% (이론적 최대 잠재력)"]
        G2["다수결 투표 실제 성공률: 45.5% (실제 추출 성능)"]
        G1 -.->|"선택 실패로 소멸하는 37.3%p의 지능"| G2
    end

    subgraph Solutions ["답변 검증 시스템의 4단계 진화"]
        direction TB
        S1["결과 보상 모델 (ORM)<br/>• 최종 답안에만 이진 점수(+1 / -1) 부여<br/>• 신용 할당 실패(Credit Assignment Failure)"]
        --> S2["프로세스 보상 모델 (PRM800K)<br/>• 토큰 레벨 단계별 감독 p(step_i)<br/>• 초기 오류 감지 시 즉각 가지치기 및 확률 곱 평가"]
        --> S3["Math-Shepherd (비지도 MCTS 롤아웃)<br/>• 인간 라벨러 없는 자동 몬테카를로 단계 채점<br/>• 인간 작업 PRM800K 대비 우수한 벤치마크 달성"]
        --> S4["Weaver 약한 검증기 앙상블<br/>• 모멘트 방법(Method of Moments) 기반 비지도 통합 (33개 검증기)<br/>• 400M ModernBERT 크로스 인코더 증류 (연산량 99.97% 절감)"]
    end

    Gap ==> Solutions