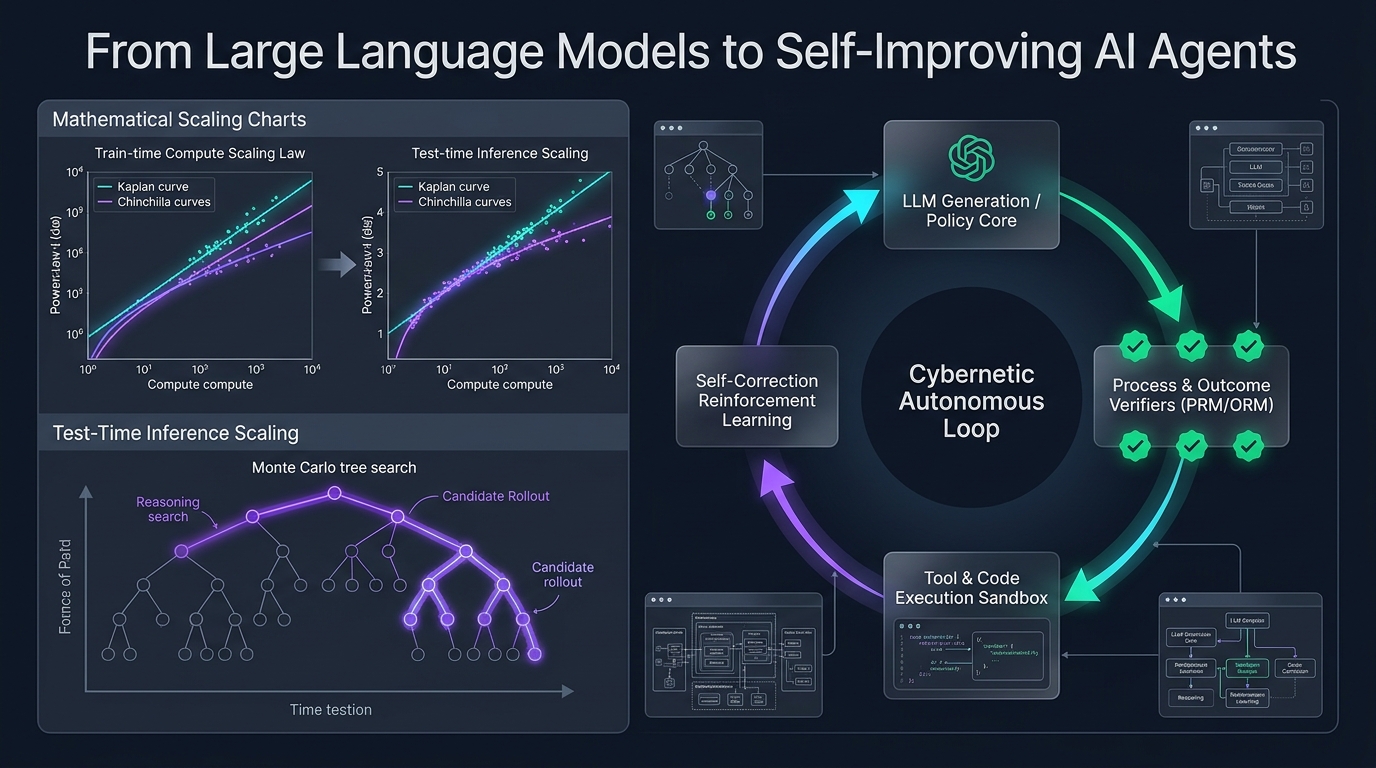
[Stanford CS329A #2] 추론 시간 연산 확장: 사전 훈련 스케일링 법칙을 넘어 연산 최적 추론으로

스탠포드 대학교의 2025년 가을 학기 최신 대학원 강좌, CS329A: Self-Improving AI Agents (스스로 발전하는 AI 에이전트) 두 번째 엔지니어링 해설에 오신 것을 환영합니다.
지난 제1강에서 우리는 정적(Static) 차세대 토큰 예측기에 불과하던 거대 언어 모델(LLM)이 환경과 피드백 루프를 주고받는 완전 자율 에이전트로 진화하는 거대한 패러다임 전환을 개괄했습니다. 오늘 제2강에서는 이 자율성을 지탱하는 가장 본질적인 수학적·컴퓨팅적 기둥, 바로 **추론 시간 연산 확장 (Test-Time Compute Scaling / Inference-Time Scaling)**을 다룹니다.
지난 수년간 AI 산업을 지배한 유일한 교리는 사전 훈련 단계의 스케일링 법칙(Kaplan et al., Chinchilla)이었습니다: 더 거대한 GPU 클러스터를 구축하고, 파라미터 크기 N을 수천억 단위로 키우며, 수십조 개의 웹 텍스트 토큰 D를 투입하라. 그러나 사전 훈련을 마친 가중치 θ가 동결(Frozen)된 모델에게 질문을 던졌을 때, 50밀리초 만에 성급한 탐욕적(Greedy) 답변을 내놓게 두는 대신 10초, 1분, 10분 동안 깊이 사고하고, 중간 단계를 검증하며, 가설을 스스로 수정하도록 연산(FLOPs)을 쏟아붓는다면 어떤 일이 벌어질까요?
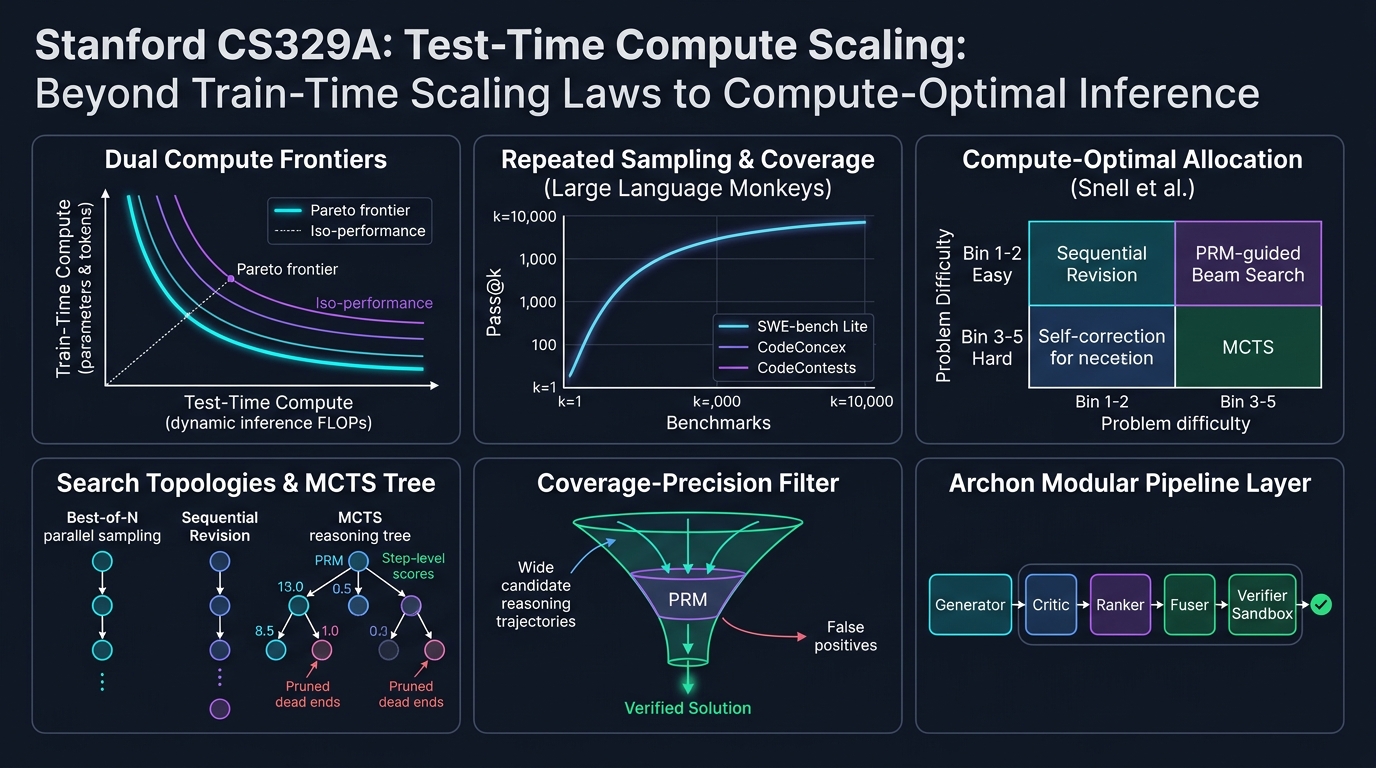
Large Language Monkeys (Brown et al., 2024), 스탠포드-버클리 Charlie Snell 연구팀의 Compute-Optimal Scaling (Snell et al., 2024), 그리고 Archon 모듈형 아키텍처 탐색 프레임워크를 통해 **"추론 연산(FLOPs)을 투입하여 파라미터 용량을 압도하는 현대 인공지능의 최신 최적화 법칙"**을 정밀하게 파헤쳐 보겠습니다.
flowchart TD
    subgraph PreTrain ["고전적 개척지: 훈련 연산 확장 (Train-Time Scaling)"]
        direction TB
        P1["수십조 개 공개 웹 토큰 (D)"] --> P2["수만 장 규모 초대형 GPU 클러스터 (C_train)"]
        P2 --> P3["사후 동결된 고밀도 모델 (θ)"]
        P3 --> P4["단일 순방향 패스 추론 (O(1) 고정 추론 연산)"]
    end

    subgraph TestTime ["CS329A 최전선: 추론 시간 연산 확장 (Test-Time Compute Scaling)"]
        direction TB
        T1["동결된 기본 가중치 (θ)"] --> T2["동적 추론 연산량 (FLOPs) 가변 투입"]
        T2 --> T3{"문제 난이도 적응형 전략 선택"}
        T3 -- "낮은 난이도 (Bin 1-2)" --> T4["순차적 수정 (Sequential Revision: 자가 교정)"]
        T3 -- "높은 난이도 (Bin 3-5)" --> T5["PRM 기반 트리 탐색 (MCTS / 빔 서치)"]
        T4 --> T6["프로세스 보상 모델 (PRM) 검증기"]
        T5 --> T6
        T6 --> T7["수학적·기계적으로 증명된 최종 정답 추출"]
    end

    PreTrain -.->|"변곡점: 파라미터 확장 한계 도달"| TestTime