[마음지기 캡스톤 개발일지 #23] Safety Wrapper 도입과 1학기 최종 발표
· 약 2분

6월에 접어들며 마음지기 팀은 1학기 캡스톤 디자인의 굵직한 개발을 모두 마치고, 릴리즈를 위한 안전망 구축과 최종 발표 준비에 총력을 기울였습니다.
6월에 접어들며 마음지기 팀은 1학기 캡스톤 디자인의 굵직한 개발을 모두 마치고, 릴리즈를 위한 안전망 구축과 최종 발표 준비에 총력을 기울였습니다.
5월의 마지막 주(27일~30일), 저희는 대망의 4차 파인튜닝(fine_tuning_4) 결과를 갈무리하고 시스템의 뼈대를 굳히는 작업에 매진했습니다.
5월 21일과 22일, 마음지기 캡스톤 팀은 대규모 데이터 생성과 4차 파인튜닝(fine_tuning_4) 준비에 돌입했습니다.
5월 19일과 20일 이틀 동안은 3차 파인튜닝(fine_tuning_3)의 평가 자동화와 더불어, 실제 앱(App) 서비스 구축을 위한 백엔드/프론트엔드 기능 고도화 작업이 병렬로 진행되었습니다.
제가 이전에 "5월 13일이 마음지기 5월 개발의 마지막일 것"이라고 착각했던 것을 정정합니다! 5월 17일, 어마어마한 양의 백엔드 연동 테스트와 보고서 작업이 몰아쳤습니다.
어제 발견했던 하드코딩 버그를 모두 고치고, 드디어 제대로 된 2차 파인튜닝 모델들의 추론(Inference) 테스트를 재개한 5월 13일입니다.
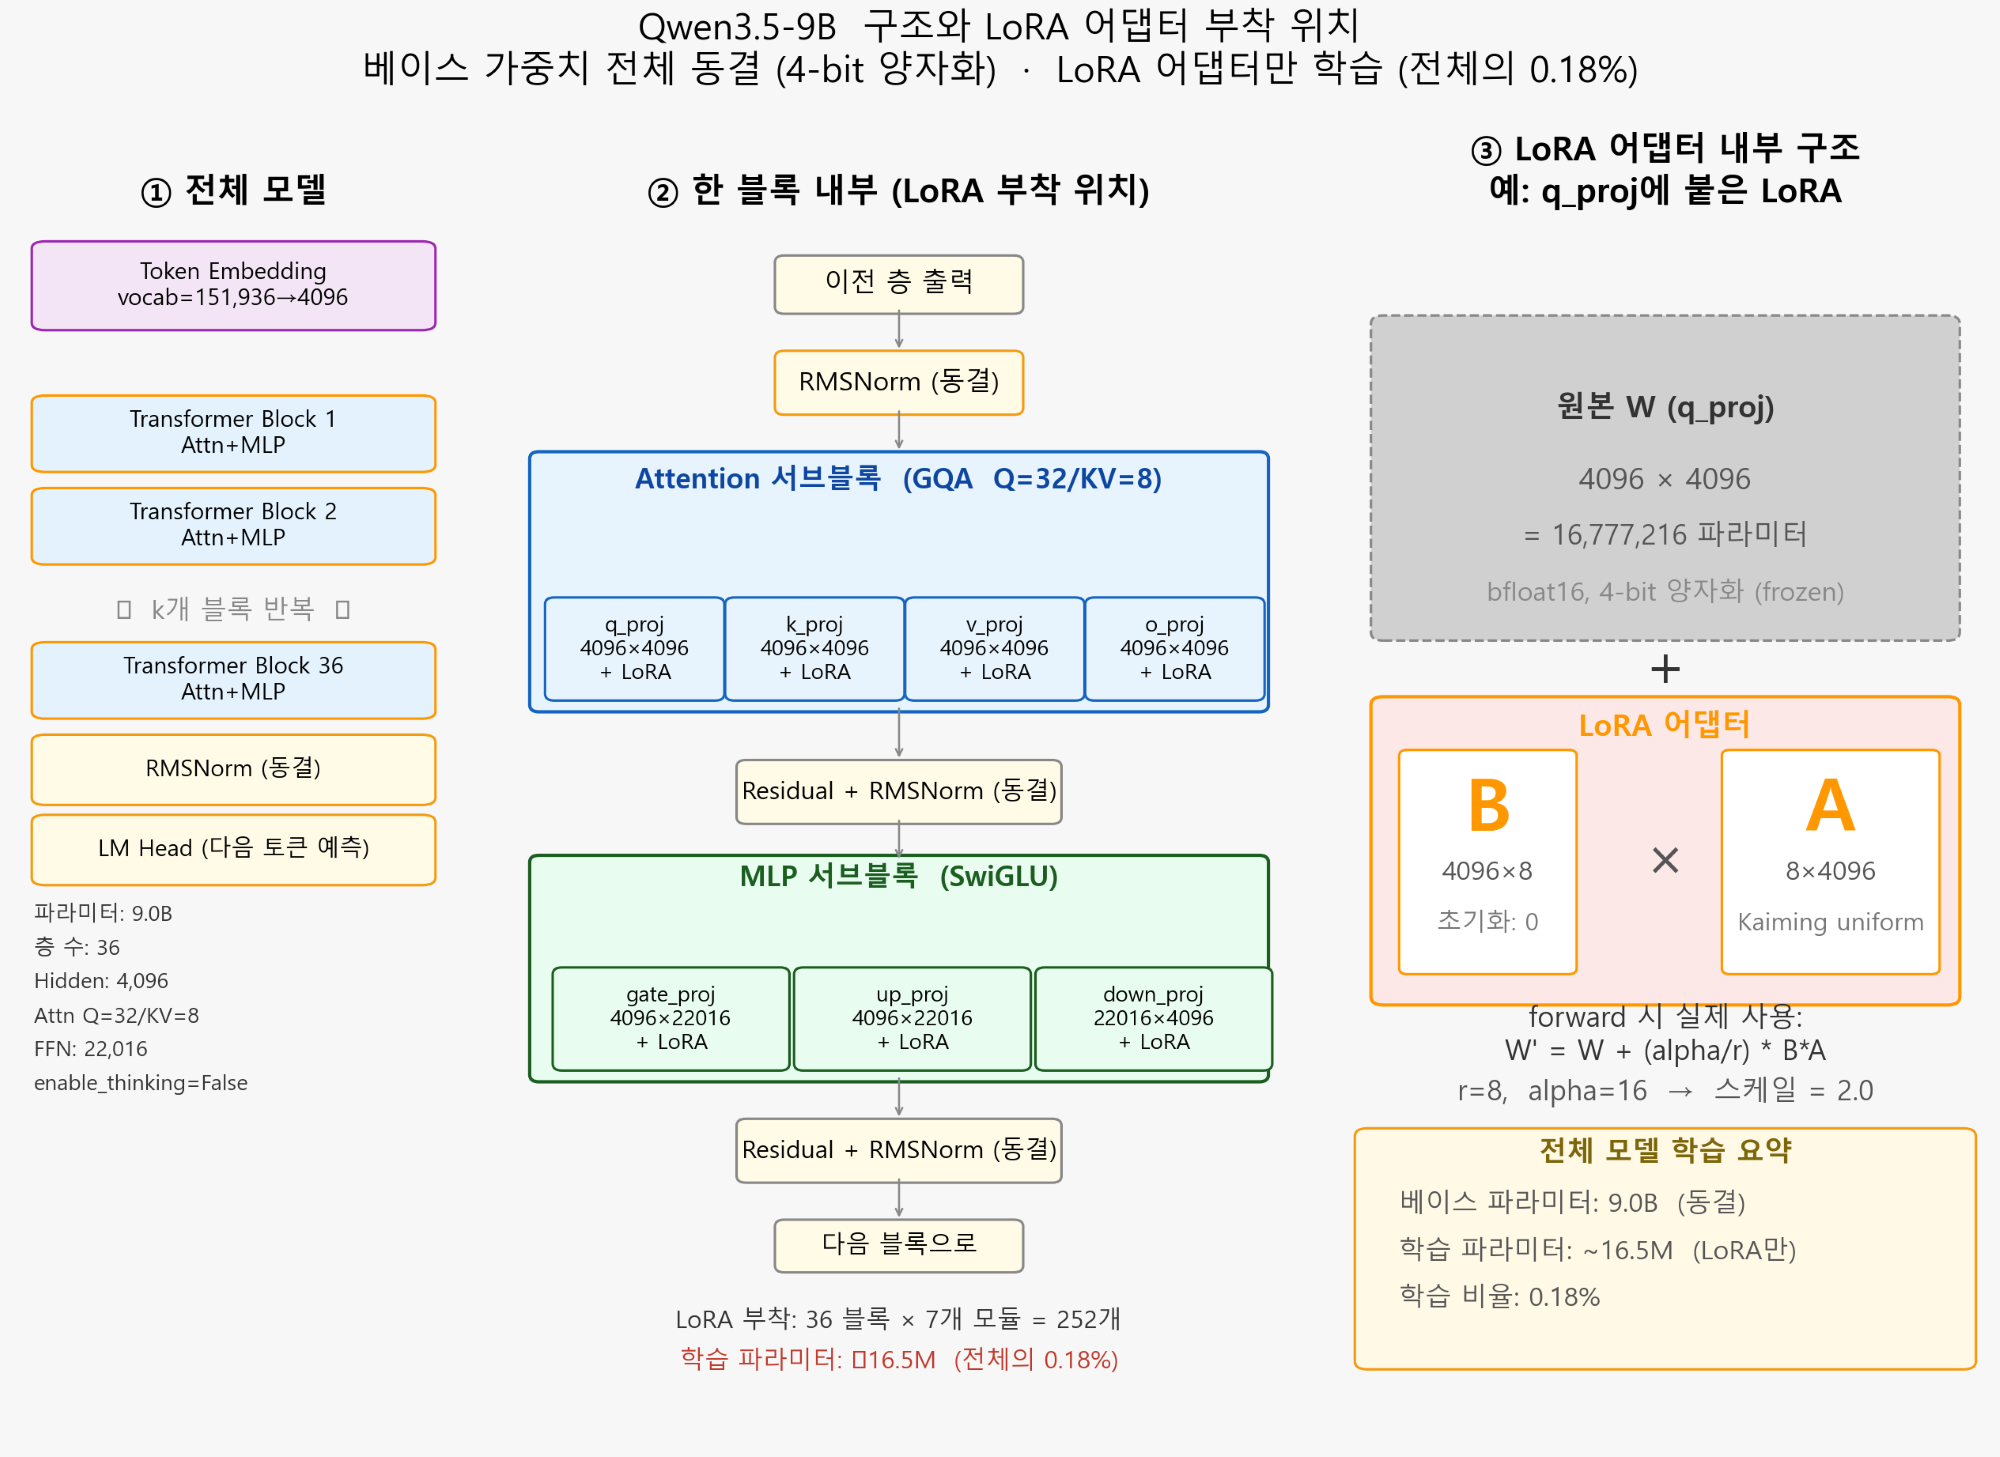
LoRA 하이퍼파라미터 실수(alpha/rank 설정 오류)를 바로잡기 위해 야심 차게 시작했던 2차 파인튜닝(fine_tuning_2) 병렬 학습이 5월 12일 마침내 끝이 났습니다!
5월 8일은 그동안 뽑아낸 파인튜닝 결과들을 바탕으로 캡스톤디자인 중간 발표 자료(PPT)를 만들던 날이었습니다. 하지만 기분 좋게 슬라이드를 채워나가던 중, 등골이 서늘해지는 엄청난 실수를 발견하고 말았습니다.
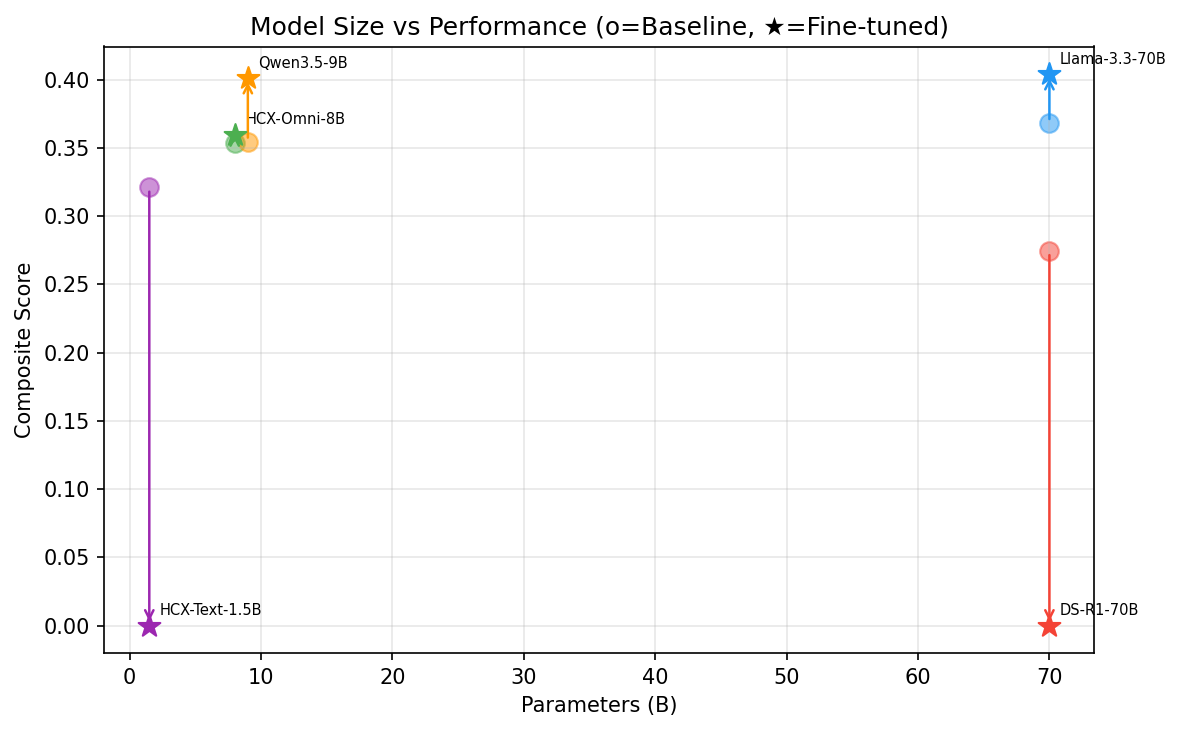
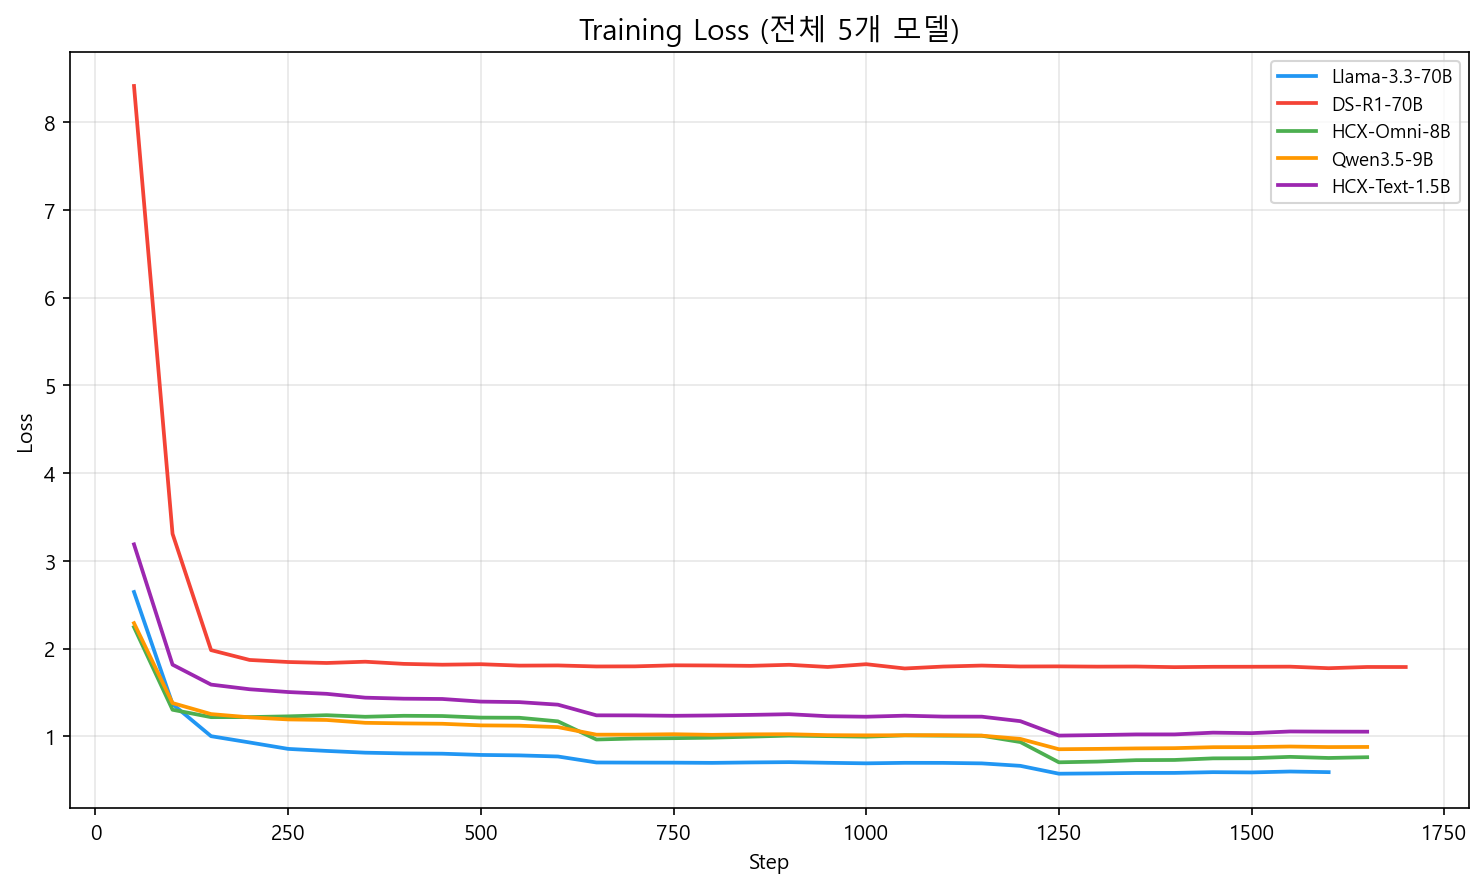
5월 7일은 그동안 피땀 흘려 파인튜닝한 총 5개의 모델(Llama3.3-70B, DSR1-70B, HCX-Omni-8B, Qwen35-9B, HCX-Text-1.5B)의 결과를 집대성하고, 본격적인 시각화와 로컬 환경 구성을 진행한 날입니다.
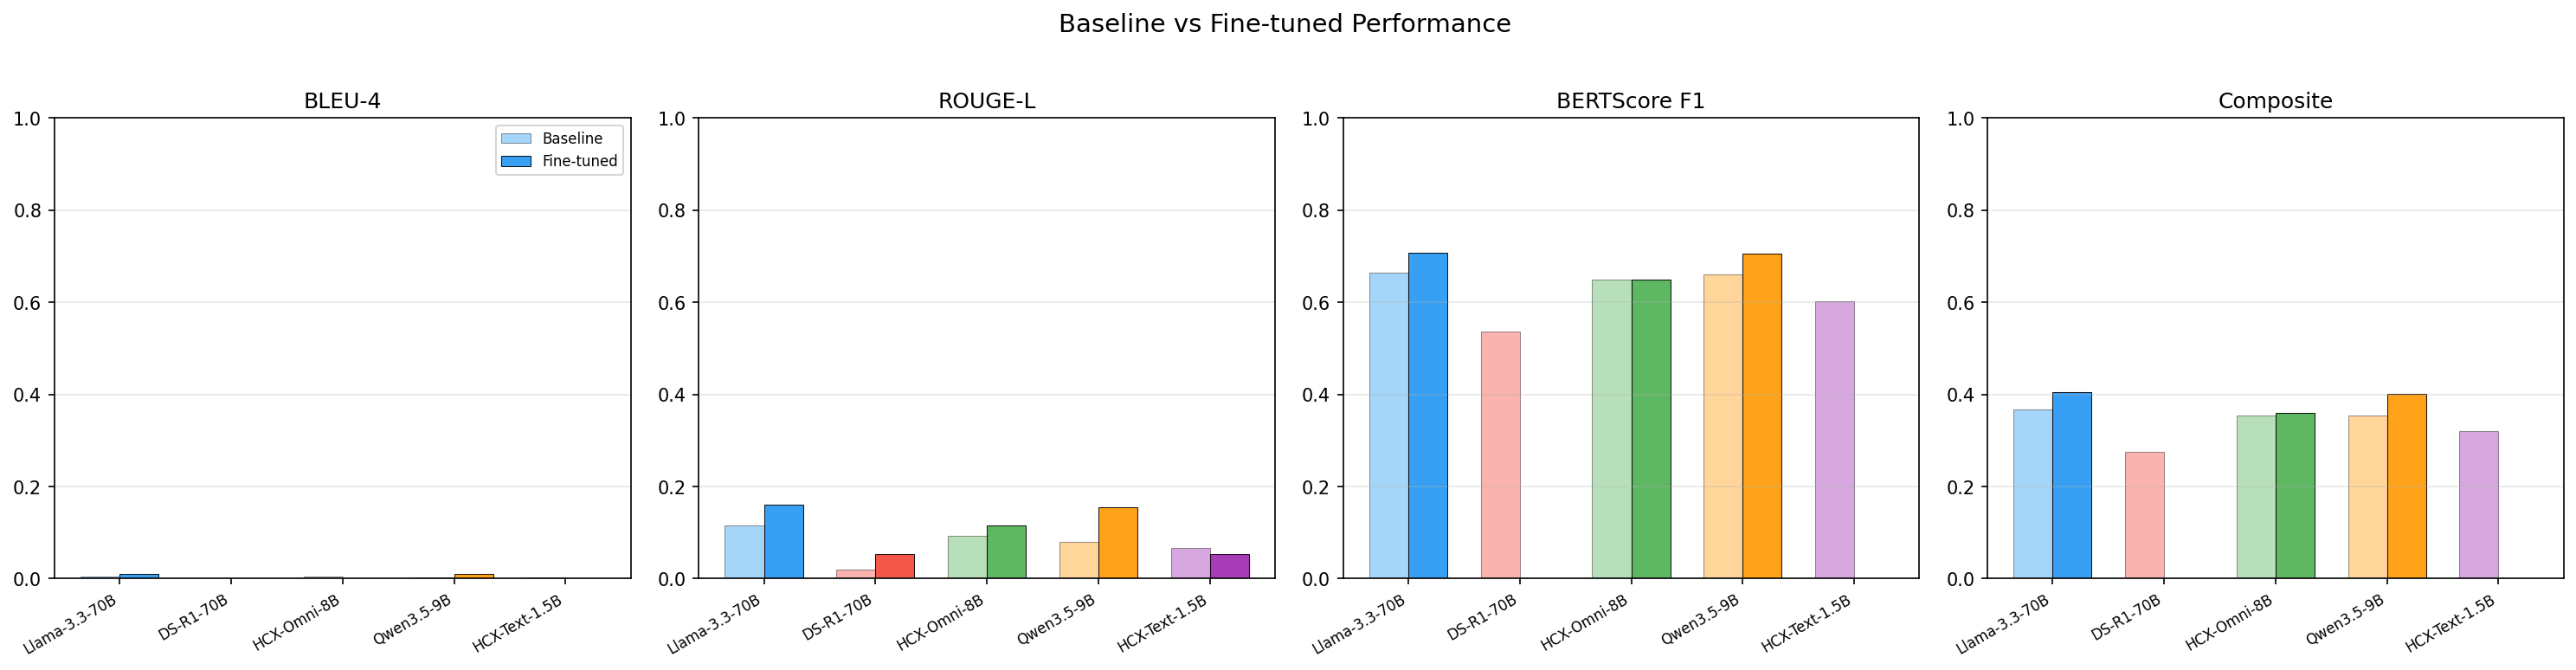
5월 6일, 드디어 길고 길었던 파인튜닝의 늪에서 빠져나왔습니다! 며칠간의 밤샘 작업과 하이퍼파라미터 조율 끝에 HCX-Omni-8B와 Qwen35-9B 등 중소형 모델들의 학습이 성공적으로 마무리되었습니다.
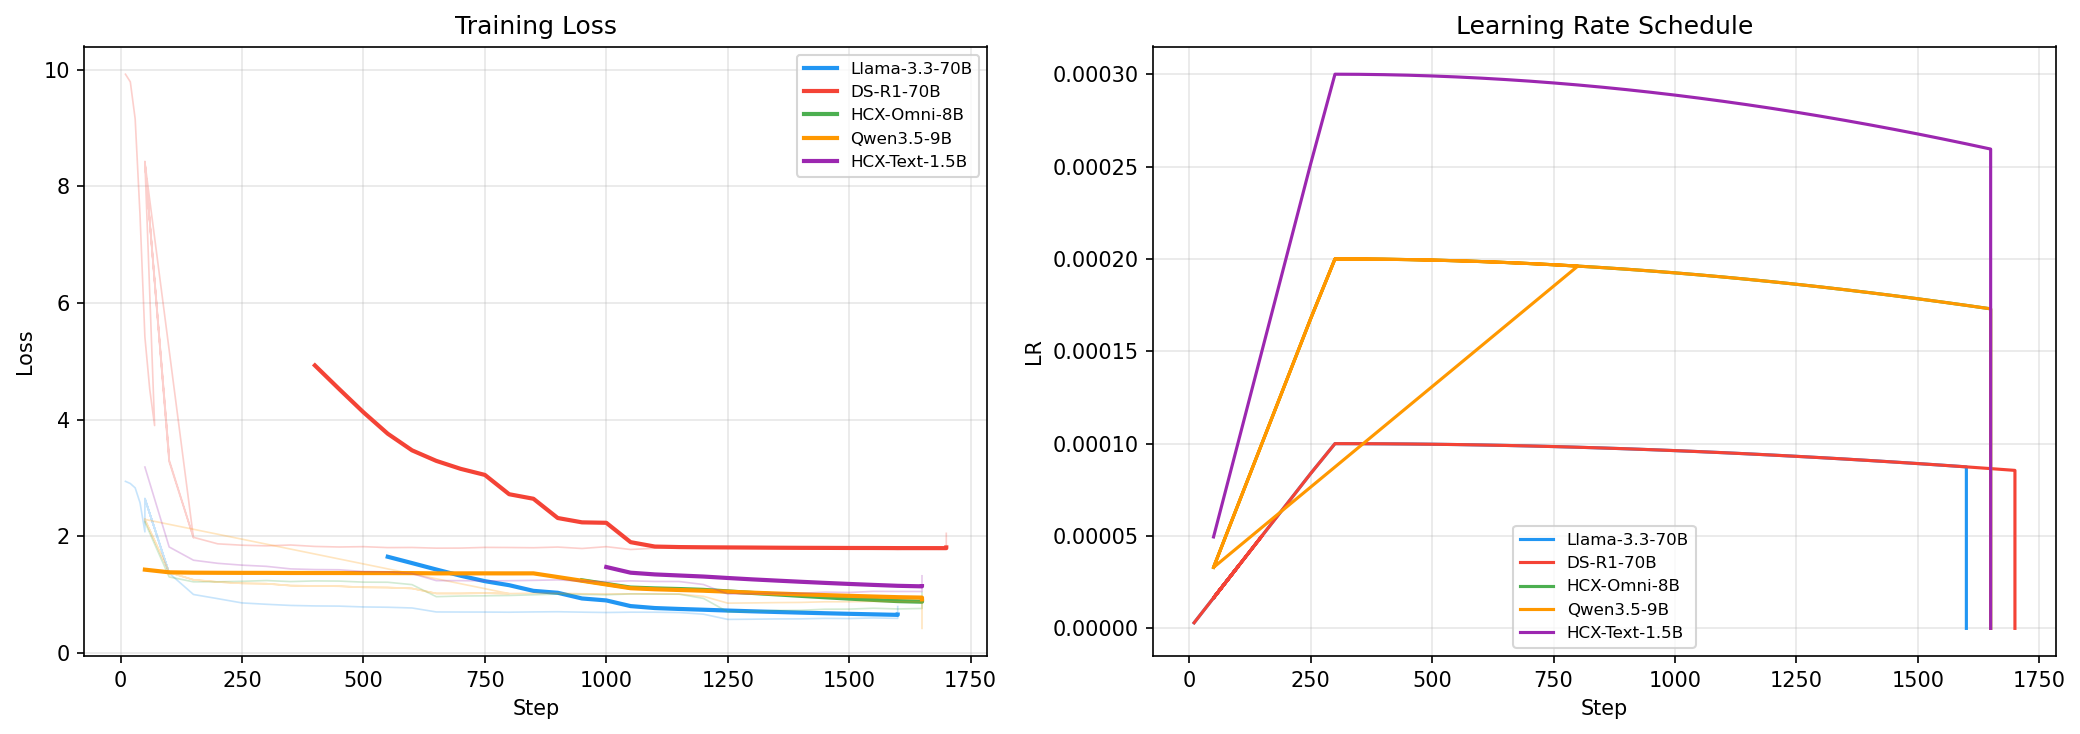
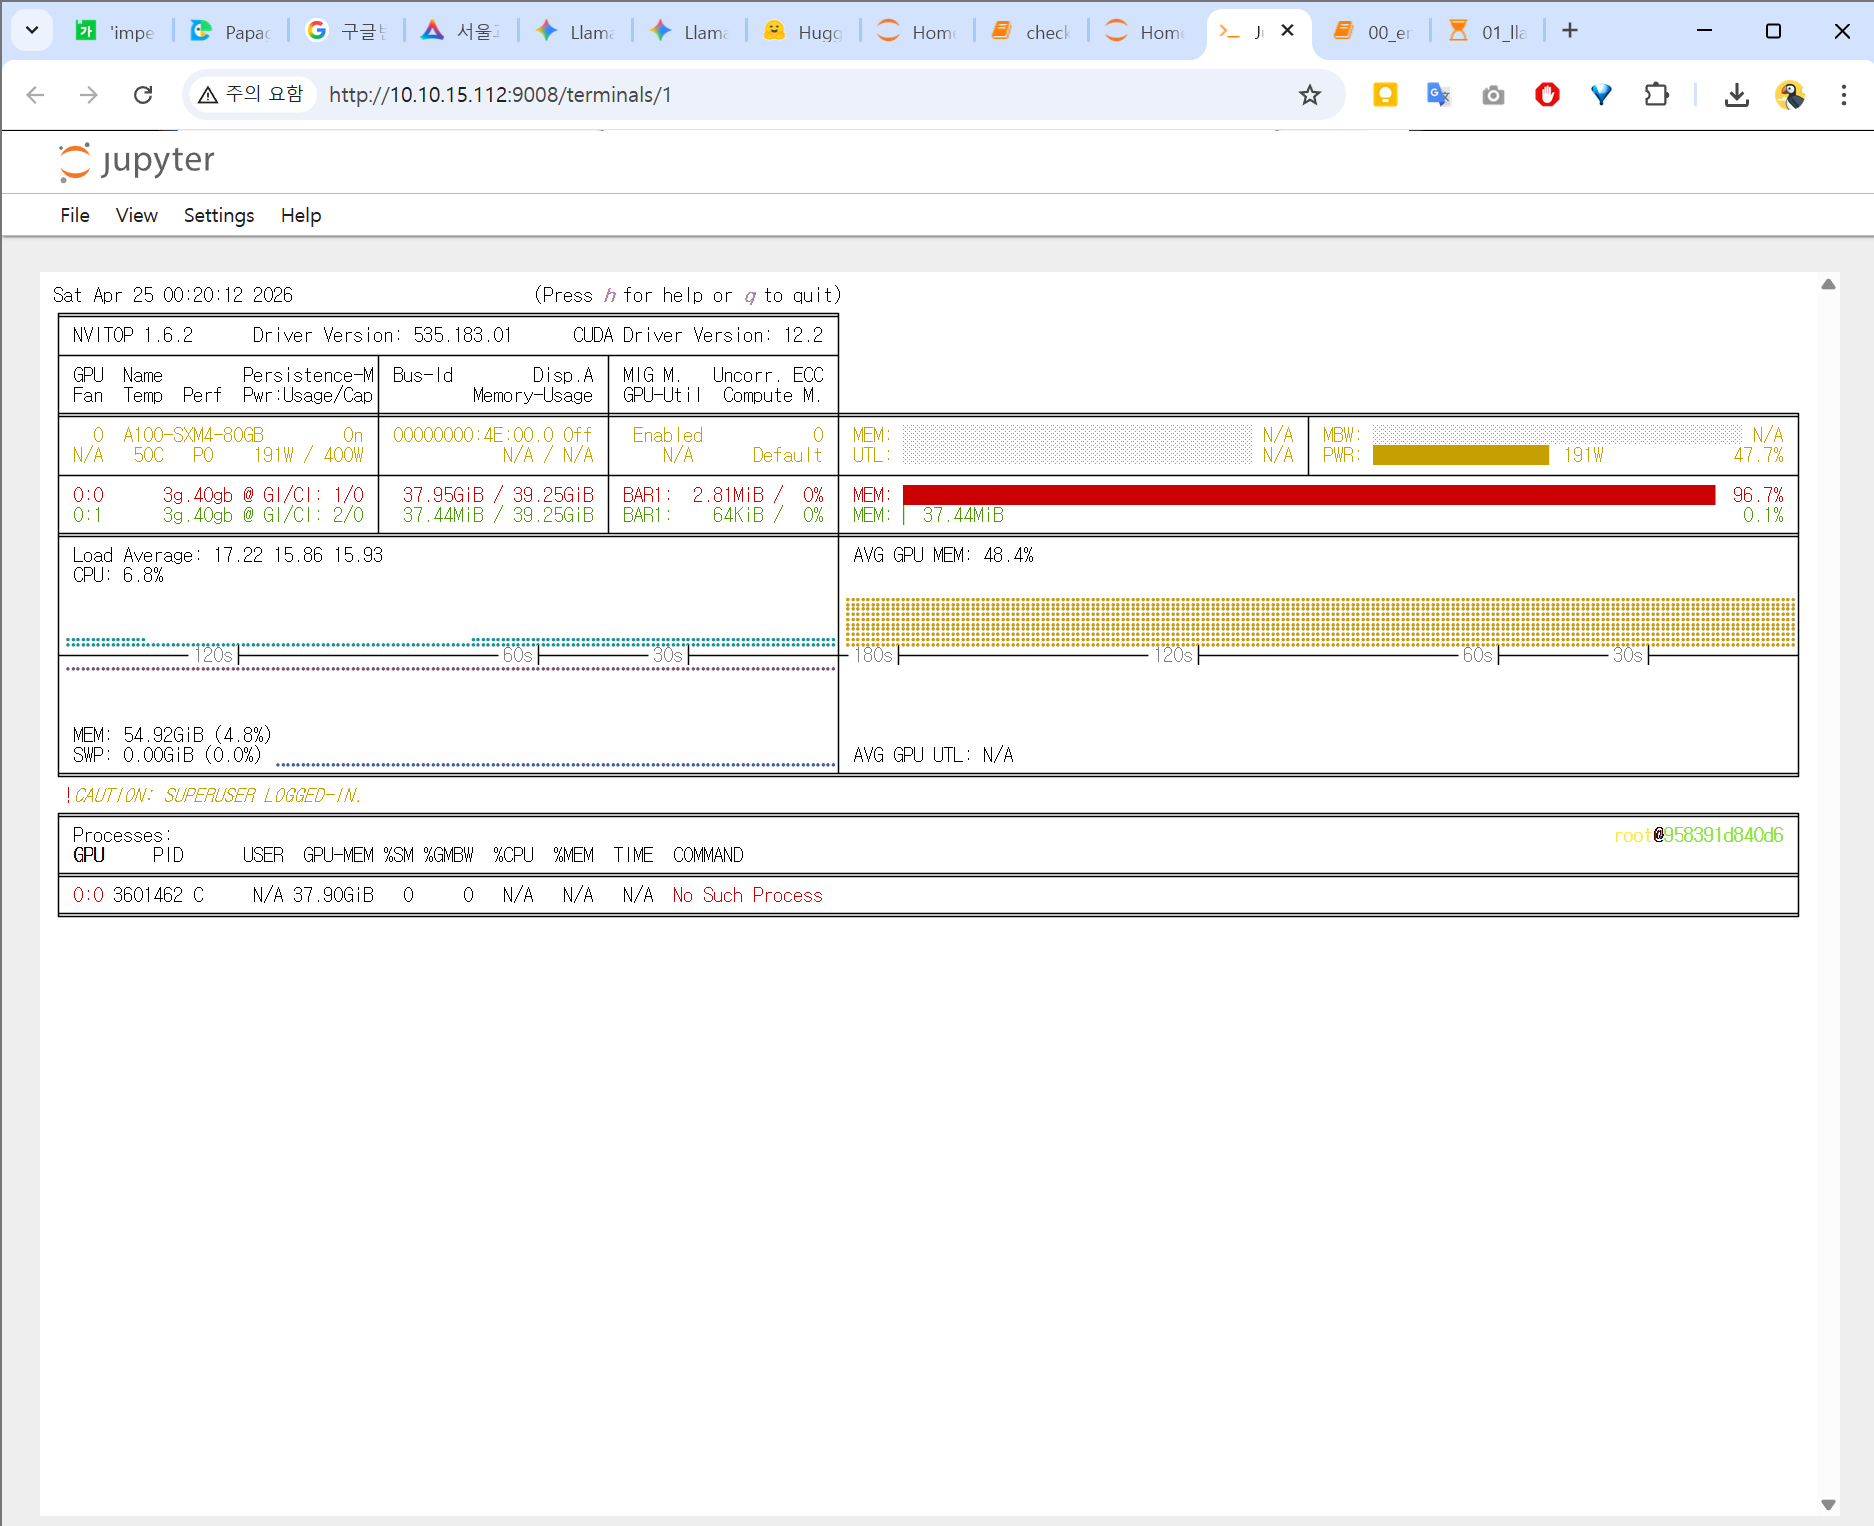
70B라는 거대한 모델의 파인튜닝 과정에서 발생한 OOM(메모리 부족) 지옥을 경험한 5월 4일, 저희는 과감한 전략 변경을 시도했습니다. 70B 모델(Llama3.3, DeepSeek-R1)은 배치 사이즈를 극단적으로 줄여 겨우 checkpoint-1200, 1300까지 진행시켰지만, 학습 시간이 너무 오래 걸려 효율이 극악이었습니다.
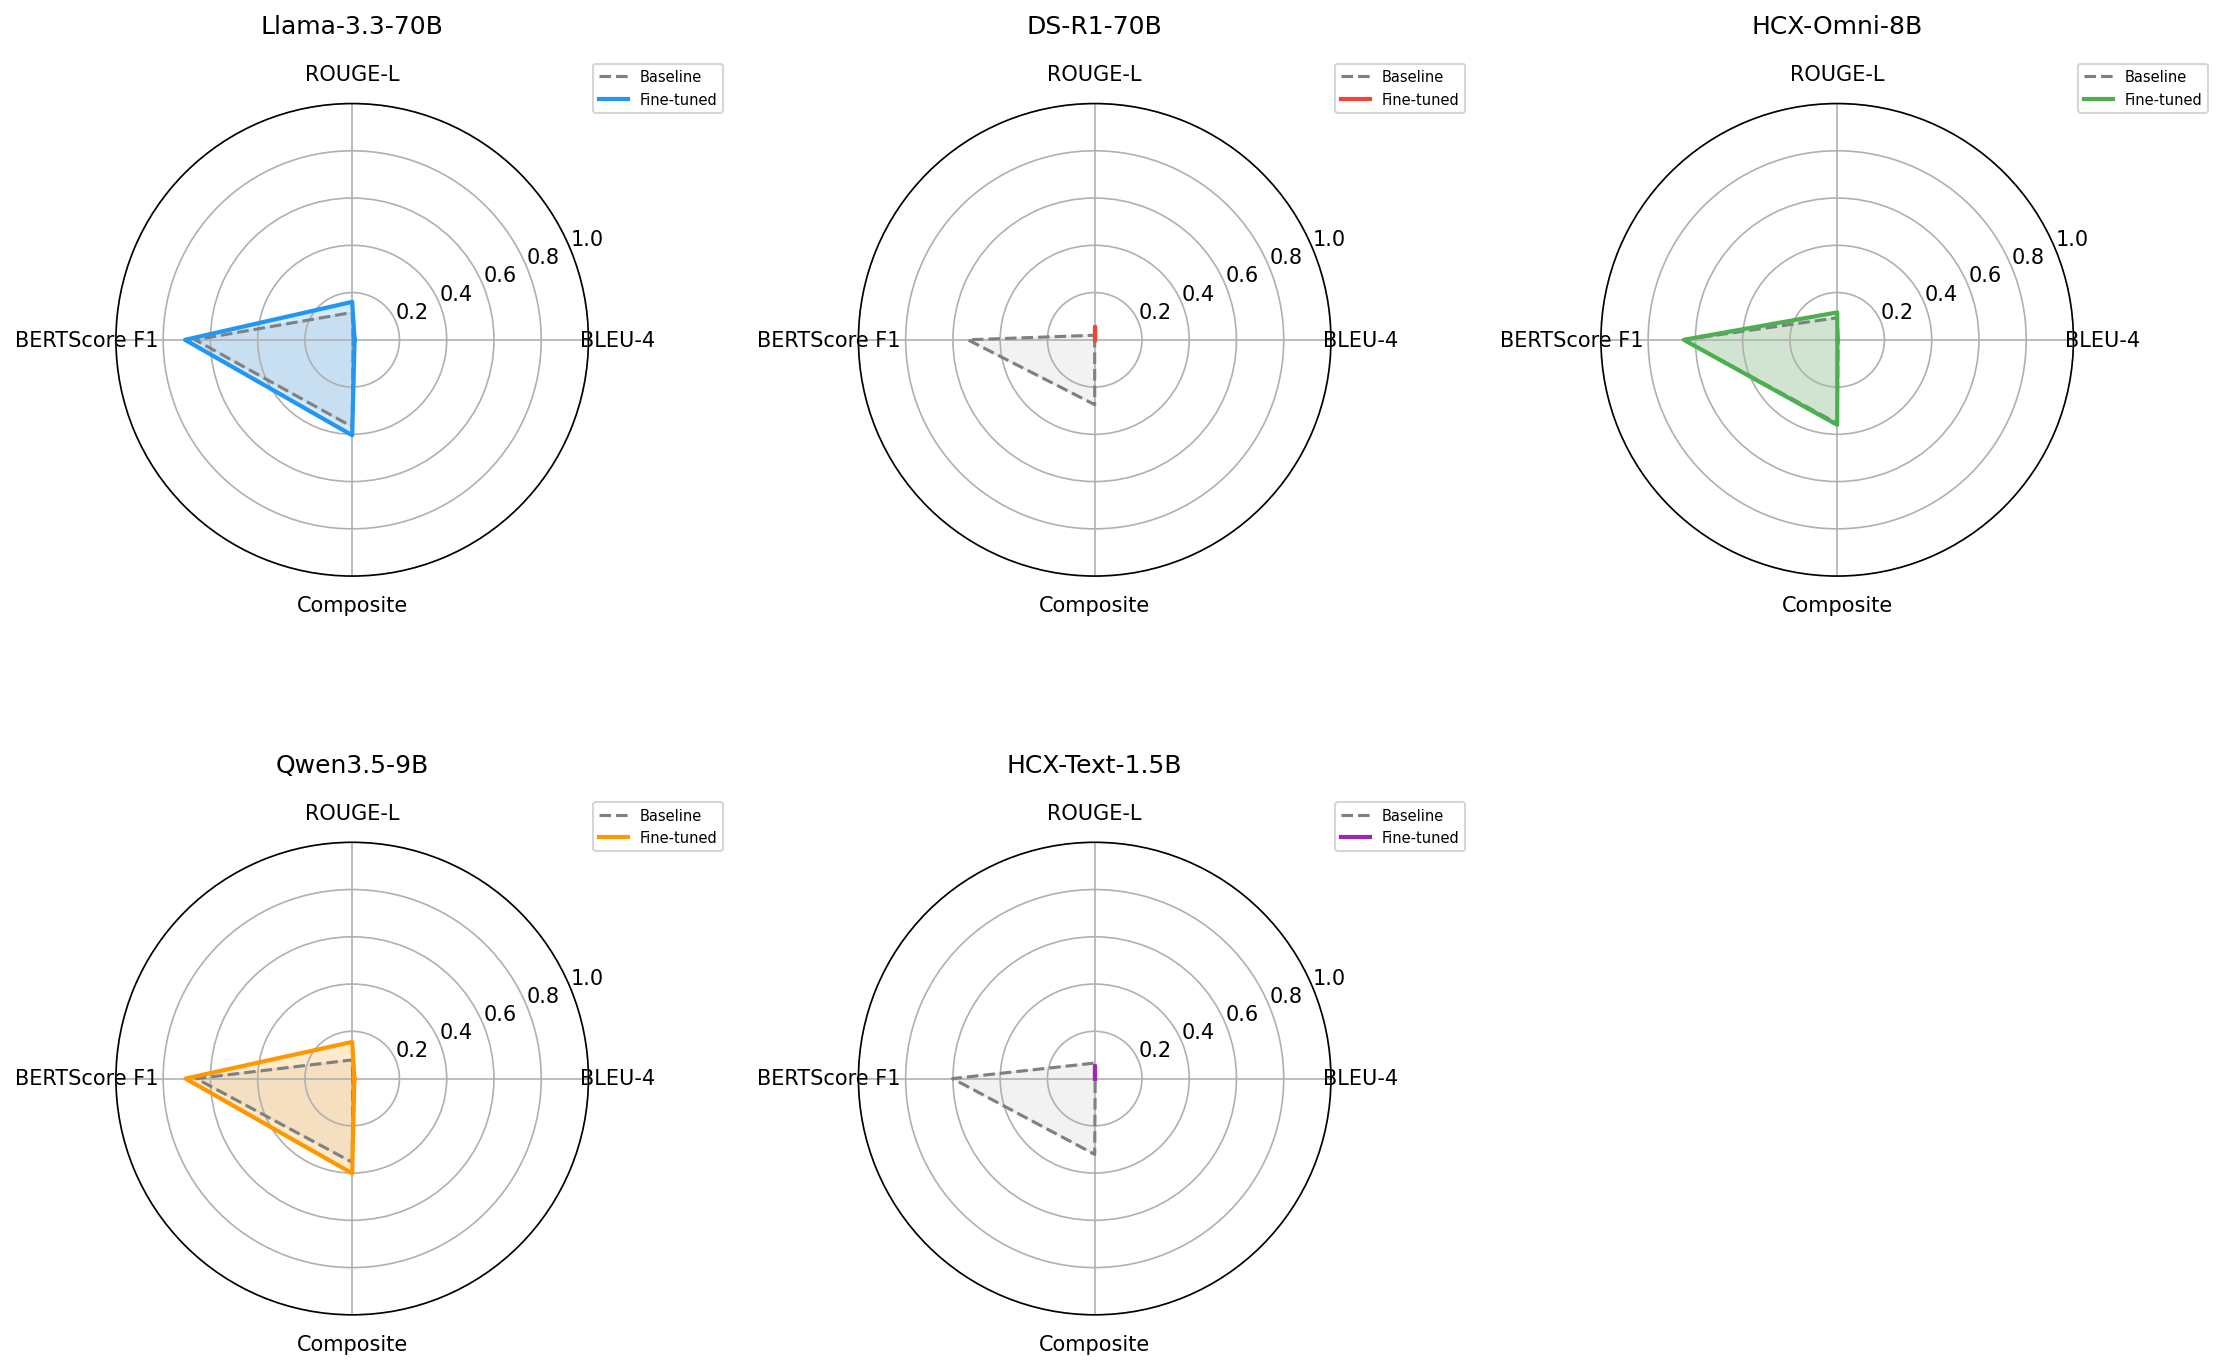
5월 3일, 그동안 8B 모델로 충분히 감을 잡은 저희 팀은 드디어 진정한 성능의 끝판왕, 70B(700억 개 매개변수) 초대형 모델의 파인튜닝에 도전했습니다. Llama 3.3 70B와 DeepSeek-R1 70B 두 가지 모델을 대상으로 학습을 시도했는데, 예상대로 엄청난 하드웨어 자원의 장벽에 부딪히고 말았습니다.
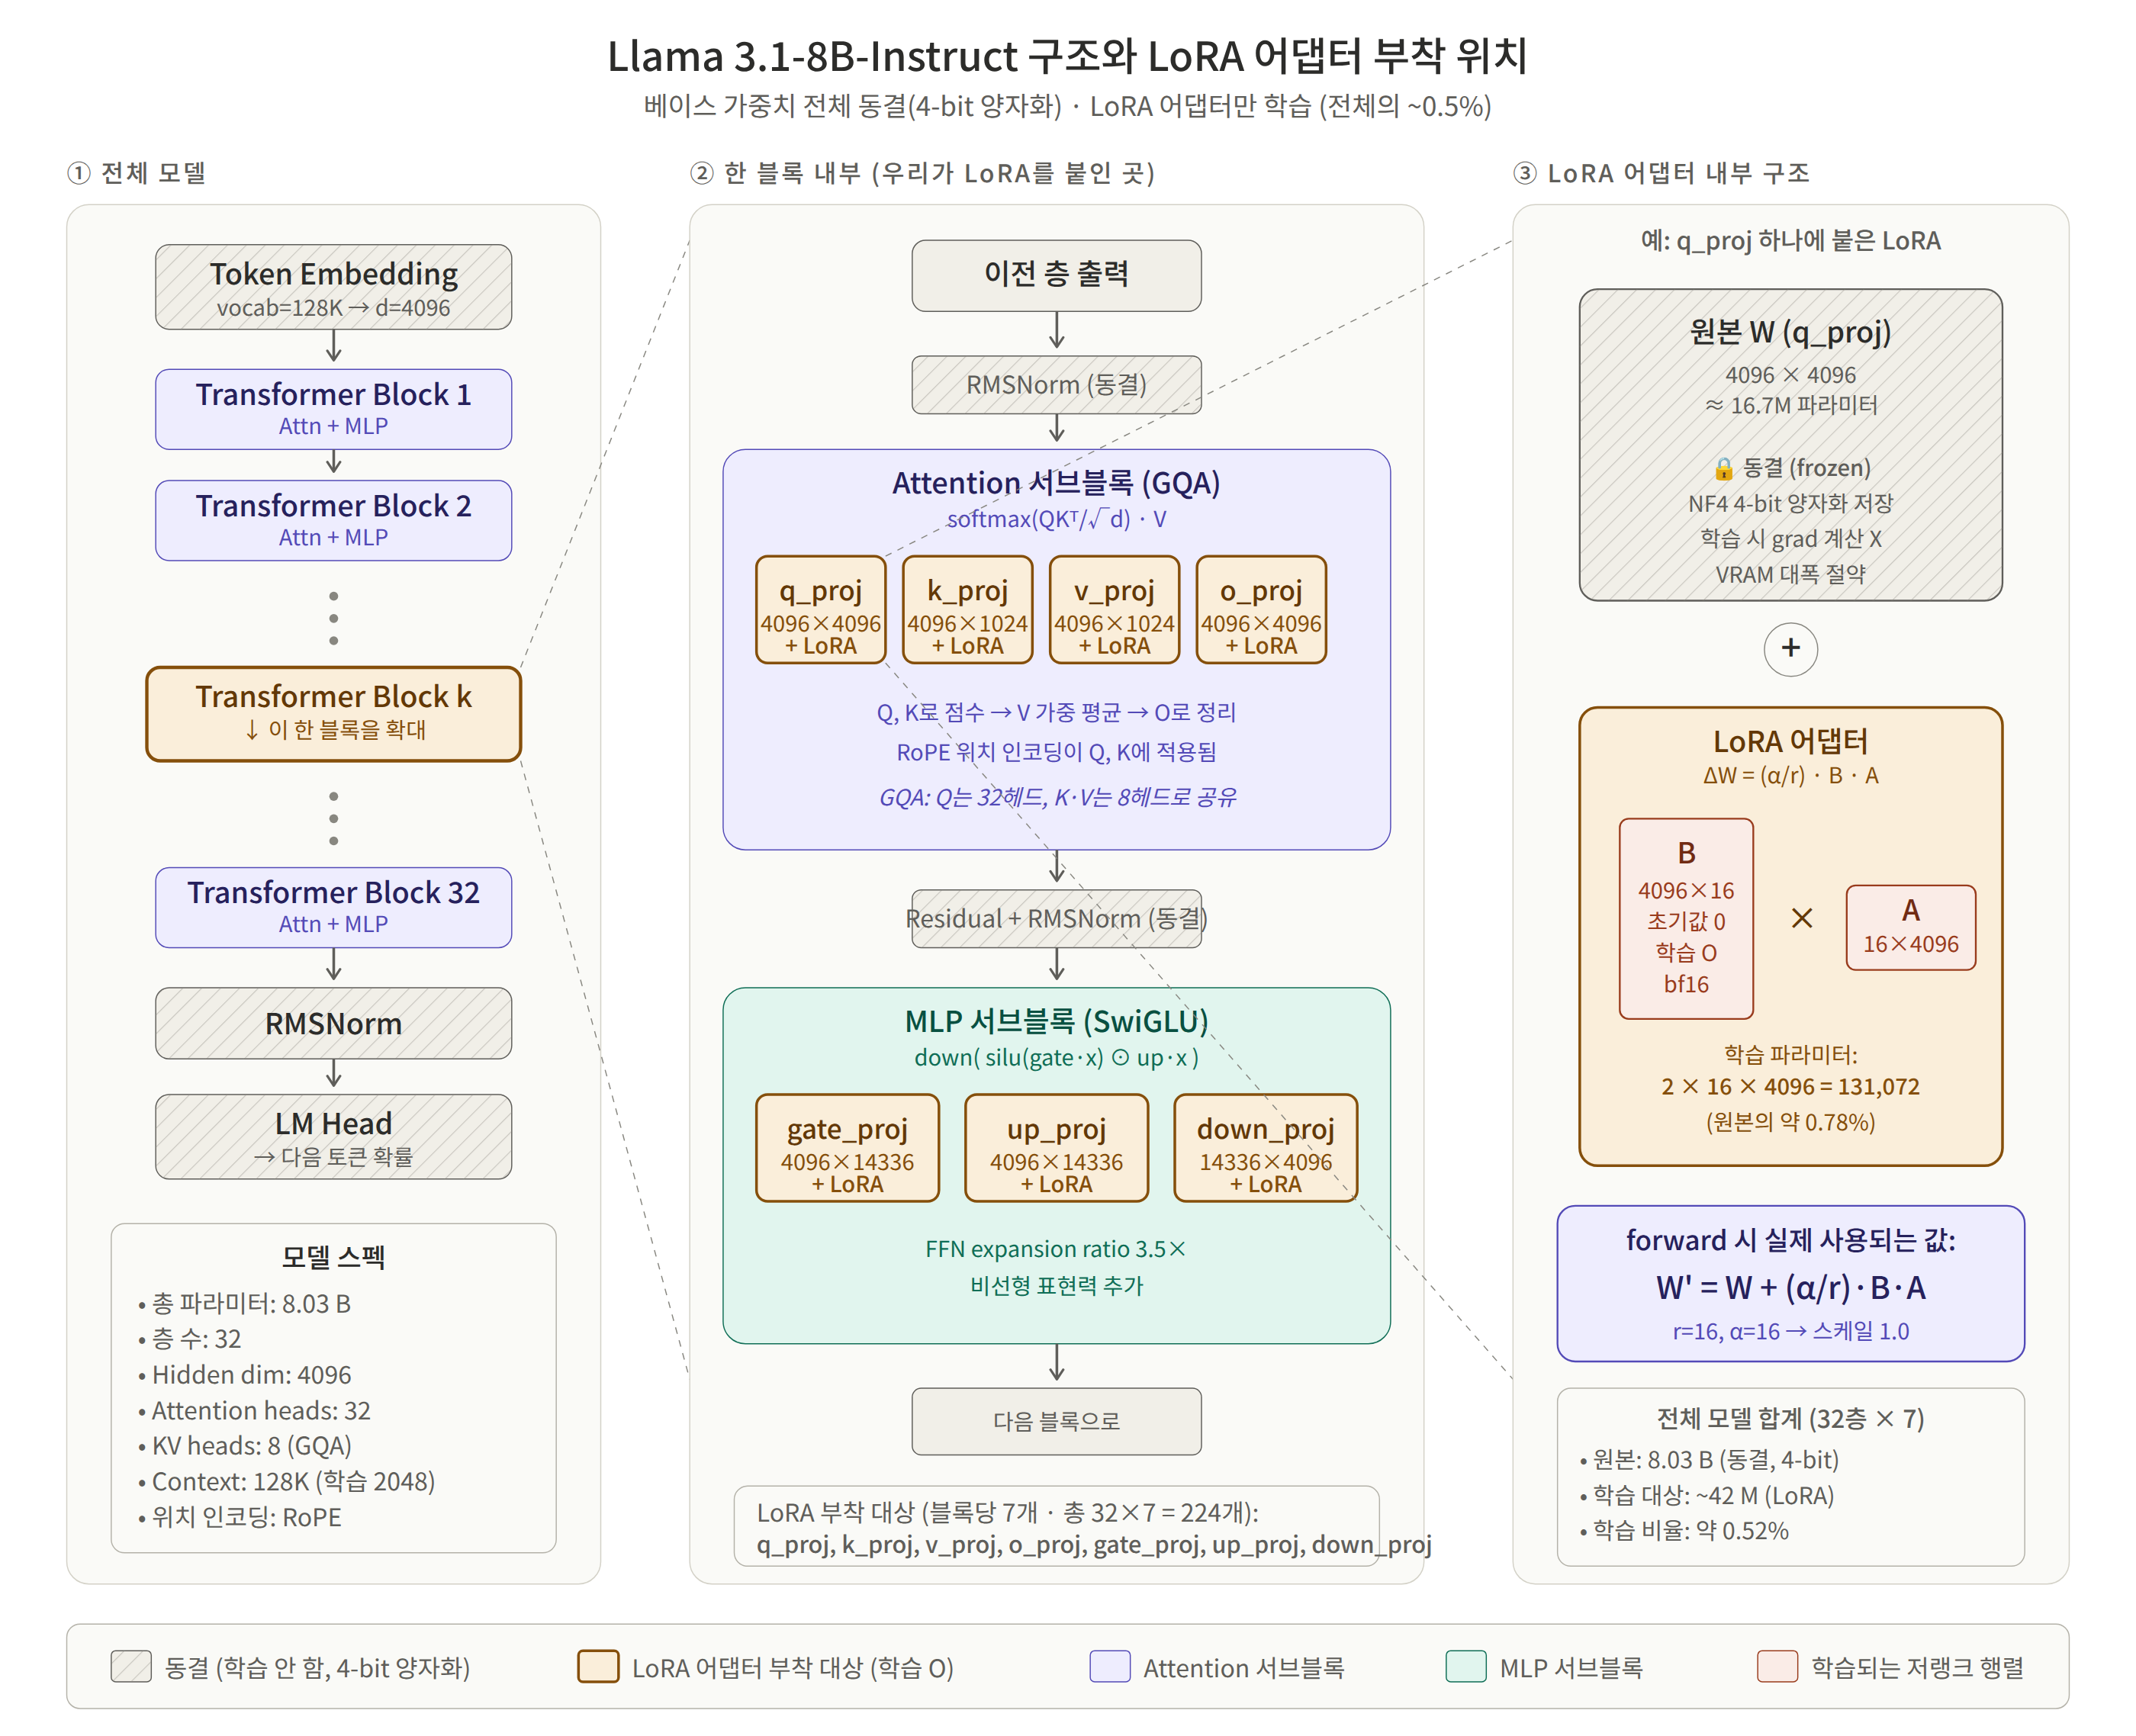
4월 19일, 피땀 흘려 만들어낸 가상의 합성 데이터셋(v5)으로 훈련시킨 모델(M6)의 성능을 평가하고, 이를 바탕으로 7주 차 주간 보고서를 작성한 날입니다. 과연 10달러의 과금 폭탄을 견뎌내며 만들어낸 데이터는 그만한 가치가 있었을까요?
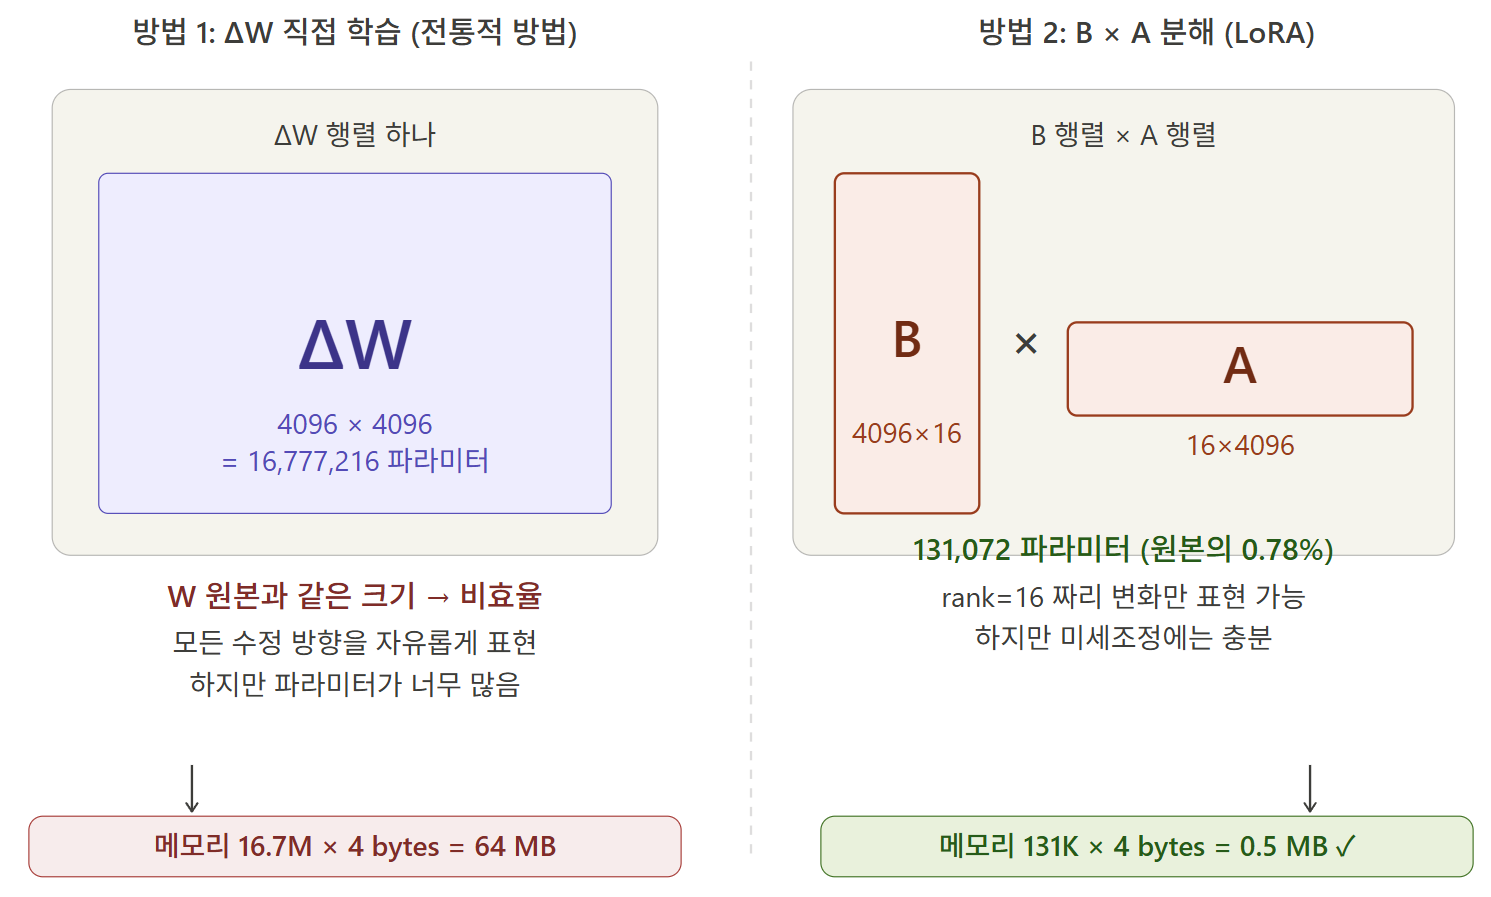
4월 14일, 요금 폭탄 사태 이후 잠시 중단되었던 합성 데이터(v5) 생성 작업을 다시 재개한 날입니다. API 요금 한도를 상향(제한 해제)하고 시스템을 돌렸지만, 이번에도 역시 순탄하게 넘어가진 않았습니다.
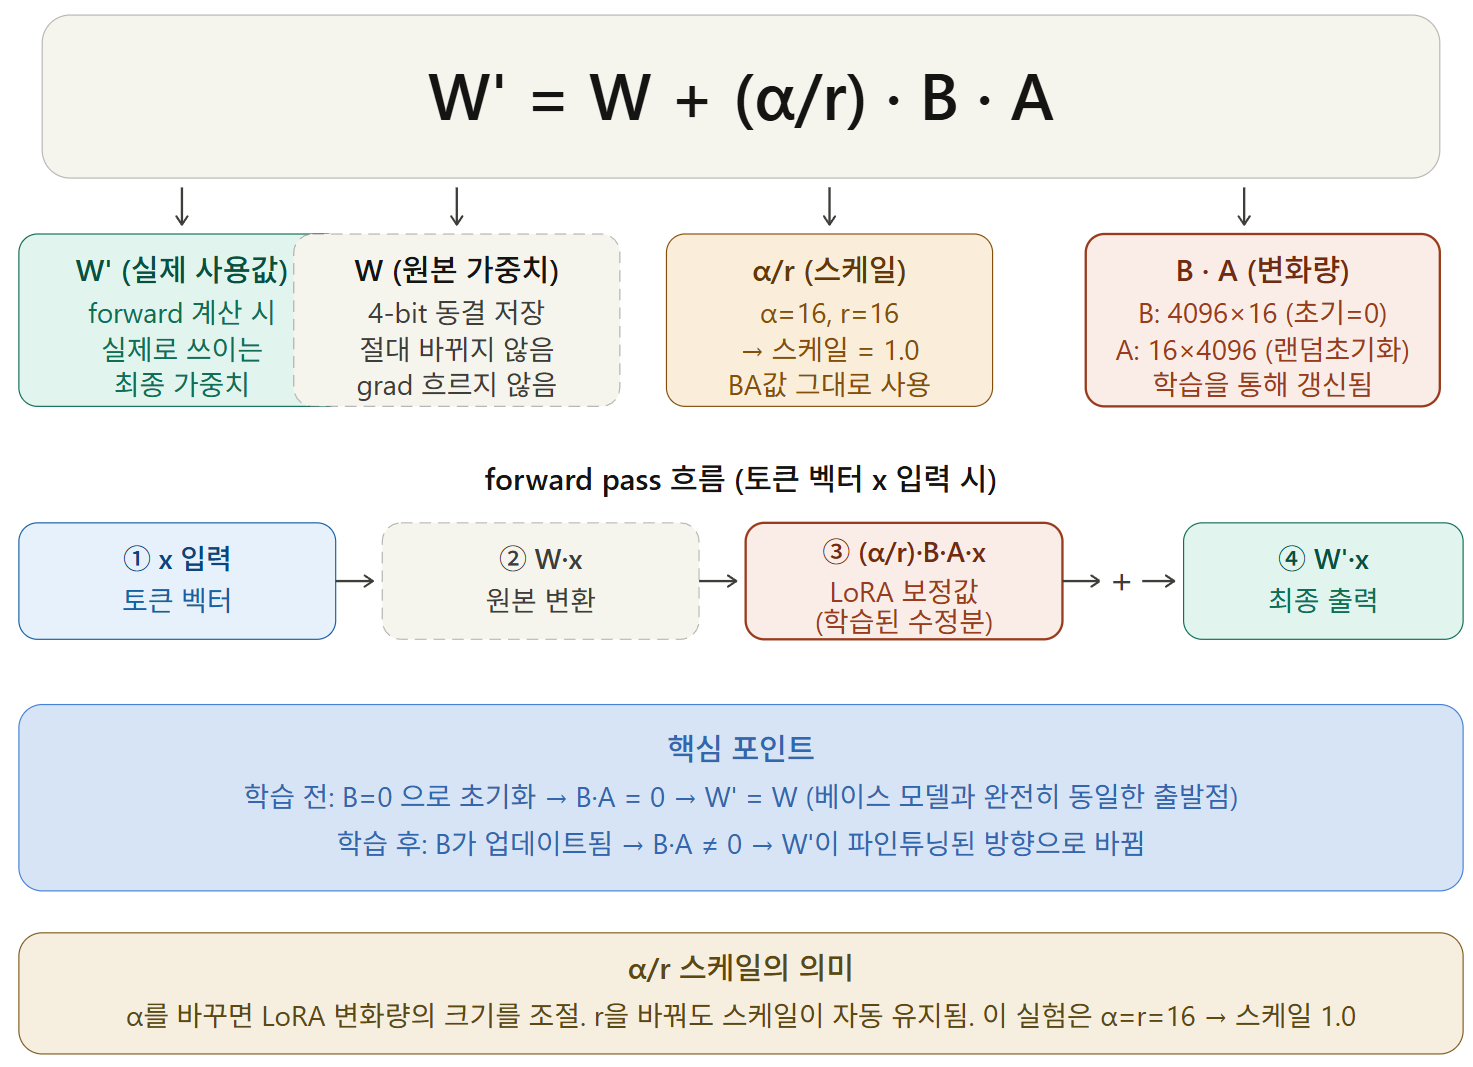
4월 9일, 어제 야심 차게 완성한 Colab 노트북을 이용해 드디어 인공지능 모델(Llama 3.1)의 첫 학습(파인튜닝)을 시도했습니다. 하지만 현실은 역시 호락호락하지 않았고 수많은 에러와 마주해야 했습니다. 동시에 캡스톤 디자인 6주차 중간발표 자료까지 만들어야 했던 험난한 하루였습니다.
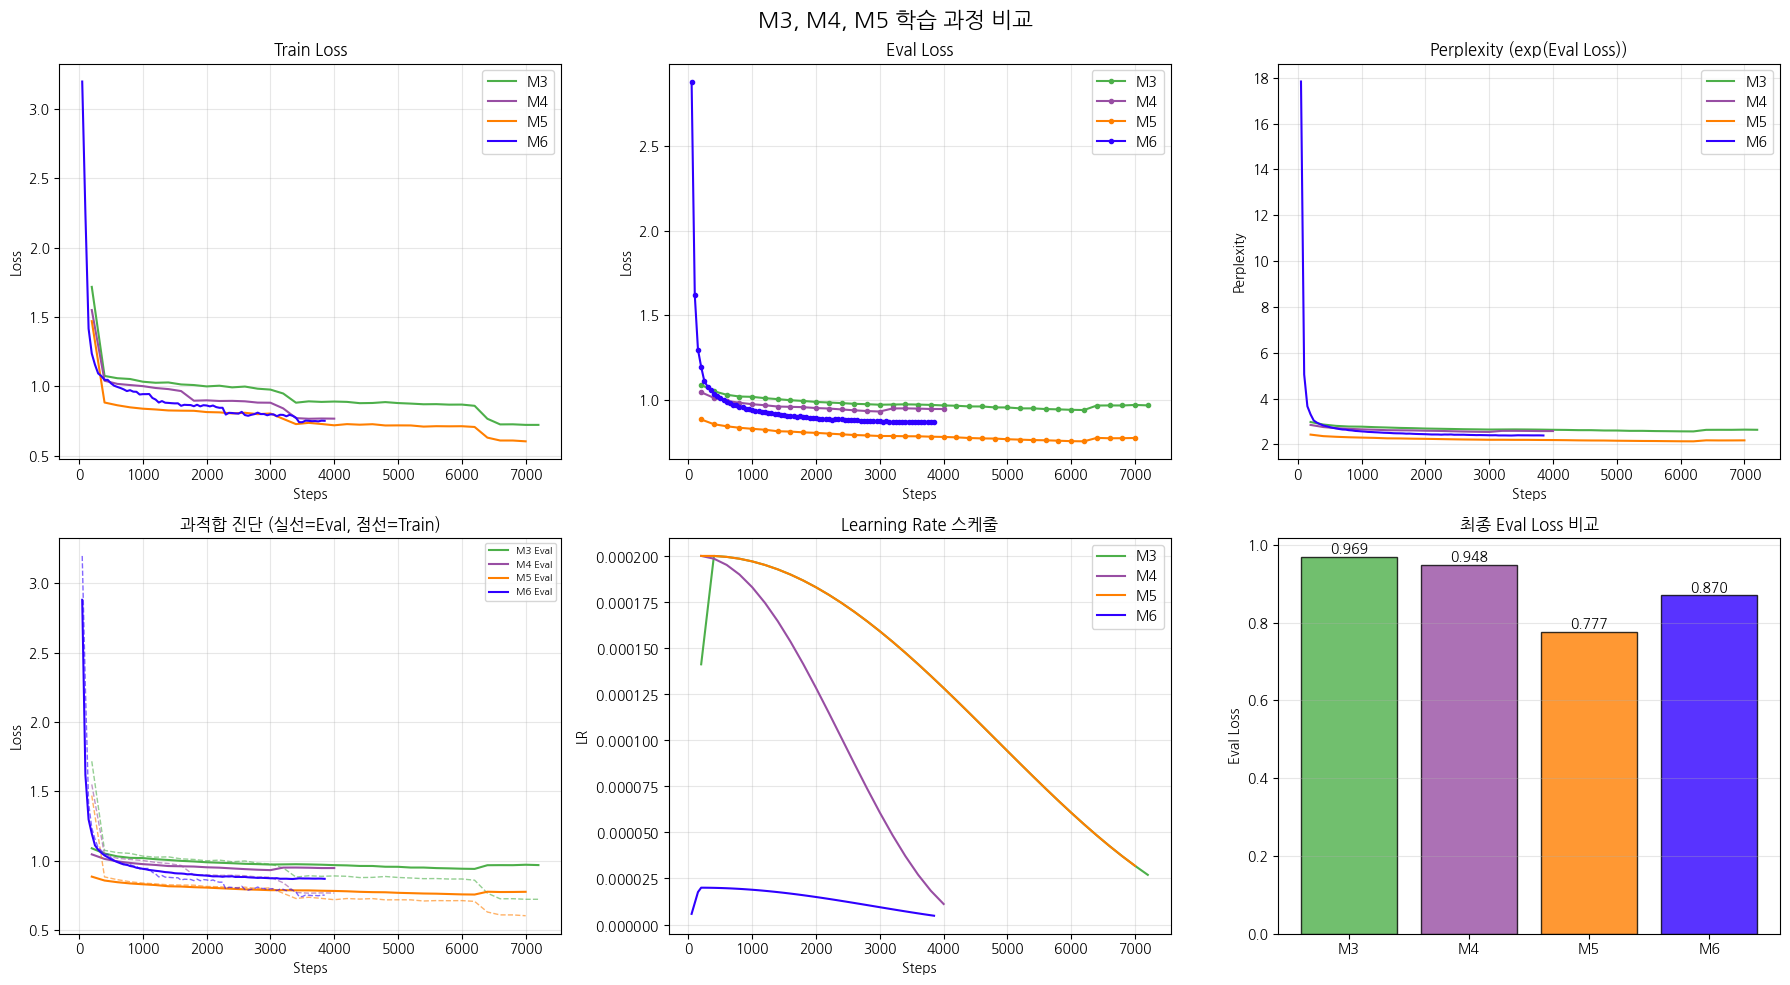
4월 8일은 마음지기 프로젝트를 진행하면서 가장 큰 위기이자 '웃픈' 해프닝이 발생한 날입니다. 바로 Claude API 월별 한도 초과 및 요금 폭탄 사태입니다.
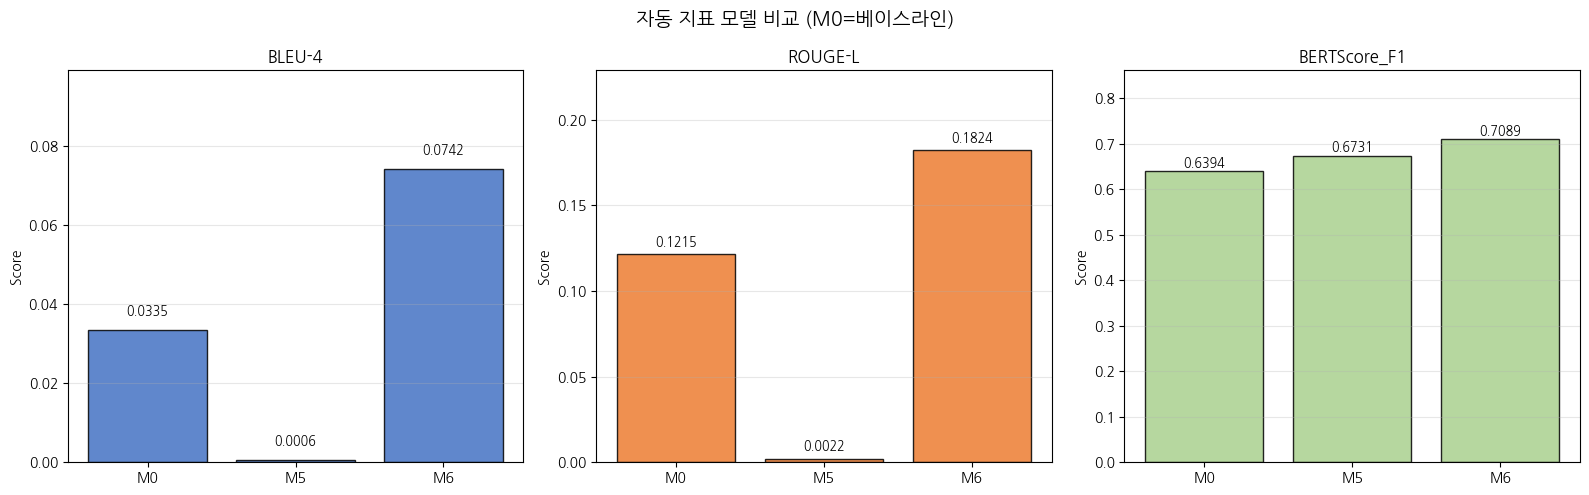
4월 7일은 팀원이 구축한 프론트엔드(mental-health) 코드를 로컬 환경에서 실행해 보며 통합을 시도한 날이자, AI를 활용해 부족한 상담 데이터를 6만 건이나 새롭게 '합성(Synthesis)'해내는 거대한 스크립트를 가동한 날입니다.
4월 5일은 그동안 진행해 온 고된 데이터 전처리 과정(v1~v4)을 갈무리하는 최종 보고서를 작성하고, 동시에 본격적으로 마음지기 웹 서비스의 얼굴이 될 프론트엔드 프로젝트를 킥오프한 날입니다.
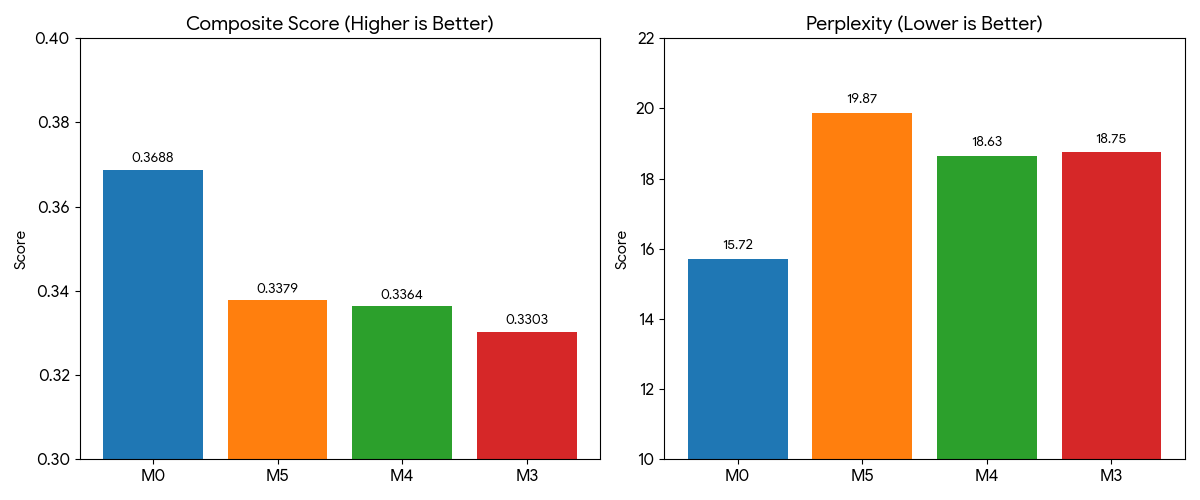
4월 3일, 본격적으로 딥러닝 모델(Llama 3.1)에 먹일 훈련용 대화 데이터를 정제하는 작업에 착수한 날의 기록입니다. 단순히 데이터를 합치는 것을 넘어, AI가 텍스트를 보고 스스로 감정을 판별하게 만드는 거대한 파이프라인을 돌려본 날이기도 합니다.
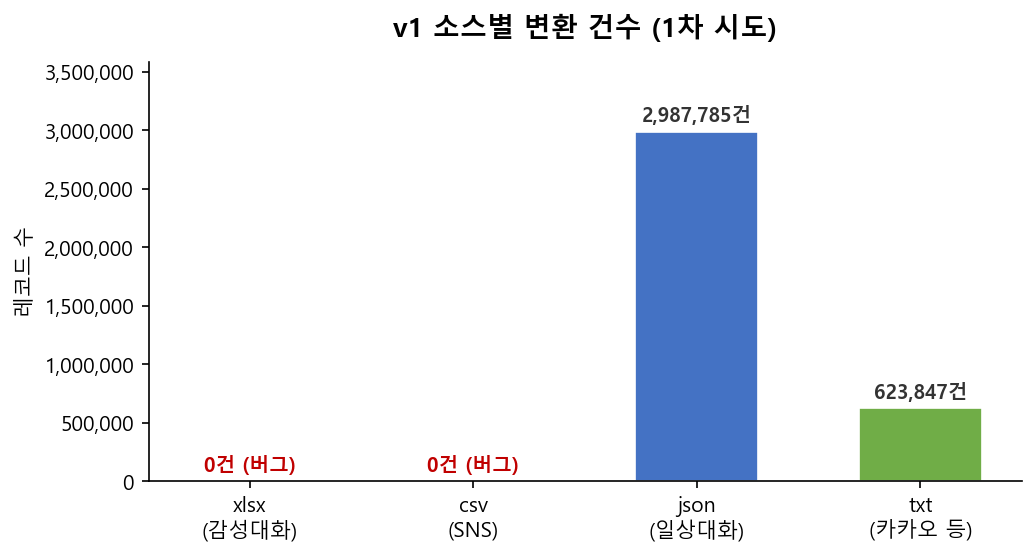
마음지기 프로젝트의 핵심 엔진이 될 Llama 3.1 모델을 훈련시키기 위해, 방대한 양의 대화 데이터를 모델이 학습할 수 있는 형식으로 가공하기 시작한 4월 1일의 기록입니다.
마음지기 프로젝트의 초기 방향이었던 국방컨벤션 예약 알람 앱의 안드로이드 빌드 테스트를 진행하는 동시에, 본격적으로 인공지능 기반 프로젝트로의 전환을 암시하는 Llama 3.1 파인튜닝 데이터 전처리를 처음 시작한 3월 31일의 기록입니다.
마음지기 프로젝트의 초기 아이디어였던 '국방컨벤션 예약 알람' 애플리케이션의 개발을 본격적으로 시작한 3월 30일의 기록입니다. 지난번 세웠던 코딩 규칙을 바탕으로 구체적인 프로젝트 진행 계획을 수립하고, 테스트 주도 개발(TDD)을 위한 기반을 다졌습니다.
마음지기 캡스톤 프로젝트의 대장정이 처음 시작된 2026년 3월 26일의 기록입니다. 당시에는 현재의 '마음지기'라는 이름 대신 단순한 안드로이드 알람 애플리케이션 기획으로 프로젝트의 첫발을 내디뎠습니다.