[Webots 로보틱스] evaluate_qlearning: 결정론적 주행 정량 평가와 DQN·SARSA 벤치마크 (#4)
· 약 4분

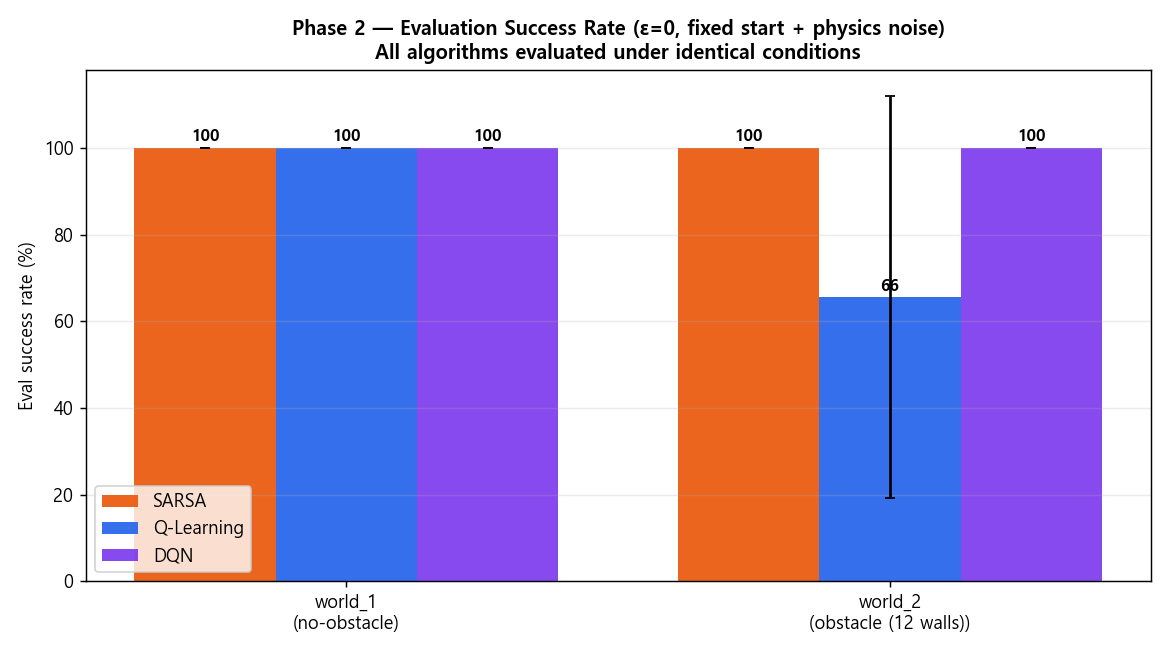
📌 핵심 요약 (TL;DR)
- 목적(Objective): 학습 중 탐색 노이즈(Epsilon)를 완전히 끈 상태(ε=0)에서 순수하게 고착된 정책(Greedy Policy)의 자율주행 신뢰성과 경로 품질을 검증.
- 평가 방법(Evaluation):
evaluate_qlearning.py를 통해 5개 평가 시드(Eval Seeds 0~4)에 걸쳐 총 30회 독립 테스트를 수행하고, 성공률, 이론 최단 경로 대비 주행 효율(Path Efficiency), 근접 위기(Near-miss) 횟수를 정밀 측정.- 결과(Result): Tabular Q-Learning은 장애물 맵에서 93.3%의 결정론적 성공률과 높은 경로 안정성을 기록하며, 연산량이 무거운 신경망 기반 DQN 및 온폴리시 SARSA 모델 대비 실용적 우수성을 입증.