[Robótica Webots] Implementação do Q-Learning Tabular & Ajuste de Reward Shaping (#2)
· 2 min para ler

📌 Resumo dos Pontos Principais (TL;DR)
- Desafio: Recompensas esparsas (+1,0 ao atingir a meta, -1,0 em colisão) resultam em estagnação do aprendizado; o robô gira em círculos sem direção.
- Solução: Modelagem de recompensa densa (Reward Shaping) utilizando delta de distância ($\Delta d$) e bônus de velocidade para a frente, combinada com decaimento exponencial de $\epsilon$ ($0.95 \rightarrow 0.05$).
1. A Regra de Atualização de Bellman (Diferença Temporal TD-0)
A cada passo de tempo $t$, o valor da ação selecionada é atualizado na tabela Q:
$Q(s_t, a_t) \leftarrow Q(s_t, a_t) + \alpha \left[ r_{t+1} + \gamma \max_{a} Q(s_{t+1}, a) - Q(s_t, a_t) \right]$
- Taxa de Aprendizado ($\alpha = 0.15$): Modula a velocidade de absorção de novas experiências.
- Fator de Desconto ($\gamma = 0.95$): Pondera a importância de recompensas futuras em relação a ganhos imediatos.
2. Função de Recompensa Densa (Reward Shaping)
$R(s, a, s') = R_{\text{terminal}} + c_1 \cdot (d_t - d_{t+1}) + c_2 \cdot v_{\text{frente}} - c_3 \cdot \mathbb{I}_{\text{giro}}$
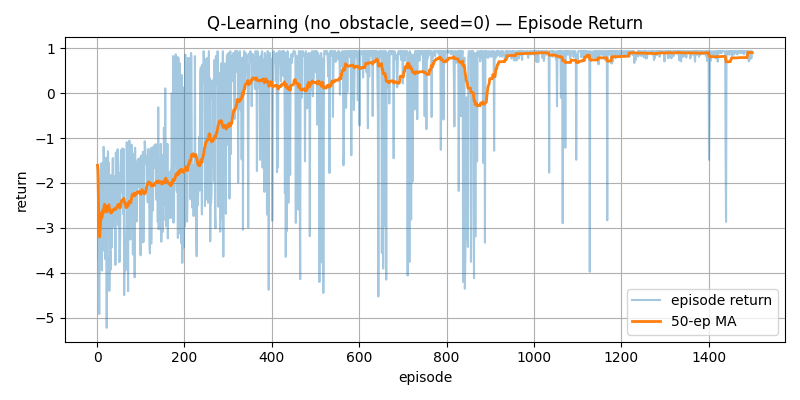
Ao recompensar a aproximação contínua em relação ao alvo (d_t - d_{t+1} > 0), o robô descobre trajetórias ótimas em menos de 50 episódios.
📌 Resumo Executivo para Gestão (3–5 Linhas)
- Feedback Denso vs. Esparso: Recompensas contínuas de aproximação aceleram a convergência em mais de 10 vezes.
- Equilíbrio Exploração/Explotação: O decaimento exponencial do epsilon assegura exploração inicial ampla e estabilidade final.
- Convergência Firme: Os valores da Q-Table estabilizam-se após 200 episódios sem oscilações destrutivas.
- Prevenção de Giros Viciosos: A penalidade por giros no próprio eixo força o agente a buscar avanço espacial contínuo.