Stanford CS329A (Ep 11): Agent Memory — MemGPT, Cartridges, CacheBlend e Arquitetura de Contexto Hierárquico

Quando engenheiros e desenvolvedores utilizam agentes autônomos de IA como parceiros de desenvolvimento ou colaboradores de longo prazo em produção, enfrentam invariavelmente três grandes gargalos de arquitetura:
- "O agente esquece completamente decisões fundamentais de arquitetura acordadas na sessão de ontem."
- "Inserir uma base corporativa de 100.000 linhas de código em uma janela de contexto de 1 milhão de tokens causa forte degradação de atenção (o fenômeno Lost-in-the-Middle) e custos exorbitantes de API a cada turno."
- "Ao mesclar múltiplos fragmentos de documentos (chunks) em fluxos de RAG, os caches de prefixo chave-valor (KV) são invalidados, elevando o tempo para o primeiro token (TTFT) para vários segundos."
O cérebro humano supera essa restrição com maestria: temos uma memória de trabalho física extremamente restrita (apenas 4 a 7 fragmentos discretos), mas recuperamos lembranças de décadas passadas instantaneamente e integramos novos conhecimentos sem sobrecarga cognitiva.
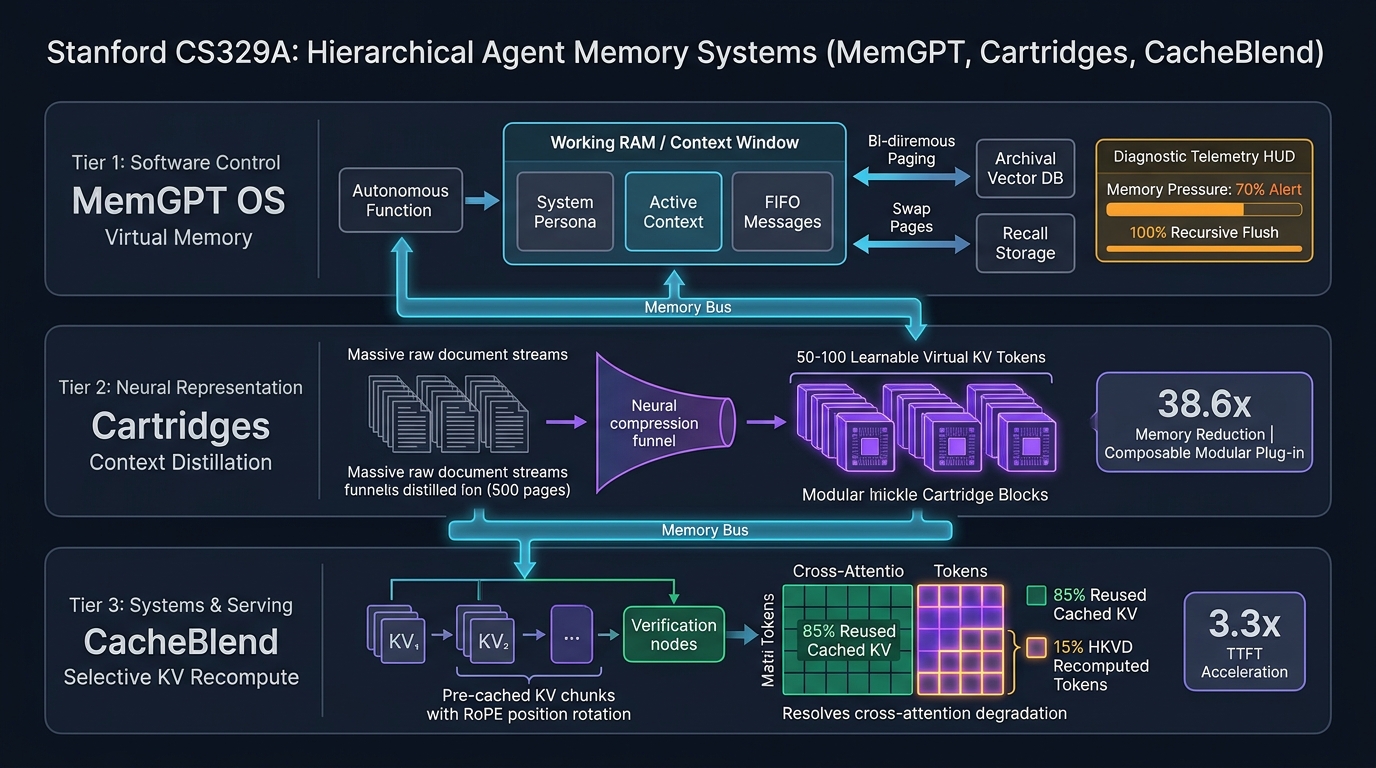
Dando continuidade à Parte 3: Engenharia de Agentes de Stanford CS329A: Self-Improving AI Agents, este artigo examina a Agent Memory Architecture — a forma como a inteligência artificial confere aos sistemas autônomos uma memória persistente e hierárquica em três camadas fundamentais:
- Camada de Controle de Software (MemGPT, UC Berkeley 2023): Paginação de memória virtual hierárquica inspirada em sistemas operacionais.
- Camada de Representação Neural (Cartridges, 2025): Destilação de contexto via autoaprendizado (Self-Study) que condensa documentos volumosos em vetores KV contínuos e modulares.
- Camada de Infraestrutura de Sistemas (CacheBlend, EuroSys 2025): Recálculo seletivo de cache KV restaurando a atenção cruzada e reduzindo a latência RAG em 3,3x.
1. O Dilema do Contexto Extenso e a Memória Hierárquica
Simplesmente expandir a janela física de contexto de um LLM (por exemplo, de 8k para mais de 1M de tokens) não resolve o problema da memória do agente. A expansão pura por força bruta acarreta três falhas estruturais:
- Dispersão de Atenção e Perda Central (Lost-in-the-Middle): A autoatenção dos transformadores se dispersa em contextos imensos, ignorando fatos cruciais posicionados no centro dos prompts.
- Inviabilidade Financeira: Reenviar centenas de milhares de tokens repetidamente consome orçamentos computacionais de maneira insustentável.
- Volatilidade de Sessão: Ao término de uma interação, os estados de ativação transitórios somem; o agente não evolui seu estado interno sem intervenções externas.
Para alcançar autonomia duradoura, as arquiteturas modernas separam o Contexto de Trabalho (Working Context) do Armazenamento de Longo Prazo (Long-Term Storage) por meio de uma gestão estruturada de Hierarchical Context Management.
┌─────────────────────────────────────────────────────────────────────────┐
│               A Pilha de Abstração de Memória em 3 Camadas              │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│Camada Controle de Software│ │Camada Representação Neural│ │  Camada de Infraestrutura │
│         (MemGPT)         │  │       (Cartridges)       │  │       (CacheBlend)       │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • Paginação virtual de SO│  │ • Destilação Self-Study  │  │ • Fusão de chunks RAG    │
│ • Contexto principal(RAM)│  │ • Embeddings KV contínuos│  │ • Recálculo seletivo 15% │
│ • Banco vetorial (Disco) │  │ • Redução de memória 38x │  │ • Matriz rotacional RoPE │
│ • Despejo e resumo rec.  │  │ • Ganho de vazão de 26,4x│  │ • Queda de 3,3x no TTFT  │
│ • Recordação profunda 92%│  │ • Modularidade tipo Lego │  │ • Desvio de acurácia <0,01│
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. Camada de Controle de Software: MemGPT (UC Berkeley 2023)
Sistemas operacionais dominam a escassez de memória há décadas. Um SO moderno fornece aos desenvolvedores a ilusão de RAM infinita ao alternar páginas de memória virtual entre a memória física DRAM e discos de armazenamento através da Unidade de Gerenciamento de Memória (MMU).
Criado por Packer et al. na UC Berkeley, o MemGPT Long-Term Memory adapta essa sabedoria clássica diretamente para agentes de linguagem:
"A janela de prompt do LLM é a memória física RAM. Os bancos de dados vetoriais e registros SQL externos são o disco rígido. Ao conceder ao modelo primitivas de chamada de funções (Function Calling) para inspecionar, editar, despejar e recuperar lembranças, o próprio agente se torna seu sistema operacional."
    ┌────────────────── [Contexto Principal (RAM: limite de 8k~128k tokens)] ────────┐
    │ 1. System Instructions : Regras centrais e manual de operações de memória (R)  │
    │ 2. Working Context     : Fatos estáveis, perfil de usuário e persona (R/W)     │
    │ 3. FIFO Message Queue  : Diálogo recente + Cabeçalho de Resumo Recurrente       │
    └────────────────────────────────────────────────────────────────────────────────┘
                               ▲                      │
                (Swap-In / Search)                    │ (Swap-Out / Despejo e Flush)
                               │                      ▼
    ┌───────────────── [Contexto Externo (Disco: Armazenamento Infinito)] ───────────┐
    │ 1. Recall Storage   : Histórico cronológico completo de mensagens (PostgreSQL) │
    │ 2. Archival Storage : Repositório vetorial de documentos e bases de dados(HNSW)│
    └────────────────────────────────────────────────────────────────────────────────┘
Mecânica de Paginação Autônoma
Em vez de scripts externos cortarem arbitrariamente as conversas, o próprio modelo conduz o gerenciamento:
- Aviso de Pressão de Memória (Limiar de 70%): Quando a conversa atinge 70% da capacidade do contexto ativo, uma interrupção de sistema é enviada:
"Aviso: Contexto a 70% da capacidade. Salve fatos essenciais no
working_contextantes que ocorra o despejo." - Resumo Recurrente e Despejo (Limpeza aos 100%):
- Ao atingir 100%, o gerenciador de fila FIFO extrai os 50% de mensagens mais antigas.
- O material não é descartado: o MemGPT ativa uma rotina de Resumo Recurrente (Recursive Summarization), mesclando o resumo prévio com as novas mensagens extraídas para gerar um bloco sintético no topo da fila.
- As mensagens originais são gravadas de forma permanente no
Recall Storage.
- Recordação Autônoma por Heartbeat:
- Se o usuário perguntar sobre um fato de meses atrás, o agente executa
recall_storage.search()com o parâmetrorequest_heartbeat=true. Isso permite encadear buscas de forma autônoma para transferir dados do disco para a RAM antes de fornecer a resposta conclusiva.
- Se o usuário perguntar sobre um fato de meses atrás, o agente executa
Resultados de Desempenho: Recordação Profunda (DMR)
No benchmark Deep Memory Recall (DMR) com dezenas de sessões estendidas:
- O GPT-4 padrão com janela estática despencou para 32,1% de acurácia.
- O MemGPT sustentou 92,5% de acurácia, sem qualquer perda de desempenho com o avanço das sessões.
- Em testes de busca chave-valor aninhada (Nested KV Retrieval), os modelos tradicionais caíram para 0% além de 3 etapas, enquanto o MemGPT manteve 100% de precisão.
3. Camada de Representação Neural: Cartridges (2025)
O MemGPT opera com eficiência no nível de tokens de texto. Contudo, manipular relatórios financeiros de 500 páginas ou bibliotecas inteiras de software transportando texto bruto gera alto consumo de VRAM e latência no prefill.
Apresentada em 2025, a pesquisa Cartridges Modular Agent Memory propõe uma abordagem transformadora:
"Por que manter o conhecimento como texto bruto e volumoso? E se um LLM estudasse um documento de 500 páginas previamente (Self-Study) e o condensasse em apenas 50 a 100 vetores de cache KV contínuos e treináveis, prontos para serem plugados como um cartucho físico?"
[Documento Extenso de 500 Páginas / Base de Código]
             │
             ▼ (Pipeline de Self-Study)
1. Síntese de Diálogos Diversos (Resumos, Questionamentos, Casos de Borda)
             │
             ▼
2. Destilação de Contexto via Divergência KL:
   Modelo Professor (Documento completo de 500 pág. + Pergunta) ──► P_Professor(y)
                                                                     │ (Perda D_KL)
   Modelo Aluno (Cartucho Z [50 vetores KV] + Pergunta) ────────► P_Aluno(y)
             │
             ▼
[Cartucho Z Plug-and-Play (50~100 Vetores KV Contínuos)]
(Compressão de Memória 38,6x, Aceleração de Vazão 26,4x, Composição Modular)
Por que a Predição de Próximo Token (NTP) Tradicional Falhou
Quando os pesquisadores treinaram os vetores KV usando a clássica predição do próximo token (NTP), o modelo caiu na "Síndrome da Memorização Mecânica":
- Ele conseguia recitar parágrafos inteiros literalmente.
- Mas ao ser questionado sobre raciocínios analíticos ou sínteses conceituais, sua acurácia caía a zero. O modelo decorava a superfície das palavras sem compreender o conteúdo.
A Estratégia de Self-Study e Destilação
- Geração de Diálogos Sintéticos: O modelo gera milhares de pares de perguntas e respostas sobre o texto em cinco dimensões: visões gerais, dilemas conceituais, testes de limites e cenários práticos.
- Destilação de Contexto:
- Modelo Professor: Recebe as 500 páginas no contexto e calcula a distribuição alvo
P_Teacher(y | Doc, x). - Modelo Aluno: Recebe apenas os parâmetros do cartucho $Z$ (50-100 tokens KV virtuais) junto à pergunta $x$.
- Os parâmetros $Z$ são refinados por gradiente descendente minimizando a Divergência de Kullback-Leibler (KL):
- Modelo Professor: Recebe as 500 páginas no contexto e calcula a distribuição alvo
========================================================================================
Formulação da Perda de Destilação para Cartridges:
========================================================================================
min_Z  Σ  D_KL( F( · | Documento ⊕ x )  ||  F_Z( · | x ) )

Onde:
  • F( · | Documento ⊕ x ) : Logits do modelo Professor com texto completo
  • F_Z( · | x )          : Logits do modelo Aluno guiado apenas pelo Cartucho Z
  • Z                     : Tensores de cache KV contínuos inseridos nas camadas
========================================================================================
Resultados Empíricos e Modularidade Tipo Lego
- Economia de Memória de 38,6x: Em avaliações com textos longos (LongHealth, QASPER), o Cartridges igualou a acurácia do modelo completo consumindo 38,6 vezes menos VRAM.
- Vazão de Inferência 26,4x Superior: Ao retirar milhares de tokens da etapa de preenchimento prévio (prefill), a taxa de geração subiu 26,4 vezes.
- Composição Modular Instantânea: Os cartuchos funcionam como módulos independentes. Ao plugar o Cartucho do relatório 10-K da AMD junto com o Cartucho da PepsiCo, o agente executou análises financeiras comparativas sem a necessidade de reentrenamento conjunto.
4. Camada de Infraestrutura de Sistemas: CacheBlend (EuroSys 2025)
No nível de hardware e infraestrutura de servidores, nos deparamos com barreiras severas em pipelines RAG e agentes multi-documentos.
Quando um agente recupera 10 fragmentos de textos independentes para formar uma resposta, os motores de inferência tradicionais sofrem um impasse intransponível:
- Prefix Caching (vLLM): Somente o primeiro fragmento aproveita o cache de prefixo. Se a ordem dos fragmentos mudar, todos os caches seguintes são descartados, forçando o recálculo do zero (prefill de 3 a 6 segundos).
- Concatenação Simples de Cache (PromptCache): Pré-computar cada fragmento e colá-los diretamente ignora a Atenção Cruzada (Cross-Attention) entre fragmentos, fazendo a precisão despencar mais de 50%.
Publicado na EuroSys 2025, o CacheBlend KV Cache Merging supera essa limitação por meio do Recálculo Seletivo de KV (Selective KV Recompute):
[Caches KV Pré-computados dos Fragmentos A, B e C]
                           │
                           ▼
┌─────────────────────────────────────────────────────────────────────────┐
│              Pipeline de Recálculo Seletivo Camada por Camada           │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. Identificar os 15% de Tokens com Maior Desvio de Atenção (HKVD)      │
│ 2. Recalcular a Atenção APENAS para esses 15% Críticos                  │
│ 3. Mesclar os 85% Restantes Diretamente do Cache Pré-computado          │
│ 4. Aplicar Matriz de Rotação RoPE para Ajustar Coordenadas Absolutas    │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [Prefill Ultraveloz: TTFT Reduzido em 3,3x, Desvio F1 < 0,01]
A Descoberta da Esparsidade de Atenção
Os autores identificaram um padrão matemático fundamental nos mapas de atenção:
"Ao juntar múltiplos fragmentos de texto em uma mesma consulta, menos de 15% dos tokens sofrem variações substanciais em seus pesos de atenção devido aos blocos vizinhos. Mais de 85% dos tokens mantêm representações praticamente invariantes!"
- Detecção de Tokens com Alto Desvio (HKVD): Em cada camada da rede, o CacheBlend seleciona os 15% de tokens com maiores alterações cruzadas e recalcula apenas seus valores.
- Ocultação de Latência via Sobreposição com I/O: Enquanto a GPU recalcula os 15% dos tokens (~2 ms), uma thread assíncrona transfere os dados da camada seguinte das unidades SSD NVMe para a memória de vídeo. O tempo de cálculo é completamente absorvido pelo tempo de transferência de dados.
- Ajuste de Posições com RoPE: A junção de fragmentos altera suas posições relativas. O CacheBlend multiplica as chaves salvas por uma matriz de rotação 2D de Givens, restaurando a validade geométrica das posições em microssegundos.
Métricas de Eficiência
- Latência TTFT 3,3x Menor: O tempo até a emissão da primeira palavra caiu de 3.450 ms para 1.050 ms em consultas RAG complexas.
- Capacidade de Servidores 5x Maior: Os clusters de hardware atenderam a um volume 5 vezes maior de requisições simultâneas de agentes.
- Preservação Integral de Qualidade: Em relação ao recálculo integral sem cache, o desvio no score F1 foi inferior a 0,01.
5. Matriz Comparativa entre Paradigmas de Memória
=============================================================================================================
Dimensão              MemGPT (UC Berkeley)          Cartridges (2025)             CacheBlend (EuroSys 2025)
-------------------------------------------------------------------------------------------------------------
Nível de Abstração    Controle de Software / SO     Representação Neural          Infraestrutura de Servidores
Unidade Principal     Tokens de Texto e Funções     Vetores KV Contínuos          Tensores KV Pré-computados
Limite de Capacidade  Ilimitado (Bancos Externos)   50-100 Tokens por Documento   RAG Multi-Fragmentos Dinâmico
Mecanismo de Ajuste   Chamadas de Ferramentas       Destilação Self-Study (KL)    Recálculo Seletivo (15% HKVD)
Principal Ganho Real  Fim do Estouro de Janela      VRAM 38,6x Menor              TTFT 3,3x Mais Rápido
Capacidade de Junção  Consultas Relacionais         Empilhamento Modular Direto   Transformação Angular RoPE
=============================================================================================================
6. Perguntas e Respostas Técnicas (Q&A)
P1: Como o MemGPT decide de forma autônoma QUANDO buscar dados na memória externa sem auxílio humano?
O MemGPT atua com base em diretrizes rigorosas contidas nas Instruções do Sistema (System Instructions) posicionadas no topo da janela:
"Você é uma inteligência com memória persistente. Caso enfrente perguntas sobre fatos passados ou histórico de conversas ausentes no contexto atual, NÃO tente inventar ou pedir desculpas. Você DEVE acionar
recall_storage.search()ouarchival_storage.search()."
Ao constatar a falta de informações vitais, o mecanismo de atenção atribui maior probabilidade à emissão do JSON de chamada da ferramenta em vez de um pedido de desculpas. O parâmetro request_heartbeat=true faz o sistema retornar os dados de busca imediatamente para o contexto, fechando o ciclo de recuperação de forma independente.
P2: Por que concatenar blocos de KV pré-computados não desalinha a codificação posicional RoPE?
Nos esquemas antigos de posicionamento absoluto, deslocar um token do início para outra posição obrigava a recalcular todos os vetores.
Em contraste, o RoPE (Rotary Position Embedding) mapeia as coordenadas através de rotações no plano 2D, onde o produto escalar depende estritamente da distância relativa $(m - n)$:
K_novo = R_Theta(p_novo - p_antigo) * K_cache
Assim, o CacheBlend move uma chave armazenada de sua posição original para a nova posição simplesmente multiplicando-a pela matriz de rotação equivalente ao deslocamento $(p_novo - p_antigo)$. Esse ajuste consome menos de 10 microssegundos e mantém o rigor matemático perfeito sem alterar os pesos do modelo.
Conclusão & Próxima Aula
A verdadeira autonomia dos agentes depende fundamentalmente da permanência de sua memória. Com o MemGPT, aprendemos como a paginação de sistemas operacionais viabiliza um ciclo cognitivo infinito. Com o Cartridges, vimos como sintetizar conhecimentos enciclopédicos em vetores contínuos modulares. Com o CacheBlend, provamos que o recálculo seletivo reduz o tempo de resposta em 3,3x.
Na Aula 12, encerraremos a Parte 3 (Engenharia de Agentes) estudando as métricas essenciais para quantificar o impacto real da inteligência autônoma: Agent Evaluation & Long Tasks — Avaliação de Tarefas Longas, GDPVal e DeepScholar-Bench.
Principais Lições
- Separação Hierárquica: É indispensável segregar a memória rápida de trabalho (RAM) do armazenamento massivo permanente (Disco).
- Vetores Contínuos em Vez de Texto Bruto: Destilar documentos em Cartridges reduz o uso de VRAM em 38,6 vezes e viabiliza combinações modulares plug-and-play.
- Esparsidade para Resposta Instantânea: Em fluxos de RAG, recalcular apenas os 15% de tokens com maiores desvios viabiliza uma resposta 3,3 vezes mais veloz com precisão matemática total.