Stanford CS329A (Ep 12): Agent Evaluation & Long Tasks — Horizontes METR, OpenAI GDPval e DeepScholar-Bench

Quando uma equipe de engenharia desenvolve um agente autônomo de programação e o apresenta a executivos ou investidores, afirmar que "ele atingiu 92% no teste MMLU" gera total indiferença. As perguntas práticas que surgem no mundo dos negócios são muito mais exigentes e concretas:
- "Este agente autônomo consegue concluir uma tarefa complexa de várias horas de duração de ponta a ponta sem supervisão humana contínua?"
- "Se um engenheiro sênior leva 8 horas para refatorar um microserviço ou estruturar uma modelagem financeira, o agente entrega qualidade equiparável? E qual é o seu valor econômico líquido em dólares reais?"
Os benchmarks clássicos de múltipla escolha (MMLU, GSM8K, HumanEval) já estão saturados acima de 90% e comprometidos pela contaminação de dados na web. Mais fundamentalmente, acertar uma pergunta de 5 segundos é algo completamente distante de resolver Long-Horizon Agent Tasks que demandam centenas de decisões sequenciais com manutenção de estado ao longo de horas.
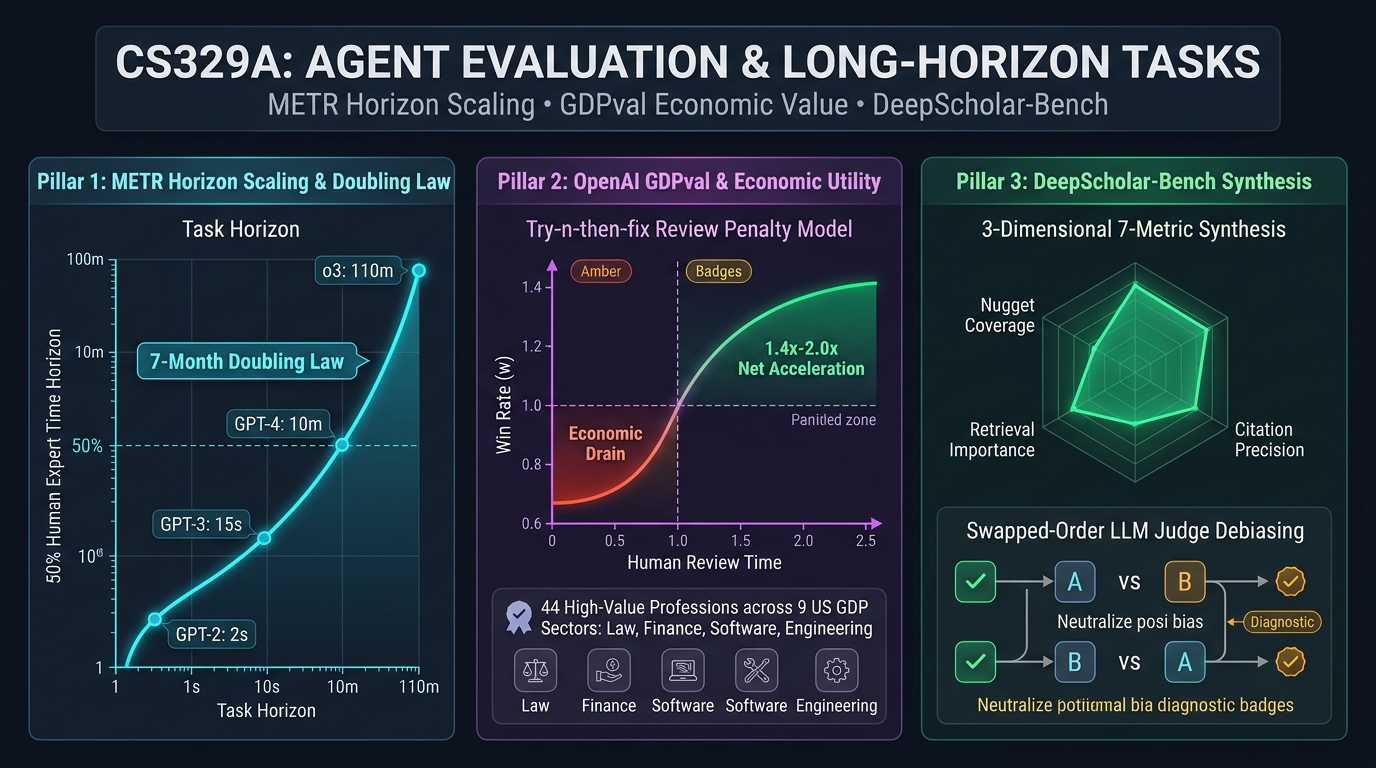
Neste encerramento da Parte 3: Engenharia de Agentes (Aulas 10 a 12) de Stanford CS329A: Self-Improving AI Agents, analisamos a ciência contemporânea dos Agent Evaluation Benchmarks — mensurando a inteligência artificial não por porcentagens vazias, mas em unidades físicas de Tempo Humano e Valor Econômico ($):
- Horizonte Temporal Humano (METR, 2025): O horizonte de tempo com 50% de sucesso (h_agent) e a lei empírica de duplicação a cada 7 meses.
- Valor Econômico Real (OpenAI GDPval, 2025): Avaliação de 44 profissões nos 9 setores chave do PIB dos EUA e a equação de custo de revisão humana "Try-n-then-fix".
- Avaliação Acadêmica sem Contaminação (DeepScholar-Bench, 2025): Estrutura tridimensional em 7 métricas e técnicas de despolarização para juízes LLM.
1. A Crise de Avaliação: O Fim dos Testes de Múltipla Escolha
Durante meia década, o ecossistema de inteligência artificial dependeu de conjuntos estáticos de perguntas e respostas. No entanto, o envio de agentes autônomos para ambientes industriais revelou falhas estruturais críticas:
- Saturação e Contaminação: Modelos de fronteira rapidamente superaram 90% no MMLU porque decoraram os enunciados durante o pré-treinamento na web.
- Inexistência de Horizonte Temporal: Resolver uma questão de 4 alternativas consome 2 segundos e 1 etapa. A engenharia real exige manter coerência de estado ao longo de mais de 100 chamadas consecutivas de ferramentas.
- A Ilusão da Limpeza: Testes de prova trazem enunciados impecáveis. O trabalho no mundo real é inerentemente "sujo" (Task Messiness): requisitos vagos, latências dinâmicas de rede, logs de erro truncados e ações destrutivas irreversíveis.
Por isso, os principais laboratórios abandonaram os testes de múltipla escolha em prol de métricas físicas contínuas.
┌─────────────────────────────────────────────────────────────────────────┐
│               Os 3 Pilares da Avaliação Moderna de Agentes              │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│     Horizontes METR      │  │    OpenAI GDPval ($)     │  │    DeepScholar-Bench     │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • Unidade: Tempo humano t│  │ • Unidade: Dólares reais │  │ • Unidade: Vetor 7 dim.  │
│ • Horizonte a 50% h_agent│  │ • 44 Carreiras digitais  │  │ • Fluxo semanal de arXiv │
│ • Duplicação em 7 meses  │  │ • Equação Try-n-then-fix │  │ • Zero contaminação      │
│ • Penalidade Messiness   │  │ • Juízes sêniores 14 anos│  │ • Cobertura Nuggets 39%  │
│ • 2s (GPT-2) -> 110m (o3)│  │ • Ponto de equilíbrio 40%│  │ • Despolarização inversa │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. Medindo Inteligência em Tempo Humano: METR (2025)
Afirmar que um modelo pontua 88% nada diz sobre sua capacidade de operação autônoma contínua. O conceituado instituto METR (Model Evaluation and Threat Research) estabeleceu um padrão revolucionário:
"Abandone notas em porcentagem. Meça a probabilidade de um agente de IA resolver com êxito uma tarefa que exige de um especialista humano o tempo $t$. Defina a inteligência pelo Horizonte Temporal de 50% (h_agent): a duração da tarefa humana que o modelo resolve com 50% de sucesso."
    [170 Tarefas Complexas de Software e ML (Segundos a 8 Horas)]
                               │
                ┌──────────────┴──────────────┐
                ▼                             ▼
       [Tempo Humano Padrão t]        [Taxa de Sucesso Real p]
                │                             │
                └──────────────┬──────────────┘
                               ▼
        [Regressão Logística baseada em Teoria de Resposta ao Item (IRT)]
           p = σ( (log h_agent - log t_task) × β_agent )
                               │
                               ▼
    [Horizonte Temporal a 50% h_agent: GPT-2 (2s) ──► OpenAI o3 (110 min)]
Formulação Logística do Horizonte Temporal
Inspirado na Teoria de Resposta ao Item (IRT), o METR modela a probabilidade de sucesso $p$ em função da duração humana t_task e do horizonte do agente h_agent:
========================================================================================
Equação do Horizonte Temporal do METR:
========================================================================================
p_success(agent, task) = σ( (ln(h_agent) - ln(t_task)) * β_agent )

Onde:
  • t_task  : Tempo médio exigido por um profissional humano qualificado
  • h_agent : O horizonte temporal a 50% do agente (quando t_task = h_agent, p = 0.5)
  • β_agent : Parâmetro de inclinação que reflete a queda de êxito com a dificuldade
  • σ(z)    : Função sigmoide logística padrão 1 / (1 + exp(-z))
========================================================================================
A Lei de Duplicação a cada 7 Meses
A análise empírica de 16 modelos de fronteira entre 2019 e 2025 revelou um crescimento exponencial contínuo:
- 2019 (GPT-2): Horizonte de 2 segundos (autocompletar simples).
- 2021 (GPT-3): Horizonte de 15 segundos.
- 2023 (GPT-4): Horizonte de 10 minutos.
- 2025 (OpenAI o3): Horizonte de 110 minutos (~2 horas).
- Tendência Comprovada: O horizonte de 50% de sucesso duplica exatamente a cada 7 meses (207 dias).
- Projeção Futura: Caso a tendência se mantenha, entre 2028 e 2030 os agentes atingirão um horizonte de 50% em projetos que exigem um mês integral (160 horas) de trabalho de um engenheiro sênior.
3. Mensurando o Valor Econômico Real: OpenAI GDPval (2025)
Se o METR mediu o tempo, o benchmark GDPval da OpenAI quantificou o capital financeiro real.
A OpenAI mapeou 44 profissões digitais de alta renda nos 9 setores centrais do PIB dos EUA (finanças, direito, software, engenharia, gestão médica, etc.). Contrataram profissionais com média de 14 anos de experiência prática para formular 220 tarefas profissionais densas (modelos financeiros DCF, análises de patentes, pipelines de dados em Python):
- Tempo humano médio de resolução: 9,5 horas (mediana de 5,0 horas).
- Valor médio de mercado por tarefa: $398 USD (~R$ 2.300).
Taxas de Vitória em Teste Cego
Profissionais sêniores avaliaram às cegas as entregas dos modelos em confronto direto com trabalhos humanos:
- GPT-4o: Taxa de vitória de 12,5% (rejeitado massivamente pelos especialistas).
- OpenAI o3: Taxa de vitória de 35,2%.
- Claude Opus 4.1: Taxa de vitória de 47,6% (Venceu ou Empatou)!
- Os modelos de raciocínio mais avançados já geram entregáveis que veteranos da indústria consideram idênticos ou superiores aos de profissionais humanos em praticamente metade das avaliações.
A Ilusão da Velocidade e a Fórmula Try-n-then-fix
O marketing frequentemente apregoa: "O agente concluiu em 2 minutos o que levaria 9 horas, um ganho de 270x!" O GDPval contesta essa alegação ao formalizar o Custo de Revisão e Retrabalho Humano (Try-n-then-fix):
========================================================================================
Equação do Custo Real de Tempo Econômico (Modelo Try-n-then-fix):
========================================================================================
E[T_real] = (M_T + R_T) * [ (1 - (1 - w)^n) / w ] + (1 - w)^n * H_T

Onde:
  • M_T : Tempo de geração da máquina (poucos minutos)
  • R_T : Tempo de revisão minuciosa que o especialista gasta auditando o rascunho
  • H_T : Tempo base em que o humano faz tudo do zero após constatar falhas
  • w   : Taxa de vitória do modelo (probabilidade de o trabalho ser aprovado)
  • n   : Número máximo de tentativas do agente antes de o humano desistir
========================================================================================
O Ponto de Equilíbrio Econômico
- Se a qualidade $w$ for insuficiente (ex.: GPT-4o, $w=12,5%$), o auditor humano perde horas procurando erros sutis e, no fim, refaz tudo manualmente. Assim, o uso do GPT-4o causou uma lentidão líquida de 13% (0,87x da velocidade humana)!
- Apenas ao ultrapassar o limiar crítico de $w \ge 40%$ (alcançado por o3 e Opus 4.1) o tempo de revisão é compensado, proporcionando um ganho produtivo real de 1,3x a 1,4x.
4. Avaliação Científica em Tempo Real: DeepScholar-Bench (2025)
Como avaliar agentes de pesquisa científica aberta em tarefas exploratórias sem gabarito fixo?
Lançado em agosto de 2025, o DeepScholar-Bench criou um fluxo de ingestão contínuo que captura artigos recém-publicados no arXiv semanalmente, erradicando qualquer contaminação por memorização prévia.
       [Ingestão Semanal Contínua do arXiv (Garantia de Zero Contaminação)]
                               │
                               ▼
┌─────────────────────────────────────────────────────────────────────────┐
│               Estrutura de 7 Métricas em 3 Dimensões (DeepScholar)      │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. Síntese de Conhecimento (Knowledge Synthesis)                        │
│    • Organização e Coerência (Estrutura lógica, prosa e formatação)     │
│    • Cobertura de Nuggets (Percentual de fatos atômicos essenciais)     │
│ 2. Qualidade de Recuperação (Retrieval Quality)                         │
│    • Taxa de Relevância (Aderência das fontes citadas ao tema)          │
│    • Importância Documental (Capacidade de achar artigos fundamentais)  │
│ 3. Verificabilidade (Verifiability)                                     │
│    • Precisão de Citações (Checagem se o texto condiz com a fonte)      │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [Juiz LLM com Ordem Invertida: Eliminação do Viés de Posição]
A Realidade dos 30,9%
Mesmo agentes de pesquisa renomados como o OpenAI DeepResearch atingiram uma média geométrica de apenas 30,9% nas 7 métricas:
- Forma Impecável vs Conteúdo Raso: Os agentes se destacaram na redação e estrutura (Organization: 85,7%), mas falharam em cobrir fatos atômicos indispensáveis (Nugget Coverage: 39,2%) e em referenciar artigos seminais (Document Importance: 12,4%).
- O Teste com Recuperador Perfeito: Ao fornecer previamente a lista de artigos fundamentais ao modelo, a nota geral subiu apenas para 49%. Isso comprova que o grande desafio da pesquisa autônoma não é o buscador, mas sim a capacidade de sintetizar ideias complexas a partir de múltiplas leituras.
5. Matriz Comparativa entre os Benchmarks de Avaliação
=============================================================================================================
Dimensão              METR (2025)                   OpenAI GDPval (2025)          DeepScholar-Bench (2025)
-------------------------------------------------------------------------------------------------------------
Métrica Principal     Tempo Humano (Horas/Minutos)  Valor Econômico Líquido ($)   Vetor de Qualidade em 7 Dim.
Escopo Avaliado       Engenharia de Software e ML   44 Carreiras Digitais do PIB  Revisões Científicas Abertas
Critério de Sucesso   Suítes de Testes Unitários    Julgamento Cego por Veteranos Confronto com Fatos Atômicos
Barreira Anticontam.  Tarefas Privadas Air-Gapped   Demandas Corporativas Reais   Alimentação Dinâmica do arXiv
Custo de Auditoria    Não Modelado (Passa/Falha)    Fórmula Try-n-then-fix        Juiz com Ordem Invertida
Recorde Atual         o3: 110 Minutos (50% Sucesso) Opus 4.1: 47,6% Vitória       DeepResearch: 30,9% Média Geo
=============================================================================================================
6. Perguntas e Respostas Técnicas (Q&A)
P1: O que é a "Complexidade de Atrito" (Task Messiness) no METR e como ela afeta o agente?
A métrica Task Messiness do METR mensura 16 fatores de atrito do mundo real ausentes em exercícios de programação teóricos:
- Ambiente Dinâmico: O sistema se modifica durante a execução (variações de rede, travas em bancos de dados).
- Ações Irreversíveis: Comandos destrutivos (um
DROP TABLEincorreto ou commits corrompidos) que impedem o retrocesso trivial. - Investigação Ativa: Os dados não vêm mastigados; o agente precisa vasculhar arquivos de log e deduzir o contexto.
As medições do METR comprovaram que a cada ponto adicional na escala de atrito, a taxa de sucesso do agente cai cerca de 8,1%. A robustez de um agente depende de tolerar esse ruído operacional.
P2: Como a "Média com Ordem Invertida" (Swapped-Order) anula o viés posicional de juízes LLM?
Quando um juiz LLM compara dois trabalhos $(A)$ e $(B)$, ele manifesta um Viés de Posição, favorecendo a primeira opção $(A)$ em 60% a 70% das avaliações pelo simples fato de sua ordem no texto.
Para cancelar essa distorção de forma exata, o DeepScholar-Bench aplica a Média com Ordem Invertida (Swapped-Order Averaging):
- Etapa 1: Apresenta
[A, B]e registra o vetor de notas $S_1 = [s(A), s(B)]$. - Etapa 2: Inverte a apresentação para
[B, A]e registra o vetor $S_2 = [s(B), s(A)]$. - Calcula a média aritmética:
S_final(A) = ( S1(A) + S2(A) ) / 2
S_final(B) = ( S1(B) + S2(B) ) / 2
Sob parâmetros de temperatura idênticos, a tendência derivada da ordem de leitura se anula algebricamente.
Conclusão & Encerramento da Parte 3
A Parte 3 (Engenharia de Agentes) consolidou os pilares operacionais dos sistemas autônomos:
- Na Aula 10, exploramos os SWE-Agents e a otimização de GPU com profiler (KernelBench).
- Na Aula 11, estruturamos a memória persistente com MemGPT, Cartridges e CacheBlend.
- Na Aula 12, fundamentamos o desempenho em grandezas físicas concretas: Tempo Humano (METR) e Retorno Econômico (GDPval).
Dispomos agora de todo o repertório de engenharia para criar, treinar, equipar e aferir sistemas autônomos avançados.
Rumo à Parte 4: As Fronteiras
Na seção final do curso, Part 4 · Frontiers (Aulas 13 a 17), adentraremos o mais alto desafio da inteligência artificial: A Natureza do Raciocínio em Máquinas.
Iniciaremos a Parte 4 na Aula 13 com: 《LLM Reasoning: As Bases do Raciocínio, Chain-of-Thought e Escala Cognitiva Emergente》, com base nas descobertas pioneiras de Denny Zhou no Google DeepMind.
Principais Conclusões
- Meça Tempo, Não Testes: O índice definitivo é o horizonte de 50% de sucesso (h_agent), que duplica a cada 7 meses (de 2s no GPT-2 para 110m no o3).
- O Custo de Revisão Define o ROI: Se a taxa de aprovação do agente for inferior a ~40%, o tempo gasto na auditoria humana causa prejuízo produtivo.
- A Síntese é o Desafio Real: Em tarefas abertas de pesquisa, buscar artigos é um problema resolvido; extrair e articular fatos verificados continua sendo a fronteira não superada.