Stanford CS329A (Ep 14): AlphaProof & Mathematical Reasoning — Verificação Formal, Lean 4, AlphaGeometry e Gemini Deep Think

Em nossa aula anterior sobre Raciocínio em LLMs, analisamos como a técnica de Cadeia de Pensamento (Chain-of-Thought, CoT) e a decodificação por Autoconsistência (Self-Consistency) acenderam a faísca do raciocínio causal de múltiplos passos em redes neurais. No entanto, em fronteiras de missão crítica — como a verificação de protocolos criptográficos, software de controle orbital ou demonstrações matemáticas de elite mundial — o texto em linguagem natural apresenta uma vulnerabilidade intrínseca:
"Por mais convincente e articulada que pareça uma cadeia de pensamento em linguagem natural gerada por um LLM, ela permanece sendo uma sequência estocástica de tokens probabilísticos. Um único erro sutil de sinal, uma premissa circular ou um lema alucinado desmorona completamente a estrutura. Na matemática rigorosa, uma prova 99% correta equivale a uma prova 0% correta."
Sejam bem-vindos à Aula 14 de Stanford CS329A: Self-Improving AI Agents, o segundo capítulo da Parte 4: Fronteiras (Frontiers in Reasoning & Autonomy). Com base nos avanços pioneiros liderados pelo Dr. Thang Luong (Diretor Sênior de Pesquisa no Google DeepMind), examinamos como a inteligência artificial transcendeu a previsão probabilística de palavras para se transformar em dedução matemática infalível e verificada por máquina, conquistando medalhas históricas na Olimpíada Internacional de Matemática (IMO):
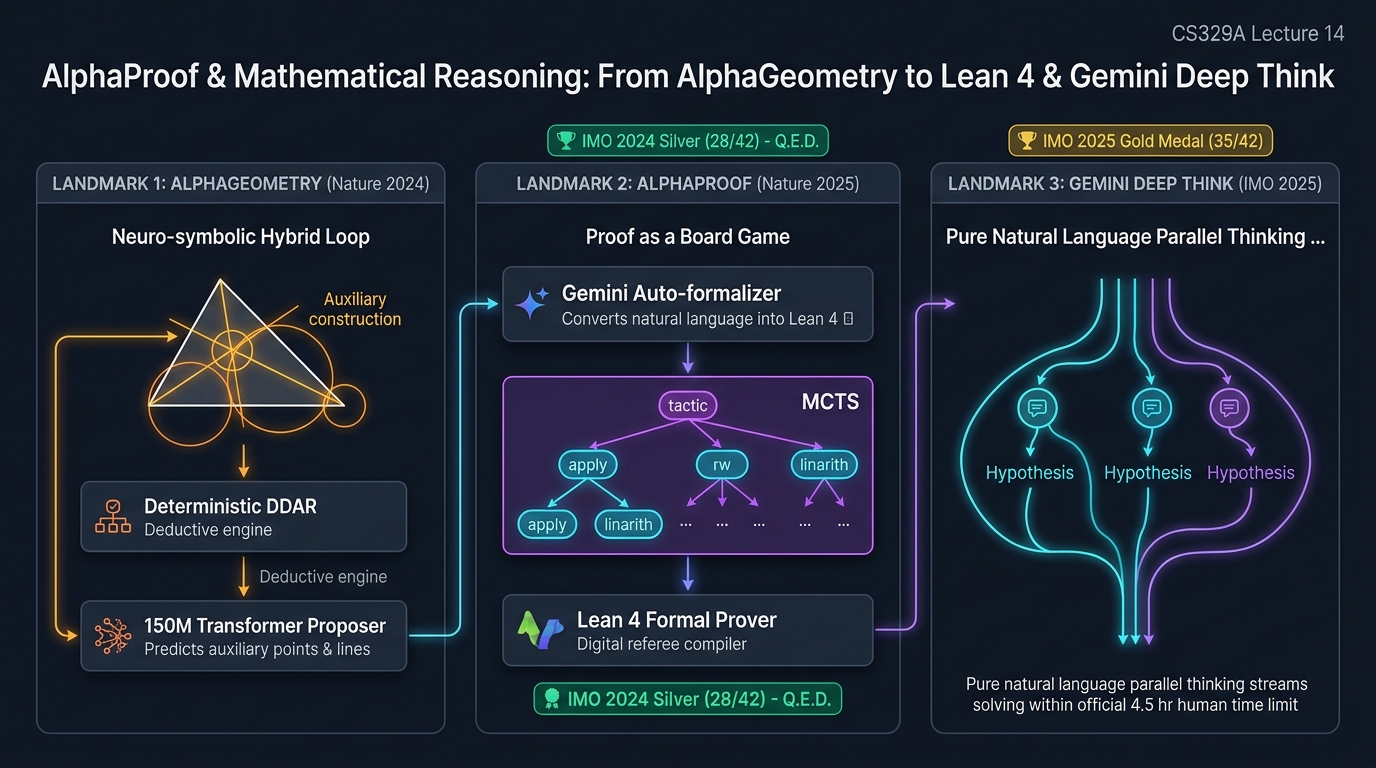
- AlphaGeometry (Nature 2024): A síntese neuro-simbólica que une motores dedutivos determinísticos a transformadores generativos para construções geométricas auxiliares.
- AlphaProof (DeepMind, Nature 2025): A transformação da demonstração formal de teoremas em um jogo de tabuleiro estilo AlphaZero utilizando Lean 4, autoformalização e Aprendizado por Reforço em Tempo de Teste (TTRL).
- Gemini Deep Think (IMO 2025): O triunfo do raciocínio puro em linguagem natural e pensamento paralelo (Parallel Thinking), conquistando a primeira Medalha de Ouro oficial na IMO (35/42) dentro do limite humano de 4,5 horas.
- Verificação formal em LLMs e raciocínio matemático: Comparativo técnico entre núcleos formais verificados por compilador e aprendizado por reforço irrestrito.
1. A Matemática: O Teste de Fogo Supremo para a Inteligência Artificial
Por que a matemática é amplamente reconhecida como o verdadeiro teste decisivo (« Litmus Test ») para agentes cognitivos autônomos? Enquanto benchmarks de código (como SWE-bench) ou tarefas de diálogo admitem aproximações heurísticas e toleram imprecisões, a matemática formal impõe três restrições estruturais inegociáveis:
┌──────────────────────────────────────────────────────────────────────────┐
│             Por que a matemática é o teste supremo para a IA             │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ Verificabilidade        │  │ Recompensa extremamente │  │ Espaço combinatório     │
│ mecânica objetiva       │  │ esparsa (Sparsity)      │  │ massivo e infinito      │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • Sistemas lógicos      │  │ • Centenas de passos com│  │ • Ramificação infinita  │
│   (Lean 4, Coq, Isabelle)│   zero recompensa até o   │    no espaço de lemas     │
│ • Compilador de tipos   │    fechamento final (Q.E.D)│  │ • Invenção de linhas e  │
│   determinístico e exato│  │ • Recompensa emitida    │    pontos auxiliares exige │
│ • 0% de alucinação      │    somente com êxito total │    autêntica genialidade   │
│ • Verdade binária (0/1) │  │ • Atribuição de crédito │  │ • Força bruta simples   │
│ • Tolerância zero a erro│    extremamente complexa   │    completamente inviável  │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
- Verificabilidade mecânica objetiva (Objective Mechanical Verifiability): Ao contrário de redações literárias ou pareceres jurídicos, cuja avaliação é subjetiva, a matemática formal é verificada com 100% de certeza por um programa compilador determinístico (como o verificador de tipos do Lean 4).
- Recompensa extremamente esparsa (Extreme Reward Sparsity): Em uma demonstração de nível olímpico com centenas de passos táticos, o agente recebe zero de recompensa positiva até o objetivo final (
Goal Solved) ser fechado. Uma tentativa 99% correta que falha na última linha recebe recompensa zero. - Espaço de busca combinatório colossal (Massive Combinatorial Search Space): Diferente do xadrez (fator de ramificação $\approx 35$) ou do Go ($\approx 250$), o espaço de lemas, definições e construções auxiliares é matematicamente infinito ($b \to \infty$).
2. Síntese Neuro-Simbólica: AlphaGeometry (Trinh et al., Nature 2024)
Os problemas de geometria euclidiana na IMO representam um desafio formidável até mesmo para competidores de elite. Mesmo que um aluno memorize todos os axiomas, não conseguirá avançar se não realizar uma construção auxiliar (Auxiliary Construction) criativa — como traçar um círculo circunscrito passando por três pontos não óbvios ou baixar uma perpendicular auxiliar.
Historicamente, a IA se dividia em duas abordagens isoladas:
- Motores dedutivos simbólicos (DDAR): Extremamente rápidos, 100% precisos e livres de erros de cálculo, mas desprovidos de imaginação criadora. Quando as regras padrão se esgotam, o motor trava definitivamente.
- Redes neurais profundas (Transformers): Ricas em intuição e reconhecimento de padrões, mas vulneráveis a alucinações de coordenadas, pequenos erros de cálculo e conjecturas infundadas.
O AlphaGeometry unificou ambos os paradigmas em uma arquitetura simbiótica e assimétrica:
               +-------------------------------------------+
               |       Problema de Geometria Euclidiana    |
               +---------------------+---------------------+
                                     |
                                     v
                        +----------------------------+
                        |   Motor Simbólico (DDAR)   | <---------+
                        |   - Base Dedutiva (DD)     |           │
                        |   - Raciocinador Alg. (AR) │           │
                        +--------------+-------------+           │
                                       |                         │
                         [Objetivo da prova atingido?]           │
                           /                   \                 │
                        (Sim)                  (Não / Travado)   │
                         /                       \               │
                        v                         v              │
             +--------------------+    +-----------------------+ │
             | Prova Final        |    | Transformer de 150M   | │
             | Legível            |    | Propositor Auxiliar   | │
             +--------------------+    +-----------+-----------+ │
                                                   |             |
                                      [Prevê pontos e linhas     │
                                       auxiliares indispensáveis]│
                                                   +-------------+
Motor de síntese de 100 milhões de dados
O gargalo principal consistia na escassez de dados: em toda a história das olimpíadas, existiam menos de 1.000 provas geométricas formalizadas. O DeepMind concebeu um pipeline de dados sintéticos:
- Geração de grafos aleatórios: Amostragem de 1 bilhão de configurações aleatórias de pontos, segmentos e círculos.
- Rastreamento dedutivo direto: O motor DDAR derivou sistematicamente mais de 100 milhões de teoremas geométricos válidos a partir dessas figuras casuais.
- Isolamento de dependência auxiliar: Filtrou-se 9 milhões de provas em que o teorema final só podia ser demonstrado se e somente se uma construção auxiliar específica houvesse sido adicionada.
- Destilação supervisionada: Treinou-se um Transformer de 150 milhões de parâmetros para prever com precisão cirúrgica essas construções indispensáveis no momento em que o motor simbólico empaca.
Resultados na IMO
Em uma bateria de 30 problemas geométricos históricos da IMO:
- O método simbólico de ponta anterior (método de Wu) resolveu apenas 10 problemas.
- O AlphaGeometry resolveu 25 de 30 problemas dentro do tempo oficial de prova, rivalizando com o desempenho de medalhistas de ouro humanos.
- No Problema 1 da IMO 2004, o AlphaGeometry descobriu que uma premissa estabelecida pelos autores era matematicamente redundante, formulando um teorema mais amplo e elegante.
3. Demonstrações como Jogo de Tabuleiro: AlphaProof (Nature 2025)
No entanto, a geometria é apenas uma parte da matemática. Para vencer a teoria dos números, a álgebra abstrata e a combinatória, um agente precisa manipular proposições formais através de deduções rigorosas.
Em julho de 2024, a equipe do Dr. Thang Luong revelou o AlphaProof, um sistema que reformulou a demonstração de teoremas como um jogo de soma zero contra um compilador rigoroso.
┌──────────────────────────────────────────────────────────────────────────┐
│                   Arquitetura do Sistema AlphaProof                      │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Autoformalizador Gemini  │                   │ Rede de Busca AlphaZero   │
├──────────────────────────┤                   ├───────────────────────────┤
│ • Enunciados em texto    │                   │ • Transformer de 3B params│
│ • 100M problemas brutos  │                   │ • Política de táticas Lean│
│ • Validação retro-traduz.│                   │   apply, rw, linarith     │
│ • Código formal Lean 4   │                   │ • Cabeça de valor:        │
│ • 80M teoremas válidos   │                   │   Distância ao Q.E.D.     │
└────────────┬─────────────┘                   └─────────────┬─────────────┘
             │                                               │
             └───────────────────────┬───────────────────────┘
                                     ▼
                      ┌─────────────────────────────┐
                      │    Kernel Formal do Lean 4  │
                      ├─────────────────────────────┤
                      │ • Verificador estrito tipos │
                      │ • Feedback de ambiente      │
                      │ • Validação binária (0/1):  │
                      │   - Tática compilada com OK │
                      │   - Habitação de tipo Q.E.D.│
                      └─────────────────────────────┘
O Ambiente Lean 4: O Tabuleiro Infinito
O Lean 4 é uma linguagem puramente funcional baseada no Cálculo de Construções Indutivas (CIC). De acordo com o isomorfismo de Curry-Howard:
- Uma Proposição matemática equivale a um Tipo.
- Uma Prova matemática equivale a um Termo (Programa) que habita aquele tipo.
- O Compilador Lean age como árbitro infalível: se o código compilar, o teorema está 100% verificado matematicamente.
Em cada passo, o agente observa o estado atual (Goal) e joga táticas formais como induction, ring, rw [mul_comm] ou linarith.
Autoformalização: Construção de 80 Milhões de Teoremas
Menos de 1.000 matemáticos em todo o mundo dominam fluentemente o Lean 4. O DeepMind utilizou modelos Gemini para traduzir milhões de exercícios de livros didáticos em código Lean 4, formando uma biblioteca de 80 milhões de proposições matemáticas formalizadas.
Aprendizado por Reforço em Tempo de Teste (TTRL)
Diante do Problema 6 da IMO 2024 — uma questão de combinatória extrema resolvida por apenas 5 dos 609 competidores de elite —, o modelo padrão travou. O DeepMind acionou o TTRL:
[Entrada: Problema 6 da IMO 2024]
         │
         ▼
[Sintetizador Automatizado de Problemas Gemini]
         │
         ├──> Síntese imediata de 400.000 variações estruturais do problema
         │    (Parâmetros reduzidos, casos limítrofes, lemas auxiliares)
         ▼
[Cluster massivo com milhares de chips TPU v5e]
         │
         ├──> Execução de auto-jogo AlphaZero nas 400.000 variações
         ├──> Atualização dinâmica dos pesos sinápticos durante 3 dias
         ▼
[Rede neural especializada gerada em tempo de teste]
         │
         ▼
[Prova formal em Lean 4 do Problema 6 completada e 100% verificada!]
O AlphaProof resolveu 4 de 6 problemas, alcançando 28 de 42 pontos: Medalha de Prata oficial na IMO (a apenas 1 ponto do Ouro).
4. O Triunfo da Linguagem Natural Pura: Gemini Deep Think (IMO 2025)
Apesar do triunfo de AlphaProof, persistiam dois entraves práticos:
- Traduzir enunciados para Lean 4 exigia um complexo pipeline de pré-processamento.
- O ciclo TTRL consumia 3 dias de computação intensa, ultrapassando o limite humano de 4,5 horas por dia de exame.
Em julho de 2025, o DeepMind lançou o Gemini Deep Think, provando que o raciocínio direto em linguagem natural pode atingir o ouro olímpico sem tradução intermediária:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Gemini Deep Think: Pensamento Paralelo                 │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ Ramo Hipotético A (Álg.)│  │ Ramo Hipotético B (Geom)│  │ Ramo Hipotético C (Comb)│
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • Progresso: 4 passos   │  │ • Travado no Lema 3     │  │ • Limite assintótico OK │
│ • Autoavalia contradição│  │ • Poda imediata do ramo │  │ • Integrado na hipótese │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
O Gemini Deep Think substitui a geração sequencial linear pelo Pensamento Paralelo (Parallel Thinking):
- Explora simultaneamente dezenas de caminhos algébricos, geométricos e analíticos.
- Ao encontrar um impasse em uma via, resgata invariantes parciais e os transfere para ramos ativos.
- Respeitando o limite oficial de 4,5 horas, resolveu 5 de 6 problemas (35 de 42 pontos), conquistando a primeira Medalha de Ouro oficial na IMO da história da IA.
5. Comparativo Arquitetural: Verificação Formal vs RL em Linguagem Natural
+-----------------------+----------------------------------+----------------------------------+
| Eixo de Comparação    | Verificação Formal (AlphaProof)  | RL em Linguagem Natural (DeepTh.)|
+-----------------------+----------------------------------+----------------------------------+
| Motor de Verificação  | Verificador de tipos do Lean 4   | LLM multi-agente e autocrítica   |
| Risco de Alucinação   | Exatamente 0% (Garantia formal)  | > 0% (Risco de saltos lógicos)   |
| Tempo de Busca        | Horas a dias (MCTS + TTRL)       | 4,5 horas (Inferência ao vivo)   |
| Domínio de Aplicação  | Software crítico, criptografia   | Ciência aberta, estratégia       |
| Infraestrutura        | Ecossistema Lean 4, Mathlib      | Supercomputadores RL distribuídos|
+-----------------------+----------------------------------+----------------------------------+
6. Conclusões e Lições para Engenharia de IA
- Dados sintéticos viabilizam o raciocínio de fronteira: O AlphaGeometry provou que na ausência de dados reais suficientes, motores dedutivos podem sintetizar centenas de milhões de provas para moldar a intuição neural.
- Verificação formal erradica a alucinação: Em setores onde erros custam vidas ou bilhões de dólares, agentes devem operar acoplados a compiladores como o Lean 4.
- Cálculo em tempo de inferência (TTRL) expande horizontes: O AlphaProof comprovou que atualizar pesos dinamicamente durante o teste permite resolver problemas inalcançáveis para modelos estáticos.
- Pensamento paralelo em linguagem natural atinge velocidade humana: O Gemini Deep Think revelou que a exploração paralela de hipóteses viabiliza raciocínio de medalha de ouro em tempo real.
Na próxima aula, Aula 15: Sistemas Autônomos e Confiabilidade, sairemos do ambiente controlado da matemática pura para explorar a engenharia de software no mundo real: autorrecuperação (Self-Healing), sandboxes de segurança e salvaguardas operacionais. Até lá!