Stanford CS329A (Ep 16): Multimodal & Embodied Agents — Modelos de Fundação Robóticos para o Mundo Físico (VLA, RT-2, OpenVLA e π₀)

Em nossa aula anterior sobre Sistemas Autônomos e Confiabilidade, vimos como os agentes de software operam em ambientes virtuais protegidos por barreiras e protocolos de controle. Contudo, uma pergunta fundamental desafia a comunidade de inteligência artificial:
"Pode uma inteligência restrita a telas de computador, gerando texto e executando código, ser considerada uma autêntica Inteligência Artificial Geral (AGI)? Nossa realidade não é regida por linhas de comando; ela é estruturada por gravidade, atrito, geometria 3D euclidiana e contatos dinâmicos entre corpos rígidos e deformáveis."
O que acontece quando concedemos a um modelo fundacional uma forma física — dois olhos de alta resolução (câmeras RGB) e um braço articulado de aço com sete graus de liberdade (manipulador robótico)?
- Pegar um ovo cru sem trincar a casca e depositá-lo com suavidade em uma frigideira;
- Separar por cores os brinquedos espalhados pela sala em suas respectivas caixas organizadoras;
- Conectar componentes microeletrônicos em uma esteira industrial com tolerância inferior a 0,1 milímetro!
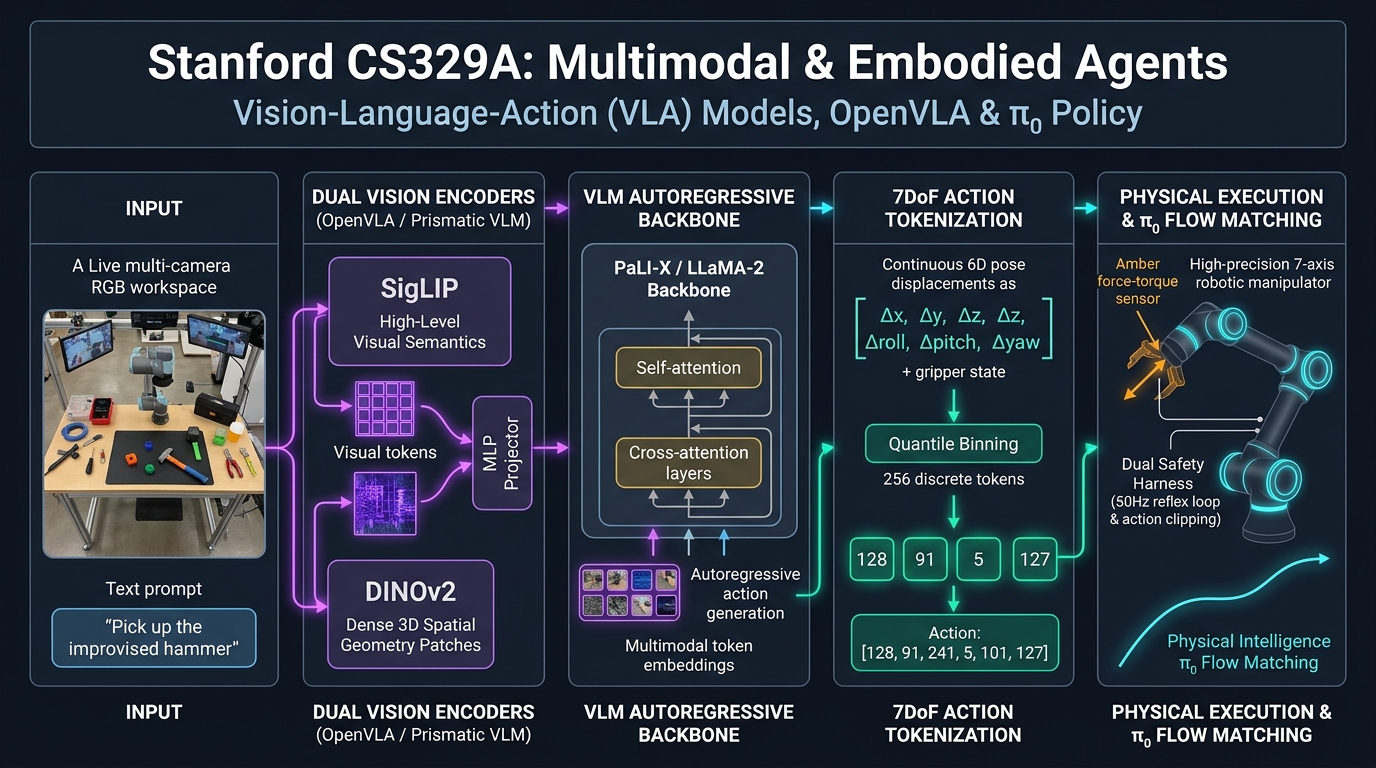
Sejam bem-vindos à Aula 16 de Stanford CS329A: Self-Improving AI Agents, o quarto capítulo da Parte 4: Fronteiras (Frontiers in Reasoning & Autonomy). Com base nos estudos pioneiros do Dr. Danny Driess (Pesquisador fundador da Physical Intelligence, ex-pesquisador líder no Google DeepMind Robotics), analisamos a arquitetura dos modelos de Visão-Linguagem-Ação (VLA, Vision-Language-Action):
- Ações como tokens de linguagem (RT-2, DeepMind 2023): A conversão de comandos cinemáticos contínuos de 7DoF em 256 tokens discretos integrados ao vocabulário de um VLM de 55 bilhões de parâmetros.
- A vanguarda do código aberto (OpenVLA, 2024): Superando modelos proprietários de 55B com uma arquitetura de 7B via fusão visual dual SigLIP + DINOv2, discretização por quantis e LoRA em GPUs comuns.
- Controle contínuo e políticas de difusão ($\pi_0$): Superando microvibrações para manipular materiais deformáveis, como dobrar roupas ou montar caixas de papelão.
- Arquitetura de segurança corporificada: A barreira dupla combinando limitação de velocidade por software e loops de reflexo por sensores de força-torque no hardware.
1. A Fronteira Física: Vencendo a Escassez de Dados na Robótica
Durante décadas, a robótica foi restringida por uma severa fome de dados. Enquanto os modelos de linguagem se alimentavam de trilhões de tokens da internet, dados físicos eram escassos e caros:
- Exigiam operação em laboratório com especialistas pilotando braços mecânicos por teleoperação.
- Uma frota de 13 robôs do Google operando continuamente durante 17 meses obteve apenas 130.000 trajetórias.
- Assim, as políticas clássicas eram frágeis: uma alteração de 10% na iluminação ou o deslocamento de 5 cm de um objeto levava o manipulador a agarrar o vazio.
O Dr. Danny Driess e os pesquisadores da DeepMind propuseram uma mudança conceitual profunda:
"Não tente treinar uma política robótica do zero com uma base de dados minúscula. Pegue um modelo de Visão-Linguagem (VLM) pré-treinado com bilhões de imagens e textos da internet e ensine-o a emitir comandos motores como se fossem palavras de um novo idioma estrangeiro."
┌──────────────────────────────────────────────────────────────────────────┐
│              Mudança de paradigma para os modelos VLA                    │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────────────┐   ┌──────────────────────────────────┐
│ Políticas robóticas tradicionais │   │ Modelos VLA                      │
├──────────────────────────────────┤   ├──────────────────────────────────┤
│ • Pequenas CNNs treinadas com    │   │ • Base multimodal de 7B a 55B    │
│   poucos milhares de dados locais│   │ • Conhecimento amplo da web      │
│ • Generalização semântica nula   │   │ • Senso comum físico integrado:  │
│ • Falha com desvios de 5 cm      │     "Pedras servem como martelos"    │
│ • Código refeito a cada tarefa   │   │ • Transferência zero-shot para   │
│ • Silos de tarefas fechados      │     novos objetos e ambientes reais  │
└──────────────────────────────────┘   └──────────────────────────────────┘
2. Ações como Palavras: RT-2 (Brohan et al., DeepMind 2023)
Em julho de 2023, o Google DeepMind lançou o Robotic Transformer 2 (RT-2), transformando modelos multimodais de larga escala (PaLI-X 55B e PaLM-E 12B) em controladores robóticos integrados de ponta a ponta.
[Entrada: Câmera RGB] + [Instrução: "Mova a bola de futebol para perto da foto do Messi"]
                                     │
                                     ▼
     ┌───────────────────────────────────────────────────────────────┐
     │             Backbone VLA massivo (PaLI-X 55B)                 │
     │  • Saber semântico: Identifica o rosto de Lionel Messi        │
     │  • Raciocínio espacial: Computa coordenadas 3D relativas      │
     └───────────────────────────────┬───────────────────────────────┘
                                     │
                                     ▼ (Geração autorregressiva de tokens)
                   "Action: 1 128 91 241 5 101 127"
                     │       │  │   │   │  │   │   └─ Fechar garra (127)
                     │       │  │   │   └──┴───┴───── Rotação 3D (Δroll, Δpitch, Δyaw)
                     │       └──┴───┴──────────────── Translação 3D (Δx, Δy, Δz)
                     └─────────────────────────────── Flag de prosseguimento
O Espaço de Ação 7DoF e a Discretização Uniforme em 256 Bins
Braços industriais atuam em um espaço contínuo com 7 graus de liberdade (7DoF):
- Deslocamento Translacional ($\Delta x, \Delta y, \Delta z$): Posição da garra no espaço 3D.
- Deslocamento Rotacional ($\Delta roll, \Delta pitch, \Delta yaw$): Mudança de atitude do punho.
- Abertura da Garra ($gripper$): Estado do atuador mecânico.
Para converter vetores numéricos em tokens para o Transformer, o RT-2 empregou a discretização uniforme:
- O intervalo operacional
[a_min, a_max](ex.:[-30cm, +30cm]) é particionado em 256 intervalos regulares (bins):
\text{bin\_index} = \left\lfloor 256 \times \frac{a - a_{\min}}{a_{\max} - a_{\min}} \right\rfloor, \quad \text{limitado a } [0, 255]
- 256 tokens raramente usados no vocabulário do VLM são associados a esses índices motores.
- Durante a inferência, uma máscara de restrição de saída (Output Constraint Mask) obriga o modelo a emitir exclusivamente esses 256 tokens de ação válidos.
Transferência de Senso Comum para o Espaço Físico
Mantendo o conhecimento prévio da internet, o RT-2 exibiu uma plasticidade notável:
- Sem nunca ter sido treinado com martelos no laboratório, ao receber a ordem "Pegue um objeto que sirva de martelo improvisado", escolheu uma pedra em vez de uma borracha.
- Executou comandos relacionais abstratos como "Jogue a lata vazia no lixo", triplicando a taxa de sucesso frente à arquitetura anterior (RT-1).
Co-Ajuste Fino (Co-Fine-Tuning) contra o Esquecimento
Se um VLM de 55B for ajustado somente com dados robóticos, ele sofre de esquecimento catastrófico (Catastrophic Forgetting), perdendo sua capacidade semântica. O RT-2 contornou isso com co-ajuste fino:
- Cada lote de treino mescla dados robóticos com pares convencionais de imagem e texto da web.
- O modelo preserva o entendimento do mundo real enquanto aprimora a destreza física.
3. Democratização e Código Aberto: OpenVLA (2024)
Embora notável, o RT-2 exigia clusters de TPU na nuvem e permaneceu um sistema fechado, inacessível a pesquisadores acadêmicos.
Em 2024, equipes de Stanford e Berkeley apresentaram o OpenVLA, um modelo VLA universal de 7B em código aberto, treinado com a base Open X-Embodiment (970.000 trajetórias em 22 plataformas robóticas).
               +-------------------------------------------+
               |              Imagem da Câmera RGB         |
               +---------------------+---------------------+
                                     |
                       +-------------+-------------+
                       |                           |
                       v                           v
             +--------------------+     +--------------------+
             |   Codificador      |     |   Codificador      |
             |   SigLIP (Semântica|     |   DINOv2 (Geometria|
             |   Visual Superior) |     |   Espacial 3D)     |
             +---------+----------+     +----------+---------+
                       |                           |
                       +-------------+-------------+
                                     | (Concatenação de canais)
                                     v
                        +----------------------------+
                        |   Projetor MLP de 2 Camadas|
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |  Backbone Llama-2 de 7B    |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        | 256 Tokens de Quantis      |
                        +----------------------------+
1. Fusão de Visão Dual: SigLIP + DINOv2 (Prismatic VLM)
A manipulação exige compreensão semântica ("O que é isto?") e geometria milimétrica ("Onde está a borda do copo com tolerância de 2 mm?"):
- SigLIP: Mapeia conceitos de linguagem e regiões visuais.
- DINOv2: Extrai características espaciais detalhadas, profundidade e arestas.
- A combinação desses recursos aumentou o sucesso de preensão em mais de 20% em comparação com o SigLIP isolado.
2. Discretização por Quantis (Quantile Binning)
A divisão uniforme do RT-2 era ineficiente: 90% dos movimentos reais são microajustes delicados, enquanto deslocamentos rápidos representam menos de 1%.
- O OpenVLA calculou os quantis empíricos sobre as 970.000 trajetórias:
\text{Limites de Bin: } q_k = \text{Quantile}\left(\mathcal{D}_{\text{actions}}, \frac{k}{256}\right), \quad k \in [0, 256]
- A resolução dos tokens concentra-se nos gestos finos, reduzindo expressivamente os erros de contato.
3. Ajuste Fino LoRA em uma Única RTX 4090
- Congelando os módulos visuais e aplicando LoRA em apenas 1,4% dos parâmetros do Llama-2, o OpenVLA se ajusta a um novo robô em menos de 15 horas.
- A quantização em 4 bits (NF4) reduz a exigência de memória para 7GB de VRAM, garantindo controle em tempo real a 6Hz em uma GPU convencional (NVIDIA RTX 4090).
- Em 29 tarefas práticas, o OpenVLA superou o RT-2-X de 55B com uma taxa de sucesso 16,5% superior, sendo 7 vezes mais leve.
4. Controle Contínuo e Políticas de Difusão: Physical Intelligence $\pi_0$ (2024)
Mesmo com esses avanços, a tokenização discreta enfrenta limites físicos:
- A quantização gera microtremores (jittering) indesejáveis em frequências acima de 50Hz.
- O manuseio de materiais deformáveis — como dobrar roupas ou montar caixas de papelão — exige trajetórias suaves e contínuas.
A equipe da Physical Intelligence, com participação do Dr. Danny Driess, desenvolveu o $\pi_0$ (pi-zero) via Flow Matching:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Arquitetura Physical Intelligence π₀                   │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Planejador VLM Global    │                   │ Política de Difusão       │
├──────────────────────────┤                   │ Contínua (Flow Matching)  │
│ • Análise de cena        │                   ├───────────────────────────┤
│ • Planejamento temporal  │ ── Metas latentes ─► • Inferência a 50Hz       │
│ • Rastreio de sub-metas  │                   │ • Campo vetorial contínuo │
└──────────────────────────┘                   │ • Sem ruído de quantização│
                                               └─────────────┬─────────────┘
                                                             │
                                                             ▼
                                               [Trajetória Contínua Suave]
                                               (Dobra roupas e monta caixas)
O $\pi_0$ usa o VLM para traçar metas amplas, enquanto o controlador gera trajetórias suaves em tempo real via eliminação de ruído, permitindo que um único modelo execute tarefas domésticas complexas com tecidos e embalagens.
5. Comparativo Arquitetural de Modelos Fundacionais em Robótica
+-----------------------+----------------------------------+----------------------------------+
| Característica        | RT-2 (Google DeepMind)           | OpenVLA (Stanford / Berkeley)    |
+-----------------------+----------------------------------+----------------------------------+
| Tamanho do Modelo     | 55B (PaLI-X) / 12B (PaLM-E)      | 7B (Backbone Llama-2)            |
| Codificador Visual    | ViT único                        | Fusão dual (SigLIP + DINOv2)     |
| Discretização Ação    | 256 Bins uniformes               | 256 Bins por quantis             |
| Requisito de Hardware | Cluster de TPUs em nuvem         | GPU comum de 24GB (RTX 4090)     |
| Eficiência de Ajuste  | Fine-tuning completo             | LoRA a 1,4% + quantização 4-bit  |
| Disponibilidade       | Proprietário / Fechado           | 100% Pesos e código abertos      |
+-----------------------+----------------------------------+----------------------------------+
6. Segurança Corporificada: Arquitetura Reflexa em Dois Níveis
Robôs aplicam forças mecânicas reais que podem danificar equipamentos ou ferir pessoas. Ambientes produtivos exigem um harness de segurança em dois níveis:
[Saída de Ação do Modelo VLA: Delta 7DoF]
                 │
                 ▼
[Nível 1: Limitação de Velocidade e Envoltória por Software]
  ├── Velocidade máxima contida: ||Δpos|| <= 5 cm por ciclo
  └── Confinamento restrito dentro da envoltória virtual de segurança
                 │
                 ▼
[Nível 2: Loop de Reflexo por Sensor de Força-Torque no Hardware (1000 Hz)]
  ├── Se a força de contato F_contato > 20 Newtons:
  └── Sobreposição imediata da ordem VLA -> Parada de emergência / Modo suave
- Limitação de ação por software: Se a ordem do modelo ultrapassar os parâmetros seguros (ex.: deslocamento maior que 5 cm por ciclo), o controlador de baixo nível corta o excesso.
- Reflexo por sensor de força-torque no hardware: Operando a 1.000 Hz nos atuadores, caso surja uma resistência inesperada (choque com um operador), o circuito desliga os motores de forma autônoma, anulando o risco físico.
7. Diretrizes Críticas para Engenharia de IA
- Ações físicas são uma modalidade da linguagem: Tratar o movimento como tokens discretos permite aproveitar o conhecimento da internet no controle físico.
- A visão dual é imprescindível: Unir o significado conceitual (SigLIP) à profundidade geométrica (DINOv2) é determinante para a precisão dos movimentos.
- Discretização por quantis corrige distorções: Distribuir os tokens conforme o padrão real de movimento evita imprecisões no posicionamento final.
- Difusão contínua aponta o futuro da robótica: Abordagens de Flow Matching como o $\pi_0$ eliminam oscilações mecânicas e destravam a manipulação de materiais flexíveis.
Em nossa aula de encerramento, Aula 17 (GRAND FINALE): Direções Futuras de Pesquisa, faremos a síntese dos 17 encontros de Stanford CS329A, discutindo as grandes fronteiras em aberto para a criação de agentes autoevolutivos e a chegada da verdadeira AGI. Nos vemos na grande final!