Stanford CS329A (Ep 8): Busca e Deep Research — Busca no Espaço de Programas (AlphaCode) e no Espaço do Conhecimento com Search-o1

Na engenharia de software e na pesquisa científica de vanguarda, a maestria técnica nunca é aferida por mera memorização passiva. Mesmo o arquiteto de software mais renomado não constrói um sistema concorrente distribuído de milhares de linhas sem nenhuma falha na sua primeira tentativa. Nenhum cientista ganhador do Prêmio Nobel formula a síntese de um composto terapêutico inovador recorrendo exclusivamente à memória biológica, sem consultar a literatura e patentes técnicas.
O poder supremo do intelecto humano decorre de sua capacidade de exploração sistemática:
"A aptidão de explorar milhões de hipóteses plausíveis, podar rigorosamente ramos infrutíferos, consultar ativamente repositórios externos de conhecimento para sanar lacunas pontuais e sintetizar sinais dispersos em conclusões demonstráveis."
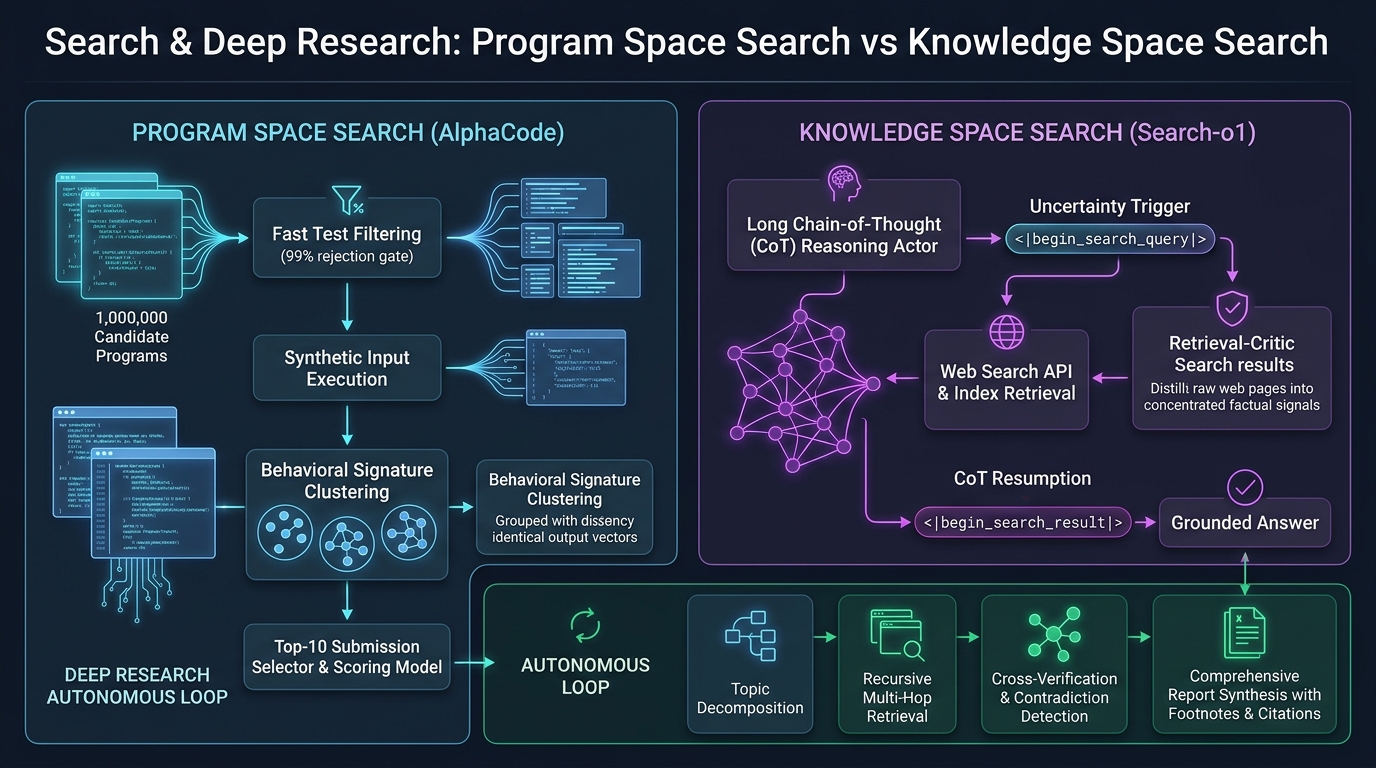
Nesta oitava aula do curso Stanford CS329A: Self-Improving AI Agents (Agentes de IA Autoevolutivos), investigamos como o conceito de Busca (Search) multiplica as capacidades cognitivas da inteligência artificial sob duas óticas essenciais:
- Busca no Espaço de Programas (Program Space Search): Amostragem em larga escala e agrupamento por assinaturas de comportamento em tempo de execução com o AlphaCode Competitive Programming (Programação Competitiva com AlphaCode) do Google DeepMind.
- Busca no Espaço do Conhecimento (Knowledge Space Search): Integração de longas cadeias de raciocínio com recuperação ativa de informações via Search-o1 Autonomous Investigation (Investigação Autônoma com Search-o1) e Self-Reflective Search Loops (Loops de Busca Autorreflexivos).
- Fluxos de Trabalho em Deep Research (Deep Research Workflows): A arquitetura do Information Synthesis Agent (Agente de Síntese de Informações), projetado para decompor problemas complexos, varrer a web recursivamente e produzir relatórios densos com atribuições diretas.
1. A Dupla Natureza da Busca Agêntica
Na IA tradicional, a busca operava em espaços discretos e finitos (como algoritmos A* em grafos ou minimax no xadrez). Nos agentes autônomos modernos, o conceito expandiu-se para o espaço probabilístico contínuo de sequências de tokens e para o ecossistema aberto da internet:
                          ┌─────────────────────────────────────┐
                          │    As Duas Fronteiras da Busca      │
                          └──────────────────┬──────────────────┘
                                             │
             ┌───────────────────────────────┴───────────────────────────────┐
             ▼                                                               ▼
┌─────────────────────────────────────────┐     ┌─────────────────────────────────────────┐
│     Busca no Espaço de Programas        │     │    Busca no Espaço do Conhecimento      │
├─────────────────────────────────────────┤     ├─────────────────────────────────────────┤
│ • AlphaCode 1 e 2 (Google DeepMind)     │     │ • Search-o1 e RAG Agêntico              │
│ • Recompensas binárias escassas (0 ou 1)│     │ • Conhecimento infinito na web aberta   │
│ • 1.000.000 de códigos concorrentes     │     │ • Identificação de lacunas de raciocínio│
│ • Assinaturas comportamentais de saída  │     │ • Filtragem "Reason-in-Documents"       │
│ • Agrupamento de invariantes de lógica  │     │ • Varredura recursiva e relatórios      │
└─────────────────────────────────────────┘     └─────────────────────────────────────────┘
O desafio compartilhado entre essas vertentes é o Compromisso Precisão-Abrangência (Precision-Recall Tradeoff) sob Orçamento Computacional Limitado:
- Na síntese de código, gerar milhões de variantes garante uma elevada probabilidade teórica de sucesso ($pass@k$), mas as competições impõem um limite restrito de 10 submissões ($10@k$).
- Na pesquisa aberta, consultas diretas à web retornam dezenas de milhares de tokens de texto HTML não estruturado, anúncios e afirmações divergentes que, se injetados sem critério, sobrecarregam a atenção do modelo (Context Pollution).
2. Busca no Espaço de Programas: AlphaCode (Capa da Science, 2022)
Torneios de algoritmos como os da plataforma Codeforces desafiam a capacidade intelectual de engenheiros seniores. As questões exigem deduzir propriedades matemáticas a partir de textos extensos e programar rotinas em C++ que respeitem limites severos de processamento ($O(N \log N)$) e memória ($256\text 256 MB$) contra milhares de testes ocultos. Qualquer falha sutil de índice resulta em Wrong Answer.
O AlphaCode do Google DeepMind rompeu esse paradigma ao comprovar que computação massiva de inferência associada a agrupamento semântico pode posicionar uma IA entre os 54% melhores competidores humanos.
                  [Especificação do Problema em Linguagem Natural]
                                         │
                                         ▼
           1. Amostragem Massiva e Diversificada (1.000.000 Códigos C++/Python)
              (Tags de dificuldade aleatórias, DP/Grafos; Temperatura: 0,25)
                                         │
                                         ▼
           2. Filtragem Inicial por Casos de Exemplo (Sample Tests)
              (Execução nas entradas básicas -> descarta >99% de código com falha)
                                         │
                                         ▼
           3. Entradas Sintéticas e Agrupamento por Assinaturas de Comportamento
              (Geração de 10 entradas aleatórias; vetor de saídas correspondentes)
                                         │
                                         ▼
           4. Seleção dos Representantes dos 10 Principais Clusters
              (Escolha de 1 candidato representativo por cluster primário)
                                         │
                                         ▼
                     [10 Submissões Oficiais no Torneio]
                  (Classificação superior a 54,3% dos competidores humanos)
A Lógica do Agrupamento por Assinaturas de Comportamento (Behavior Signatures)
Entre os 5.000 programas aprovados nos testes preliminares, como isolar os 10 mais aptos a superar todas as verificações ocultas?
Basear-se na proximidade textual (métricas BLEU ou representações vetoriais de sintaxe) revela-se ineficaz:
- Dois códigos quase idênticos podem se diferenciar em um único operador relacional (
<versus<=), transformando um algoritmo correto em um travamento por loop infinito. - Por outro lado, implementações estruturadas de forma completamente distinta (iterativa versus recursiva) podem materializar com perfeição o mesmo método matemático.
A DeepMind determinou que o valor do código repousa estritamente em seu comportamento dinâmico:
- Um modelo auxiliar formula 10 entradas de teste aleatórias válidas.
- Os 5.000 códigos remanescentes processam essas 10 entradas em um ambiente isolado (sandbox).
- Cada solução gera um vetor de comportamento baseado nas saídas produzidas:
Signature(P_i) = [ P_i(input_1), P_i(input_2), ..., P_i(input_10) ]
- O Invariante Fundamental: Códigos imperfeitos produzem saídas desconexas e dispersam-se em subgrupos isolados; já todos os códigos com a lógica exata produzem saídas rigorosamente idênticas para os mesmos dados, convergindo no maior cluster da distribuição.
- O AlphaCode encaminha uma amostra de cada um dos 10 maiores clusters para validação oficial.
AlphaCode 2: Eficiência Amostral 10.000x Superior com Gemini
No final de 2023, a DeepMind introduziu o AlphaCode 2, impulsionado pelo Gemini Pro:
- Adotou um Modelo de Pontuação (Scoring Model) refinado para selecionar os códigos mais elegantes e eficientes dentro de cada cluster.
- Elevou a taxa de acerto de 25% para 43%, alcançando o percentil 85 (nível Candidate Master).
- Marco Notável: O AlphaCode 2 superou o AlphaCode 1 original utilizando apenas 100 amostras em vez de 1.000.000, o que representa um ganho de eficiência amostral de 10.000x, demonstrando que o aprimoramento da capacidade de raciocínio da base encolhe substancialmente o espaço de busca empírico.
3. Busca no Espaço do Conhecimento: Search-o1 (2025)
Analisando o fluxo interno de modelos de raciocínio estendido (Long CoT como o1 ou DeepSeek-R1), nota-se que marcadores de incerteza ("talvez", "espere", "provavelmente") manifestam-se cerca de 30,4 vezes a cada desafio científico denso. Sistemas RAG convencionais recuperam dados exclusivamente no disparo da consulta, incapazes de responder a hiatos conceituais que surgem no meio de uma demonstração analítica complexa.
O Search-o1 viabilizou o conceito de Recuperação Ativa Autorreflexiva:
sequenceDiagram
    autonumber
    participant LLM as Ator de Raciocínio (QwQ-32B)
    participant Engine as Controlador de Busca
    participant Web as API de Busca Web
    participant Critic as Crítico de Recuperação (Reason-in-Docs)

    LLM->>LLM: Gerando cadeia de raciocínio Long CoT...
    Note over LLM: Lacuna detectada: "Qual a sequência de aminoácidos do CXCR4?"
    LLM->>Engine: Emite tag estruturada: <|begin_search_query|> human CXCR4 sequence <|end_search_query|>
    Note over LLM: Pausa de raciocínio (Contexto preservado no KV Cache)
    Engine->>Web: Executa busca web em tempo real
    Web-->>Engine: Retorna 10 páginas HTML brutas (50.000 tokens)
    Engine->>Critic: Encaminha HTML bruto + Etapa de dedução
    Critic->>Critic: Depura ruídos e extrai o fato essencial (Reason-in-Docs)
    Critic-->>Engine: "CXCR4 é um GPCR de 352 aminoácidos; o resíduo 28 acopla o ligante."
    Engine->>LLM: Injeta dado fático: <|begin_search_result|> Fato purificado <|end_search_result|>
    Note over LLM: Retomada do raciocínio
    LLM->>LLM: Conclui a análise bioquímica com ancoragem fática comprovada
Mecanismos Centrais do Search-o1
- Ator de Raciocínio (Reasoning-Actor): Quando o modelo reconhece baixa convicção em seus parâmetros, emite marcadores de consulta (
<|begin_search_query|>), interrompe o processamento e congela os tensores de atenção. - Crítico de Recuperação ("Reason-in-Documents"): Previne a sobrecarga do contexto decorrente de páginas web volumosas. Um modelo analítico secundário condensa o material bruto em duas a três sentenças objetivas, estritamente focadas na dúvida imediata.
Resultados no GPQA Diamond (Raciocínio Científico de Nível de Doutorado):
========================================================================================
Arquitetura                  Acurácia Geral    Química         Biologia        Física
----------------------------------------------------------------------------------------
Especialistas Humanos (Doutores) 65,4%           48,9%          37,2%           39,9%
Modelo de Raciocínio Base (QwQ)  58,1%           45,2%          41,5%           43,2%
Agente RAG Estático Convencional 61,6%           51,0%          44,8%           47,0%
Search-o1 (Busca Dinâmica CoT)   63,6% (+5,5p)   56,4% (+7,5p)  50,2% (+13,0p)  52,8% (+12,9p)
========================================================================================
Na avaliação do GPQA Diamond, o Search-o1 não apenas superou os modelos RAG tradicionais com folga, como também ultrapassou a média de pesquisadores humanos com doutorado nas disciplinas de química, biologia e física.
4. Estrutura do Agente de Deep Research
Integrando o método de agrupamento e poda do AlphaCode à recuperação contínua do Search-o1, consolida-se o modelo dos agentes modernos de Deep Research Agent LLM:
                       [Demanda Complexa de Investigação]
                                       │
                                       ▼
                   ┌──────────────────────────────────────┐
                   │    Decomposição Estruturada do Plano │
                   │  (Subdivisão em 5 a 8 hipóteses)     │
                   └──────────────────┬───────────────────┘
                                      │
          ┌───────────────────────────┼───────────────────────────┐
          ▼                           ▼                           ▼
┌──────────────────┐        ┌──────────────────┐        ┌──────────────────┐
│  Sub-hipótese A  │        │  Sub-hipótese B  │        │  Sub-hipótese C  │
│  Busca Multihop  │        │  Busca Multihop  │        │  Busca Multihop  │
└─────────┬────────┘        └─────────┬────────┘        └─────────┬────────┘
          │                           │                           │
          └───────────────────────────┼───────────────────────────┘
                                      │
                                      ▼
                   ┌──────────────────────────────────────┐
                   │    Crítico de Contradição e Fontes   │
                   │(Triagem de divergências documentais) │
                   └──────────────────┬───────────────────┘
                                      │
                                      ▼
                   ┌──────────────────────────────────────┐
                   │    Relatório Baseado em Evidências   │
                   │ (Documento extenso com links fontes) │
                   └──────────────────────────────────────┘
Etapas da Investigação Autônoma em Profundidade
- Decomposição de Hipóteses: Converte briefings abrangentes em questionamentos técnicos objetivos e independentes.
- Varredura Recursiva Multidirecional: Rastreia hiperlinks presentes nas referências primárias para examinar relatórios técnicos originais, patentes e regulamentações.
- Equalização de Contradições: Contrasta alegações mercadológicas com medições laboratoriais independentes, pontuando níveis de credibilidade.
- Atribuição Rastreável: Garante que cada número ou dado relevante contenha a URL de origem, eliminando alucinações.
5. Comparativo dos Métodos de Busca
=========================================================================================================
Dimensão               RAG Estático Padrão            AlphaCode (Espaço Programas) Search-o1 (Espaço Raciocínio)
---------------------------------------------------------------------------------------------------------
Ambiente de Consulta   Base Vetorial Pré-indexada     Espaço Discreto de Tokens    Web Aberta e APIs Vivas
Ponto de Ativação      Disparo inicial único          Amostragem massiva inferência Reconhecimento de incerteza
Critério de Poda       Similaridade Cosseno Top-K     Assinatura comportamental    Destilação Reason-in-Docs
Validação              Distância no Espaço Latente    Execução em ambiente fechado Consistência lógica e cruzamento
Limitação Principal    Perda de foco em etapas longas Elevado custo de processamento Latência nas conexões web
=========================================================================================================
6. Questões Técnicas Aprofundadas
P1: Por que o agrupamento por assinaturas de comportamento é superior à comparação sintática no AlphaCode?
A correção de um algoritmo não se reflete na estrutura superficial do texto. Dois códigos com estruturas sintáticas (AST) praticamente idênticas podem divergir totalmente devido a um único ajuste de operador lógico. De modo inverso, implementações iterativas e recursivas possuem estruturas distintas, mas podem expressar a mesma equivalência matemática exata. Registrar o vetor de respostas perante entradas padronizadas viabiliza o agrupamento seguro das soluções corretas em um cluster dominante.
P2: De que maneira o "Reason-in-Documents" mitiga a degradação de contexto em deduções longas?
Inserir páginas web completas dispersa a atenção do modelo com elementos irrelevantes (menus, anúncios, cabeçalhos). A abordagem "Reason-in-Documents" utiliza um modelo intermediário que sintetiza apenas as linhas fundamentais de dados factuais, preservando a pureza e a continuidade do fluxo dedutivo principal.
Resumo e Próxima Aula
A busca transforma modelos de linguagem de formuladores estáticos em agentes dinâmicos de investigação. O AlphaCode demonstrou a capacidade de superar desafios de programação competitiva explorando o espaço de código; o Search-o1 e o Deep Research provaram que a busca ativa durante a reflexão capacita a IA a solucionar desafios científicos de nível de pós-graduação.
Na Aula 9, concluiremos a Parte 2 (Treinamento e Evolução) com uma visão unificada: Post-Training Evolution — A Trajetória de Chatbots a Frotas de Agentes Autônomos (SFT, RLHF, Tool Grounding e Alinhamento Global).
Destaques Essenciais
- Poder da Busca em Tempo de Inferência: Amostragens substanciais com critérios rigorosos de poda (AlphaCode) superam a geração de tiro único.
- Assinatura Dinâmica vs. Estrutura Textual: A validação real de um código reside em suas saídas efetivas; apenas assinaturas comportamentais reúnem as soluções verídicas.
- Recuperação Ativa durante o Pensamento: Intercalar aquisição de fatos purificados durante o processo dedutivo (Search-o1) estabelece o padrão para o raciocínio automatizado em tarefas de alta complexidade.