Pular para o conteúdo principal

2 publicações com a etiqueta "ai-architecture"

Ver todas as etiquetas

[Stanford CS329A #2] Escalonamento de Computação em Tempo de Inferência: Além do Pré-Treinamento rumo à Inferência Ótima

· 12 min para ler
Jaybee
AI & Robotics Engineer

Stanford CS329A Test-Time Compute Scaling

Boas-vindas ao segundo capítulo de nossa análise técnica sobre o curso de pós-graduação da Universidade de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA com Autoaperfeiçoamento, Outono de 2025).

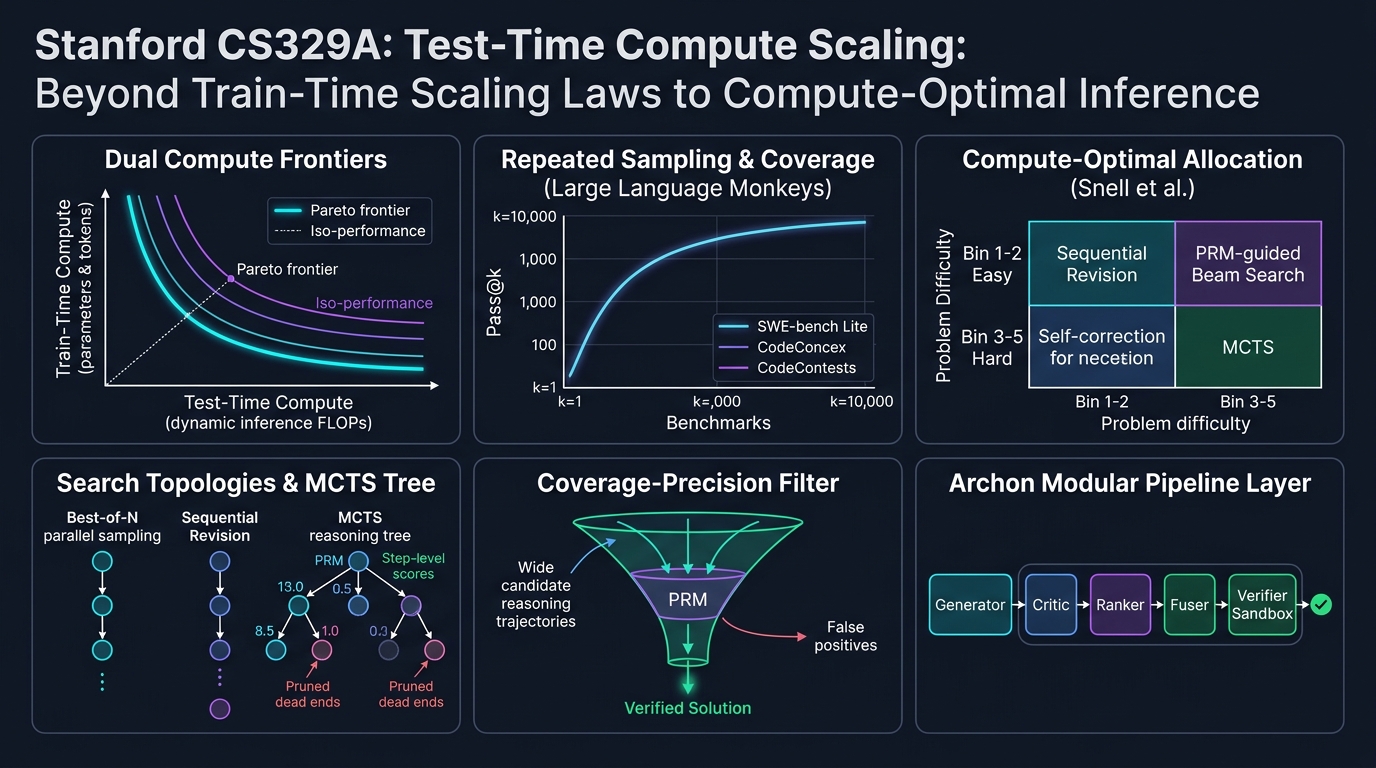
Em nossa aula inaugural, mapeamos a transição macroeconômica dos preditores autorregressivos de próximo token para laços agênticos autônomos com retroalimentação do ambiente. Hoje, exploramos o alicerce computacional indispensável a essa autonomia: o Escalonamento de Computação em Tempo de Inferência (Test-Time Compute Scaling / Inference-Time Scaling).

Por mais de meia década, a doutrina hegemônica da indústria foi ditada pelas leis de escalonamento do pré-treinamento (Kaplan et al., Chinchilla): erguer clusters colossais de GPUs, expandir a contagem de parâmetros N e processar dezenas de trilhões de tokens web. No entanto, com os pesos θ congelados, o que ocorre quando nos recusamos a aceitar uma resposta sôfrega (greedy) gerada em 50 milissegundos? E se um agente investir 10 segundos, 1 minuto ou 10 minutos para explorar deliberadamente árvores de raciocínio, verificar passos intermediários e revisar suas hipóteses?

Com base nas evidências empíricas de Large Language Monkeys (Brown et al., 2024), no estudo Compute-Optimal Scaling de Snell et al. (Stanford/UC Berkeley, 2024) e no framework de arquitetura modular Archon, formalizamos como a alocação de FLOPs de inferência em substituição à mera escala de parâmetros redefine a inteligência artificial moderna.

flowchart TD
subgraph PreTrain ["Fronteira Clássica: Escalonamento no Pré-Treinamento"]
direction TB
P1["Trilhões de Tokens Web (D)"] --> P2["Clusters Massivos de GPU (C_train)"]
P2 --> P3["Modelo Denso Congelado (θ)"]
P3 --> P4["Passagem Única Gananciosa (Custo Fixo O(1))"]
end

subgraph TestTime ["Fronteira CS329A: Escalonamento na Inferência"]
direction TB
T1["Pesos Base Congelados (θ)"] --> T2["Alocação Dinâmica de FLOPs na Inferência"]
T2 --> T3{"Seleção Adaptativa por Dificuldade"}
T3 -- "Baixa Dificuldade (Bin 1-2)" --> T4["Revisão Sequencial (Autocorreção)"]
T3 -- "Alta Dificuldade (Bin 3-5)" --> T5["Busca em Árvore Guiada por PRM (MCTS / Beam Search)"]
T4 --> T6["Verificador de Modelo de Recompensa de Processo (PRM)"]
T5 --> T6
T6 --> T7["Solução Verificada Matemática e Mecanicamente"]
end

PreTrain -.->|"Ponto de Inflexão: Saturação de Parâmetros"| TestTime
[Stanford CS329A #1] Visão Geral do Curso: De Grandes Modelos de Linguagem a Agentes de IA Autoevolutivos

· 12 min para ler
Jaybee
AI & Robotics Engineer

Stanford CS329A Agentes de IA Autoevolutivos

Bem-vindos à análise técnica detalhada do curso CS329A da Universidade de Stanford: Self-Improving AI Agents (Agentes de IA Autoevolutivos, Outono de 2025).

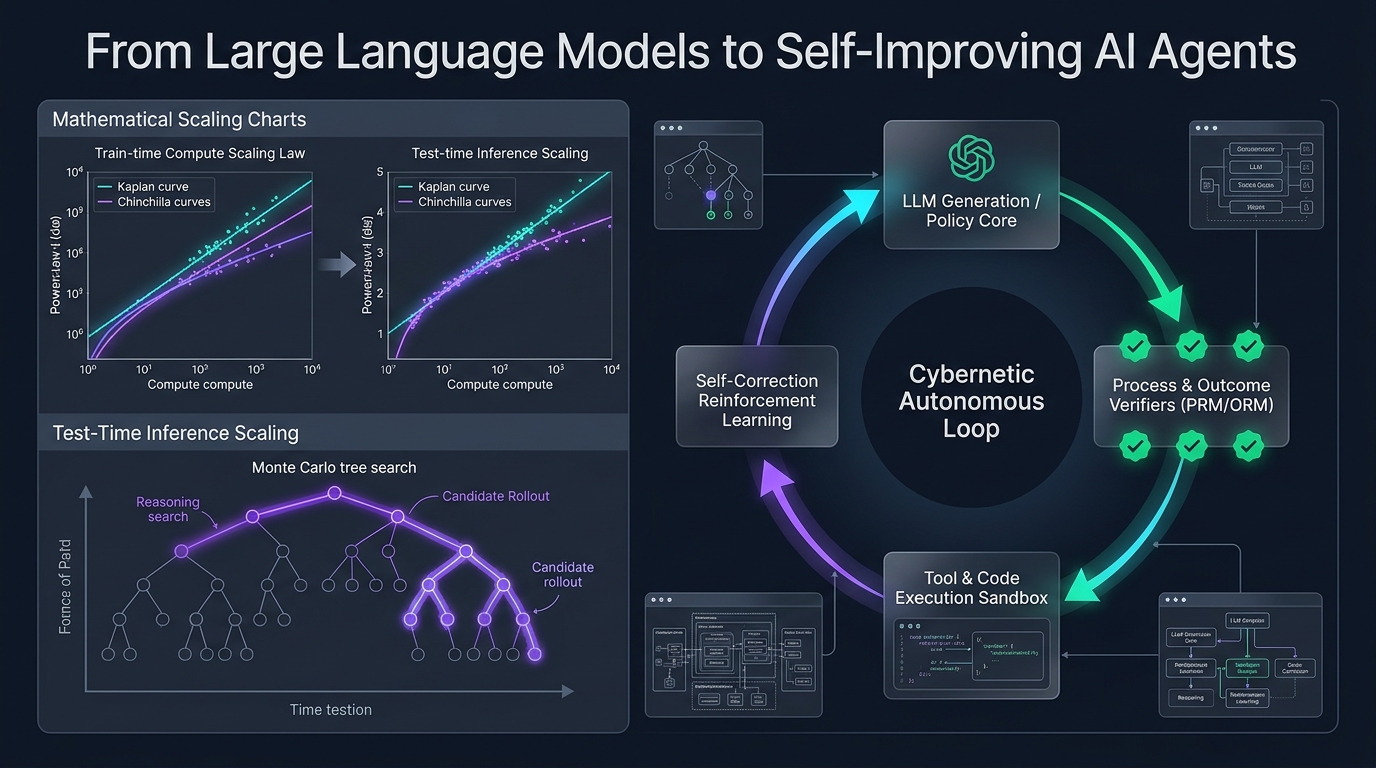
Nos últimos quatro anos, o ecossistema de inteligência artificial foi conduzido por um dogma singular e dominante: o pré-treinamento de modelos cada vez maiores sobre volumes colossais de texto gera capacidades cognitivas crescentes de maneira previsível. Embora esse paradigma tenha deflagrado a moderna revolução da IA generativa — dando origem a sistemas como GPT-4, Claude 3.5 e Gemini —, a fronteira da pesquisa em aprendizado de máquina alcançou um ponto de inflexão decisivo.

Os modelos fundamentais estáticos (Static Foundation Models), independentemente de sua contagem estratosférica de parâmetros, possuem limitações intrínsecas inescapáveis: são preditores passivos e autorregressivos do próximo token operando em malha aberta (open-loop). Uma vez congelados seus pesos ao término do treinamento, eles não conseguem alocar dinamicamente mais processamento para problemas complexos, não verificam autonomamente a exatidão factual de suas deduções, nem corrigem seus próprios erros com base no feedback do ambiente.

flowchart LR
subgraph Paradigma_Estatico ["Paradigma Estático Convencional (2020-2024)"]
direction TB
A1[Corpus Web Maciço] --> B1[Cluster de Pré-treinamento]
B1 --> C1[Ajuste Fino Supervisionado SFT]
C1 --> D1[Modelo Estático Congelado]
D1 -->|Passagem Direta Única| E1[Resposta Textual Isolada]
end

subgraph Paradigma_Autonomo ["Fronteira Stanford CS329A: Agentes Autoevolutivos"]
direction TB
A2[Objetivo Complexo] ==> B2[Motor de Raciocínio e Planejamento]
B2 -->|Ações / Rascunhos de Código| C2[Ambiente Sandbox e Ferramentas]
C2 -->|Rastros de Execução e Estado| D2[Verificadores de Processos PRM]
D2 -->|Sinais de Recompensa e Erro| B2
D2 ==>|Atualizações na Inferência e Treino| E2[Autoevolução Contínua]
end

Stanford CS329A enfrenta a questão basilar da próxima década da IA: Como projetar agentes de software que não apenas gerem texto, mas inspecionem, verifiquem, planejem e aperfeiçoem continuamente seu próprio raciocínio e código-fonte?

Nesta aula inaugural, decompomos a trajetória evolutiva dos LLMs fundamentais até as arquiteturas agênticas, formalizamos a matemática das leis de escala e a alocação de computação em tempo de inferência, analisamos os quatro arquétipos canônicos de fluxos de trabalho agênticos e isolamos o gargalo crítico da inteligência autônoma: a Lacuna Gerador-Verificador (Generator-Verifier Gap).