[Stanford CS329A #4] Uso de Ferramentas e Feedback de Execução de Código: ReAct, RLEF e Autocorreção Constitucional

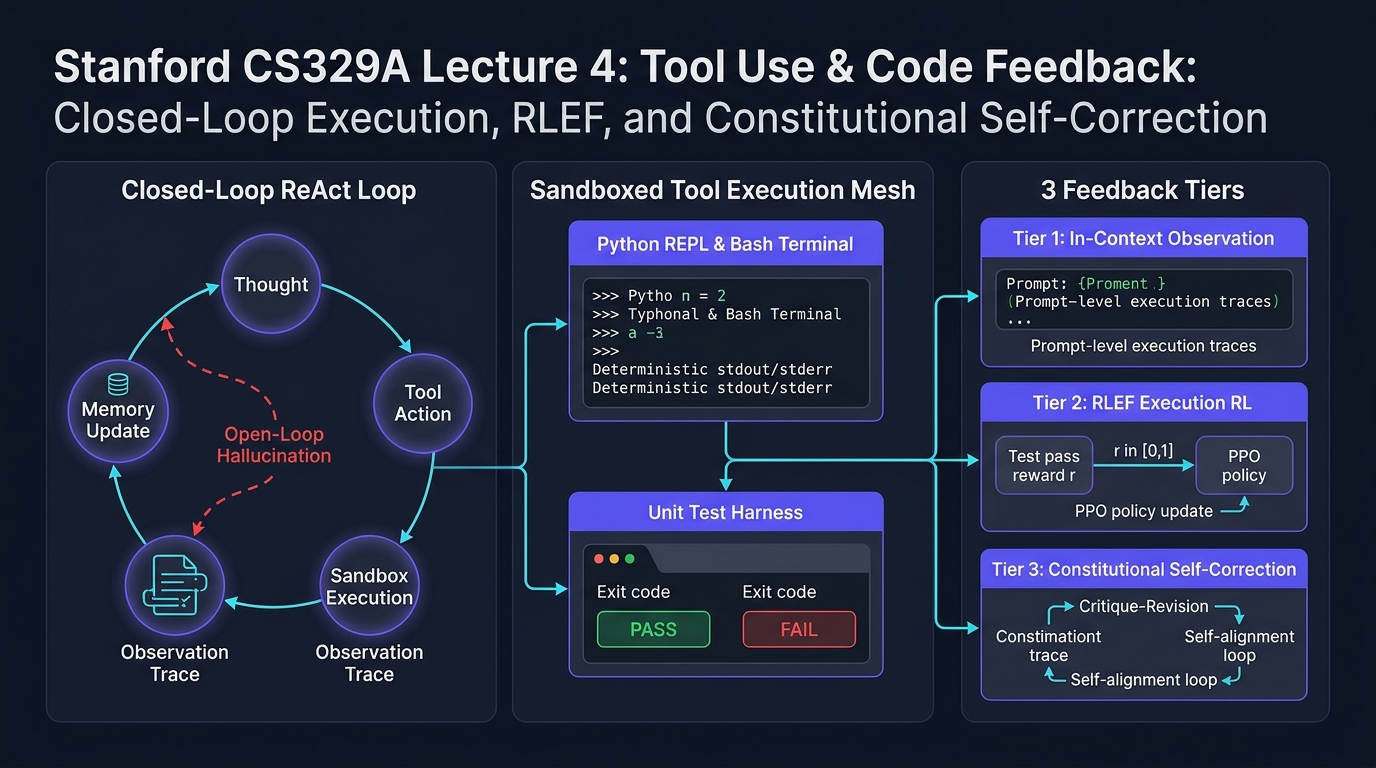
Boas-vindas ao quarto volume de nossa análise técnica detalhada do curso de pós-graduação da Universidade de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA que se Autoaperfeiçoam, Outono de 2025).
Nas Aulas 2 e 3, investigamos como o dimensionamento computacional no momento da inferência (Test-time Compute Scaling) e os Modelos de Recompensa de Processo (PRMs) capacitam os modelos de linguagem a explorar árvores de busca e validar derivações matemáticas intermediárias. No entanto, por mais sofisticada que seja uma cadeia de raciocínio (CoT), modelos limitados estritamente à geração de texto permanecem "estudantes trancados em uma sala resolvendo provas". Eles dependem exclusivamente da memória paramétrica estática e congelada (Parametric Memory) adquirida no pré-treinamento. Perante dados dinâmicos do mundo exterior, APIs mutáveis ou restrições sintáticas rígidas de código executável, um modelo sem ancoragem no ambiente inevitavelmente alucina.
A Aula 4 representa o ponto de virada arquitetural que liberta o modelo desse confinamento: o uso de ferramentas (Tool Use) e os ciclos de feedback de execução (Feedback Loops).
Agentes autônomos modernos não tratam código ou chamadas de API como meros alvos de texto final, mas como sensores e atuadores interativos. Nesta aula, dissecamos e reestruturamos os três níveis fundamentais de feedback para agentes:
- Feedback ambiental no nível de prompt: A integração entre reflexão e ação via ReAct (Yao et al., 2022).
- Feedback de execução no nível da política: A gravação direta de diagnósticos de compiladores e suítes de teste nos pesos neurais via RLEF (Reinforcement Learning from Execution Feedback, 2024).
- Alinhamento autônomo de valores sem supervisão humana: A substituição de avaliadores humanos caros por ciclos de crítica e revisão orientados por princípios em linguagem natural via Constitutional AI (Anthropic, 2022).
flowchart TD
    subgraph ClosedLoop ["Arquitetura de Agente em Malha Fechada (Closed-Loop)"]
        direction TB
        Agent["Núcleo do Agente Autônomo (Política LLM)"]
        Thought["Raciocínio Interno (Espaço de Pensamento L)"]
        Action["Chamada Executável de Ferramenta (Espaço de Ação A)"]
        Sandbox["Ambiente Isolado de Execução (Python REPL / Shell / Search)"]
        Obs["Observação Determinística do Ambiente (Stdout / Stderr)"]

        Agent --> Thought
        Thought --> Action
        Action --> Sandbox
        Sandbox --> Obs
        Obs -->|"Atualização do Contexto (c_{t+1})"| Agent
    end

    subgraph FeedbackTiers ["Os 3 Níveis de Feedback para Agentes"]
        direction TB
        T1["Nível 1: Feedback Ambiental em Contexto (ReAct)<br/>• Ciclo intercalado: Thought + Action + Observation<br/>• Taxa de alucinação factual reduzida a 0% em buscas"]
        --> T2["Nível 2: Feedback de Execução na Política (RLEF)<br/>• Modelação MDP: Estado, Ação, Recompensa da Sandbox<br/>• Otimização PPO com divisão de testes públicos e privados<br/>• Llama-3.1-70B salta de 27,5% para 40,1% em 1@3 no CodeContests"]
        --> T3["Nível 3: Autocorreção Autônoma de Valores (Constitutional AI)<br/>• Dataset SFT via ciclos de crítica e revisão com princípios constitucionais<br/>• Treinamento de modelo de preferência RLAIF sem gargalo humano<br/>• Escalabilidade massiva da supervisão"]
    end

    ClosedLoop ==> FeedbackTiers