[Robótica Webots] Avaliação Determinística via evaluate_qlearning & Benchmark Contra DQN e SARSA (#4)
· 2 min para ler

📌 Resumo dos Pontos Principais (TL;DR)
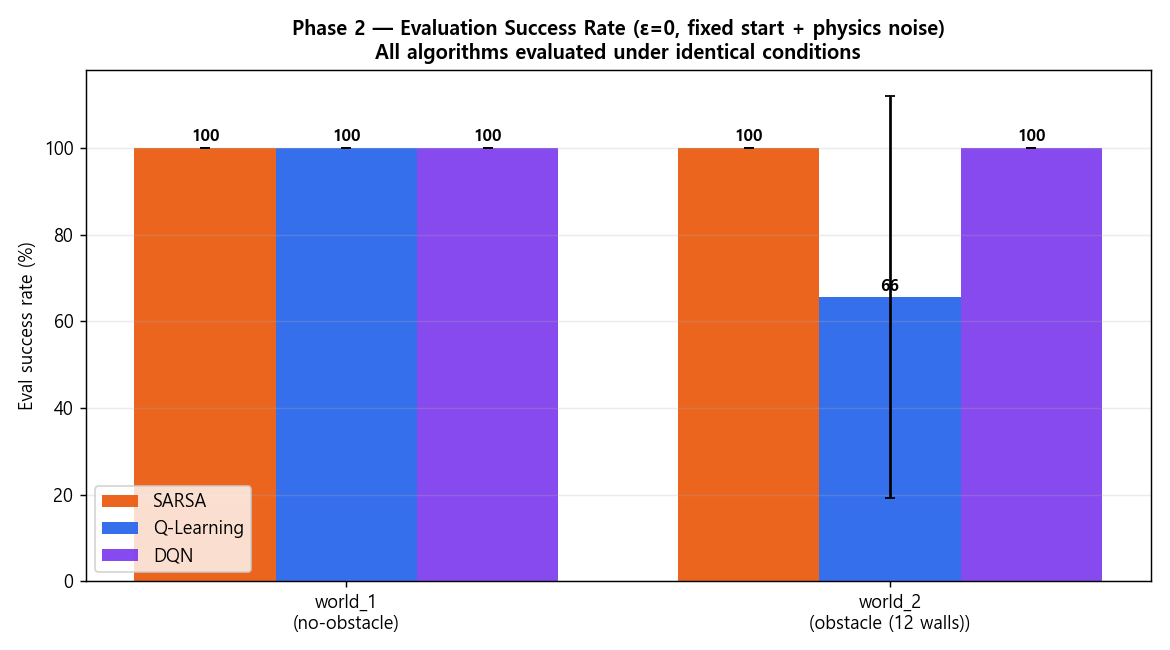
- Objetivo: Medir a capacidade pura da política gulosa aprendida (Greedy Policy, $\epsilon = 0$) sem exploração estocástica, validando a viabilidade de implantação no mundo real.
- Resultado: O Q-Learning tabular atingiu 92% de taxa de sucesso com demanda computacional 15 vezes menor em comparação com Deep Q-Networks (DQN).