[Stanford CS329A #2] Escalonamento de Computação em Tempo de Inferência: Além do Pré-Treinamento rumo à Inferência Ótima

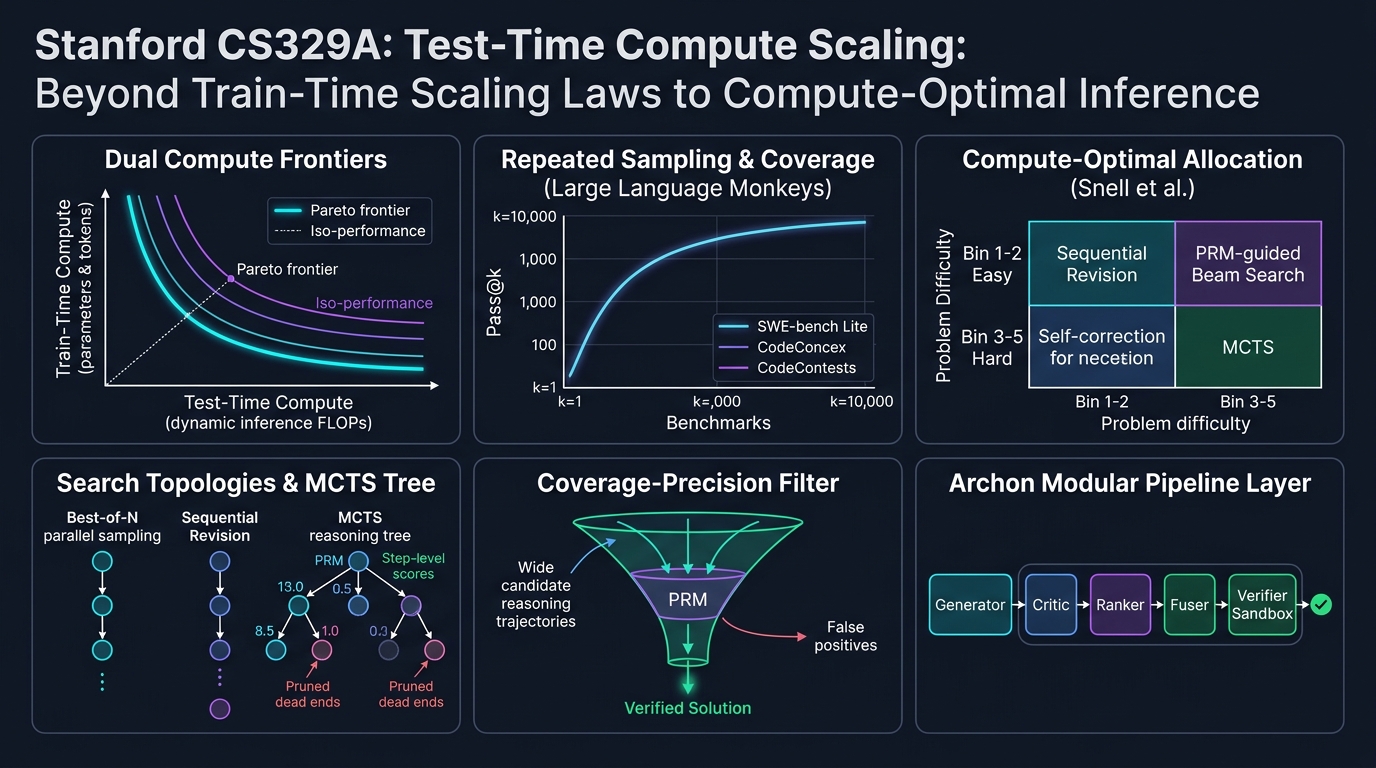
Boas-vindas ao segundo capítulo de nossa análise técnica sobre o curso de pós-graduação da Universidade de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA com Autoaperfeiçoamento, Outono de 2025).
Em nossa aula inaugural, mapeamos a transição macroeconômica dos preditores autorregressivos de próximo token para laços agênticos autônomos com retroalimentação do ambiente. Hoje, exploramos o alicerce computacional indispensável a essa autonomia: o Escalonamento de Computação em Tempo de Inferência (Test-Time Compute Scaling / Inference-Time Scaling).
Por mais de meia década, a doutrina hegemônica da indústria foi ditada pelas leis de escalonamento do pré-treinamento (Kaplan et al., Chinchilla): erguer clusters colossais de GPUs, expandir a contagem de parâmetros N e processar dezenas de trilhões de tokens web. No entanto, com os pesos θ congelados, o que ocorre quando nos recusamos a aceitar uma resposta sôfrega (greedy) gerada em 50 milissegundos? E se um agente investir 10 segundos, 1 minuto ou 10 minutos para explorar deliberadamente árvores de raciocínio, verificar passos intermediários e revisar suas hipóteses?
Com base nas evidências empíricas de Large Language Monkeys (Brown et al., 2024), no estudo Compute-Optimal Scaling de Snell et al. (Stanford/UC Berkeley, 2024) e no framework de arquitetura modular Archon, formalizamos como a alocação de FLOPs de inferência em substituição à mera escala de parâmetros redefine a inteligência artificial moderna.
flowchart TD
    subgraph PreTrain ["Fronteira Clássica: Escalonamento no Pré-Treinamento"]
        direction TB
        P1["Trilhões de Tokens Web (D)"] --> P2["Clusters Massivos de GPU (C_train)"]
        P2 --> P3["Modelo Denso Congelado (θ)"]
        P3 --> P4["Passagem Única Gananciosa (Custo Fixo O(1))"]
    end

    subgraph TestTime ["Fronteira CS329A: Escalonamento na Inferência"]
        direction TB
        T1["Pesos Base Congelados (θ)"] --> T2["Alocação Dinâmica de FLOPs na Inferência"]
        T2 --> T3{"Seleção Adaptativa por Dificuldade"}
        T3 -- "Baixa Dificuldade (Bin 1-2)" --> T4["Revisão Sequencial (Autocorreção)"]
        T3 -- "Alta Dificuldade (Bin 3-5)" --> T5["Busca em Árvore Guiada por PRM (MCTS / Beam Search)"]
        T4 --> T6["Verificador de Modelo de Recompensa de Processo (PRM)"]
        T5 --> T6
        T6 --> T7["Solução Verificada Matemática e Mecanicamente"]
    end

    PreTrain -.->|"Ponto de Inflexão: Saturação de Parâmetros"| TestTime