[Stanford CS329A #3] Verificação Robusta: Modelos de Recompensa de Processo (PRM), Ensembles e Supervisão Escalável

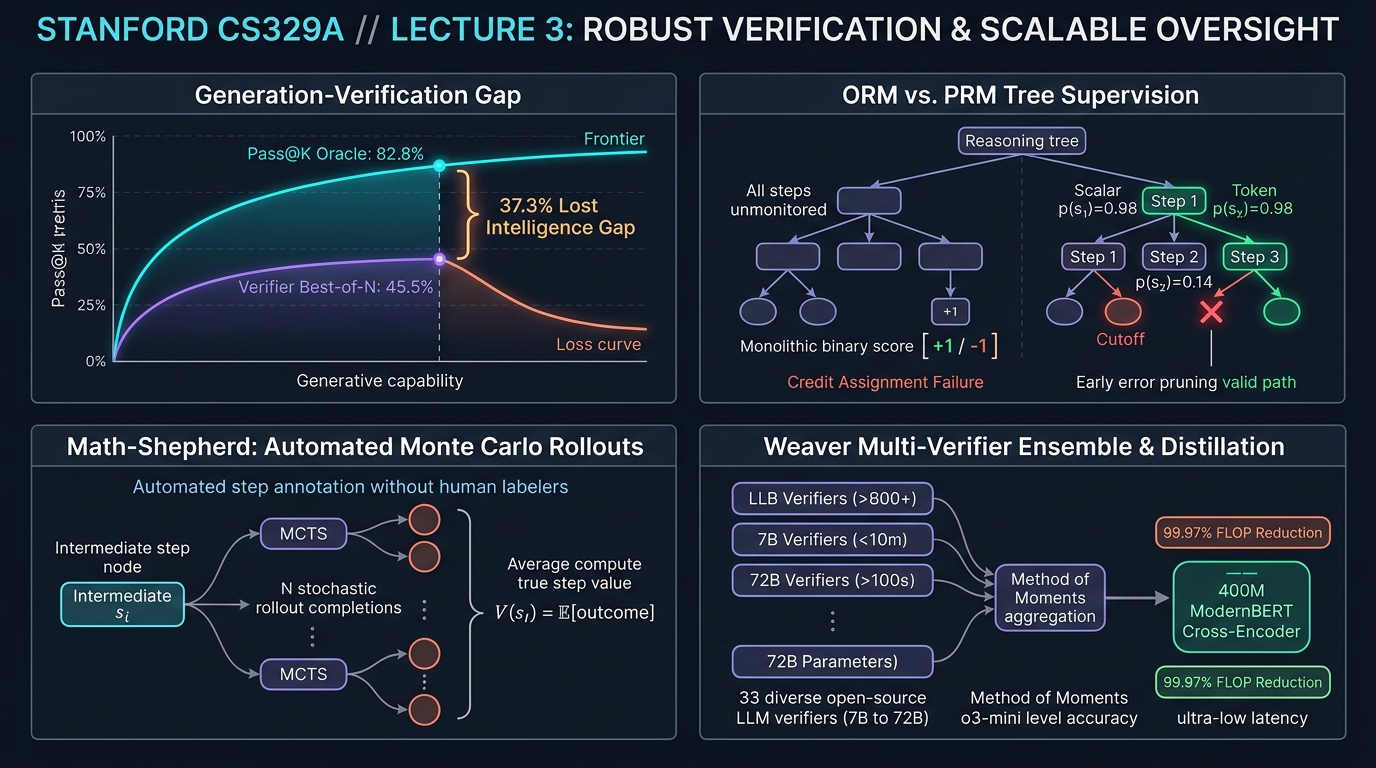
Boas-vindas ao terceiro capítulo de nossa imersão de engenharia sobre o curso de pós-graduação da Universidade de Stanford, CS329A: Self-Improving AI Agents (Outono de 2025).
Na Aula 2, investigamos os mecanismos de escalonamento computacional na inferência e chegamos a uma constatação incontornável: embora a geração de milhares de trajetórias ($pass@k$) eleve a cobertura teórica de respostas para além de 99%, esse potencial latente permanece inatingível sem um verificador (Verifier) de alta precisão. Quando submetido à votação por maioria simplista, o desempenho estabiliza-se num platô restritivo.
Hoje, confrontamos a engrenagem arquitetural que rompe esse gargalo: a Verificação Robusta (Robust Verification).
Matemáticos e engenheiros humanos raramente resolvem problemas intrincados num fluxo contínuo e sem pausas; eles rascunham uma etapa, checam a coerência algébrica, identificam deslizes de sinais e realizam retrocessos (backtracking) antes de avançar. Em contraste, os modelos de linguagem autorregressivos tradicionais operam estritamente para a frente. Havendo um desvio na dedução inicial, o modelo concebe alucinações progressivamente elaboradas para sustentar o erro primário.
Como podemos projetar verificadores desacoplados capazes de auditar passos intermediários, acusar falácias lógicas e guiar agentes em direção a respostas matematicamente comprovadas – sem gastar fortunas com anotação humana?
Apoiados nas contribuições de Cobbe et al. (GSM8K, OpenAI, 2021), na supervisão de processos de Lightman et al. (PRM800K, 2023), na anotação automatizada por Monte Carlo do Math-Shepherd (Yu et al., 2023) e no framework de ensemble Weaver (NeurIPS 2025), desvendaremos o estado da arte da Engenharia de Verificadores.
flowchart TD
    subgraph Gap ["O Dilema Central: A Lacuna Geração-Verificação"]
        direction TB
        G1["Pass@100 Cobertura Oráculo: 82.8% (Teto Teórico)"]
        G2["Acurácia Real por Votação por Maioria: 45.5% (Extração Efetiva)"]
        G1 -.->|"37.3%p de Inteligência Perdida por Erro de Seleção"| G2
    end

    subgraph Solutions ["Evolução dos Sistemas de Verificação em 4 Etapas"]
        direction TB
        S1["Modelos de Recompensa de Resultado (ORM)<br/>• Pontuação binária no desfecho (+1 / -1)<br/>• Falha de Atribuição de Crédito (Credit Assignment Failure)"]
        --> S2["Modelos de Recompensa de Processo (PRM800K)<br/>• Supervisão no nível do token p(step_i)<br/>• Poda precoce de desvios e regra do produto"]
        --> S3["Math-Shepherd (MCTS Não Supervisionado)<br/>• Rollouts de Monte Carlo automatizados<br/>• Supera PRMs rotulados manualmente"]
        --> S4["Ensemble de Verificadores Fracos Weaver<br/>• Método dos Momentos (Method of Moments) para 33 verificadores<br/>• Destilação em Cross-Encoder de 400M (99.97% corte de FLOPs)"]
    end

    Gap ==> Solutions