[Robótica Webots] Implementação do Q-Learning Tabular & Ajuste de Reward Shaping (#2)
· 2 min para ler

📌 Resumo dos Pontos Principais (TL;DR)
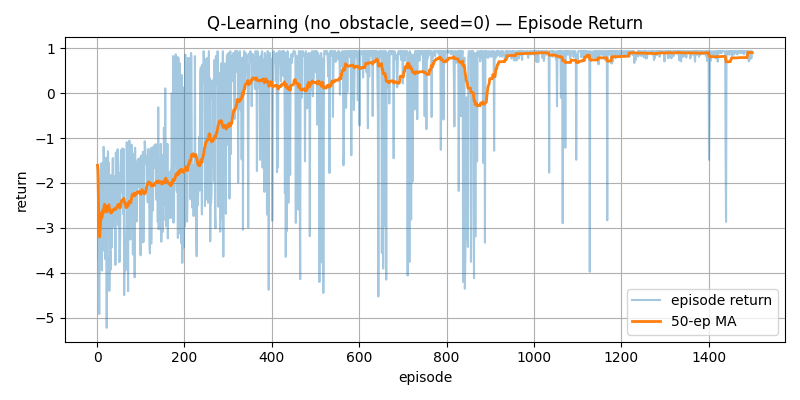
- Desafio: Recompensas esparsas (+1,0 ao atingir a meta, -1,0 em colisão) resultam em estagnação do aprendizado; o robô gira em círculos sem direção.
- Solução: Modelagem de recompensa densa (Reward Shaping) utilizando delta de distância ($\Delta d$) e bônus de velocidade para a frente, combinada com decaimento exponencial de $\epsilon$ ($0.95 \rightarrow 0.05$).