[Stanford CS329A #6] Escala em Treinamento e RL: DeepSeekMath, GRPO e Otimização Massiva de Raciocínio

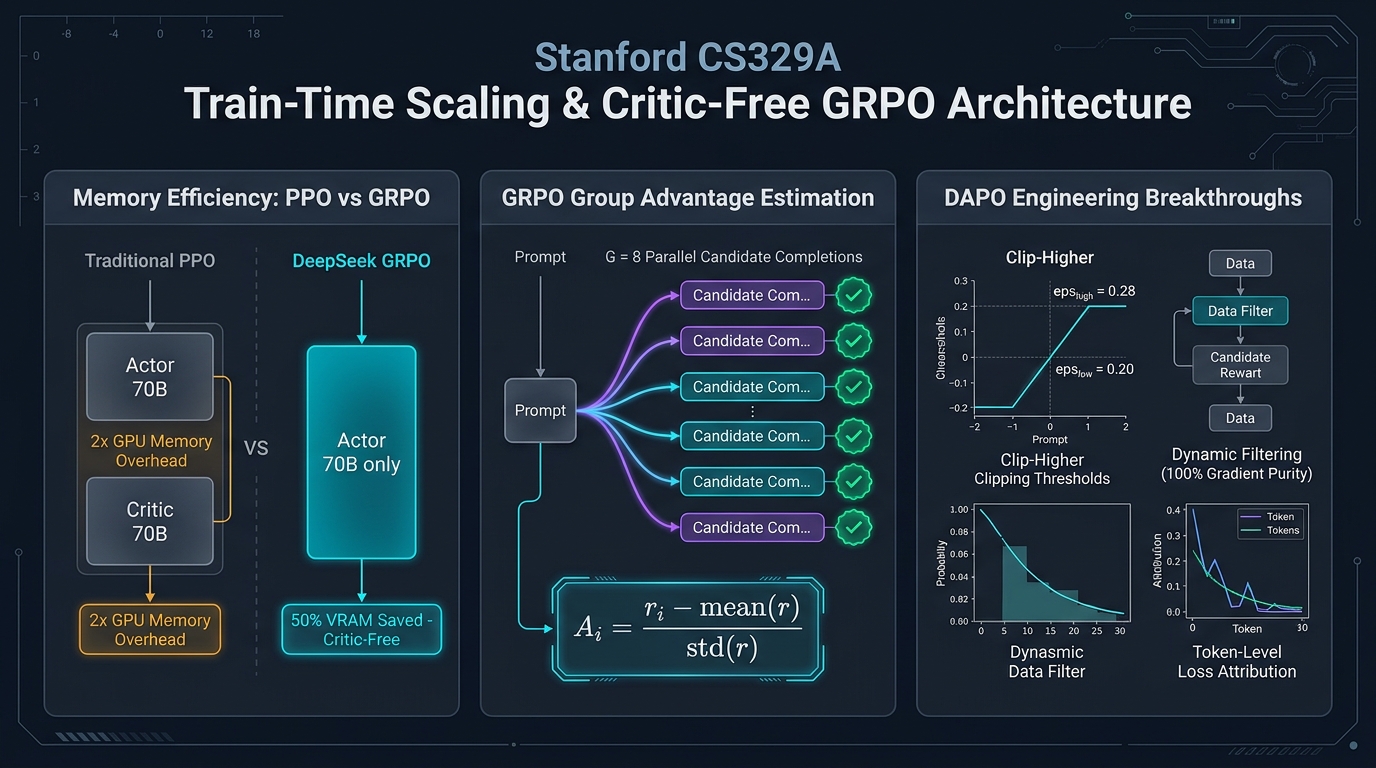
Boas-vindas ao sexto volume de nossa análise técnica detalhada do curso de pós-graduação da Universidade de Stanford, CS329A: Self-Improving AI Agents (Agentes de IA que se Autoaperfeiçoam, Outono de 2025).
Ao longo das Aulas 1 a 5 (Parte 1: Fundamentos), exploramos como extrair o potencial máximo de modelos pré-treinados estáticos aplicando computação no momento da inferência (Test-time Compute): estruturando árvores de busca MCTS, integrando erros de compiladores e filtrando saídas por meio de comitês de verificadores.
Entretanto, precisamos encarar um limite matemático inescapável: Conceder dez minutos adicionais a um estudante do ensino fundamental durante uma prova não o tornará capaz de demonstrar teoremas de cálculo diferencial e integral. Se as sinapses congeladas do modelo (parâmetros de peso, $\theta$) não codificam previamente esses conceitos dedutivos, gerar dez mil amostras ou recorrer a buscas exaustivas não produz inteligência genuína, mas mera casualidade estatística.
Hoje inauguramos a Parte 2: Treinamento e Evolução (Aulas 6 a 9), voltando-nos à questão fulcral da autonomia:
“Em vez de gastar recursos massivos a cada inferência, como podemos investir computação durante o treinamento para reescrever de modo permanente os pesos neurais do modelo e transformá-lo em um raciocinador de elite?”
Nesta Aula 6, dissecamos os três pilares que eliminaram a dependência de anotações humanas e inauguraram a era dos modelos de raciocínio profundo via Aprendizado por Reforço Pós-Treinamento (Post-Training RL):
- Auto-inicialização do raciocínio analítico: Self-Taught Reasoner (STaR, Zelikman et al., Stanford 2022).
- O fim da rede crítica (Critic): Group Relative Policy Optimization (GRPO, DeepSeekMath 2024).
- Escala industrial em 1.000 GPUs: Ceifamento desacoplado e amostragem dinâmica (DAPO, 2025).
flowchart TD
    subgraph ParadigmShift ["Mudança de Paradigma: Inferência vs Treinamento"]
        direction TB
        TestTime["Parte 1: Escala na Inferência (Test-Time Scaling)<br/>• Pesos neurais congelados (θ = constante)<br/>• Busca externa em execução (MCTS, ReAct, RLEF)<br/>• Elevada latência de resposta e alto custo operacional"]
        --> TrainTime["Parte 2: Escala no Treinamento (Train-Time RL)<br/>• Otimização ativa de gradientes de peso (θ ← θ + Δθ)<br/>• Internalização sináptica de instintos estratégicos via RL<br/>• Inferência ultrarrápida em passagem única (Single-Pass)"]
    end

    subgraph RLEvolution ["Evolução do RL para Raciocínio"]
        direction TB
        M1["STaR (Stanford 2022)<br/>• O modelo aprende com suas próprias deduções bem-sucedidas<br/>• Racionalização: dedução reversa a partir de dicas<br/>• Modelo 6B iguala o GPT-3 de 175B no CommonsenseQA"]
        --> M2["GRPO (DeepSeekMath 2024)<br/>• Eliminação total da rede crítica (Economia de 50% de VRAM)<br/>• Vantagem intra-grupo calculada por Z-scores<br/>• Modelo 7B de pesos abertos supera Google Minerva 540B"]
        --> M3["DAPO (Engenharia Aberta de Larga Escala 2025)<br/>• Ceifamento assimétrico Clip-Higher impede colapso de entropia<br/>• Amostragem dinâmica que filtra lotes sem variância<br/>• Qwen-32B supera recorde do DeepSeek-R1-Zero no AIME"]
    end

    ParadigmShift ==> RLEvolution