Pular para o conteúdo principal

3 publicações com a etiqueta "webots"

Ver todas as etiquetas

[Robótica Webots] Superando Mínimos Locais em Ambientes com 12 Obstáculos: Simulação Headless Multi-Seed (#3)

· 2 min para ler
Jaybee
AI & Robotics Engineer

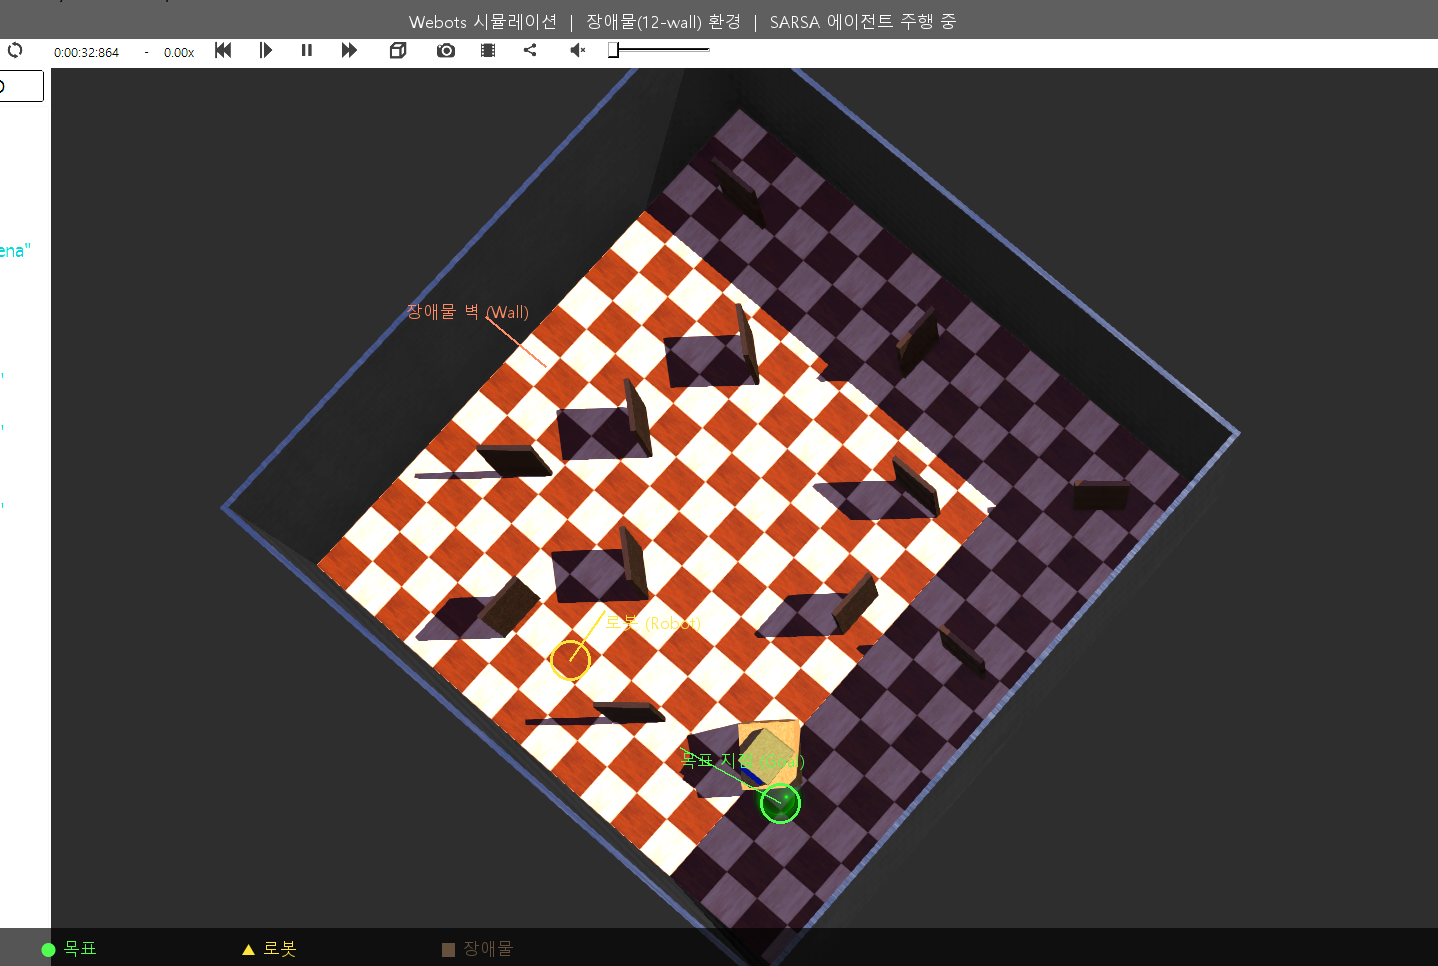
Arena de Simulação obstacle12

📌 Resumo dos Pontos Principais (TL;DR)

  • Desafio: Quando o alvo está situado logo atrás de uma parede, a recompensa por proximidade puxa o robô diretamente contra o obstáculo, prendendo-o em um mínimo local.
  • Solução: Repulsão dinâmica por proximidade na função de recompensa e aceleração do treinamento via simulação headless com 10 sementes aleatórias.
[Robótica Webots] Implementação do Q-Learning Tabular & Ajuste de Reward Shaping (#2)

· 2 min para ler
Jaybee
AI & Robotics Engineer

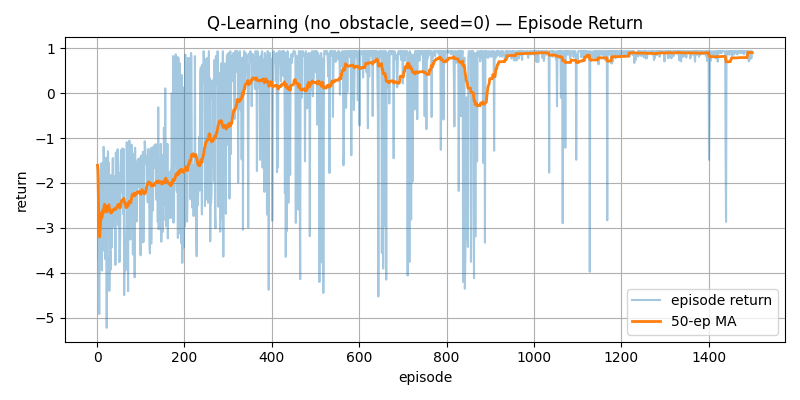
Curva de Recompensa de Treinamento

📌 Resumo dos Pontos Principais (TL;DR)

  • Desafio: Recompensas esparsas (+1,0 ao atingir a meta, -1,0 em colisão) resultam em estagnação do aprendizado; o robô gira em círculos sem direção.
  • Solução: Modelagem de recompensa densa (Reward Shaping) utilizando delta de distância ($\Delta d$) e bônus de velocidade para a frente, combinada com decaimento exponencial de $\epsilon$ ($0.95 \rightarrow 0.05$).

[Robótica Webots] Navegação Autônoma com Q-Learning: Discretização em 648 Estados & Arquitetura Socket (#1)

· 2 min para ler
Jaybee
AI & Robotics Engineer

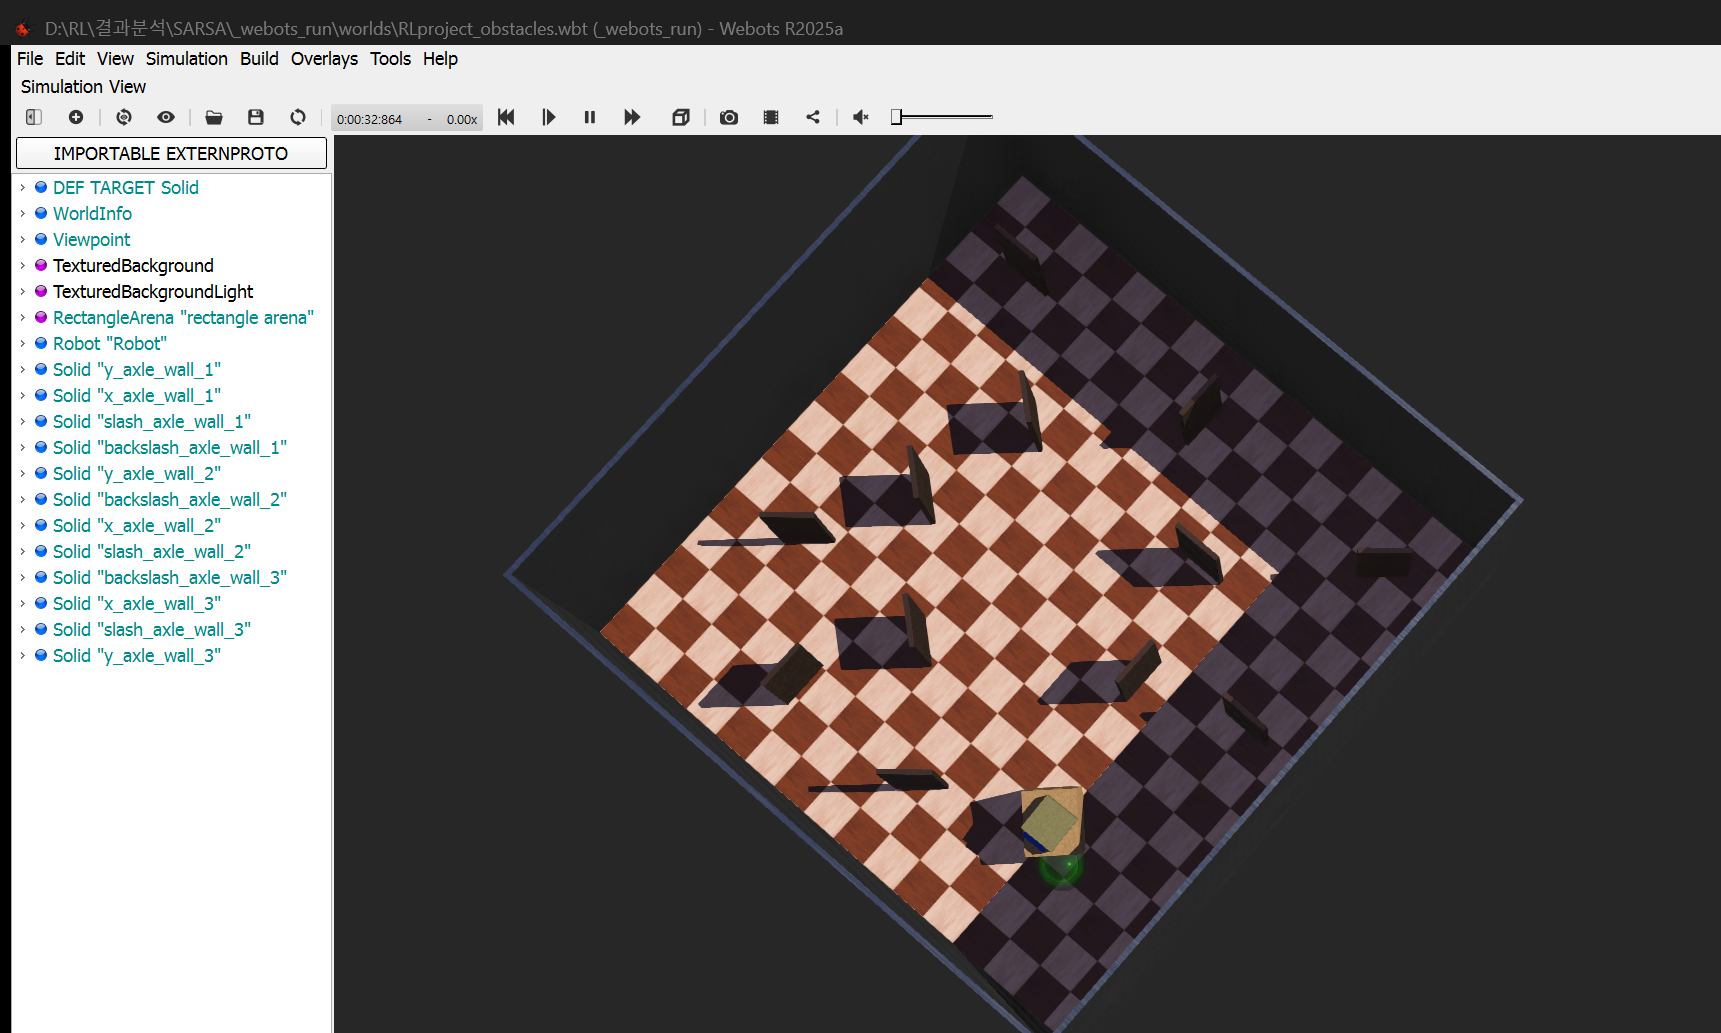
Ambiente de Simulação Webots

📌 Resumo dos Pontos Principais (TL;DR)

  • Desafio: Dados contínuos de sensores (distância e ângulo para a meta) causam explosão do espaço de estados no Q-Learning tabular; a comunicação IPC síncrona com o simulador Webots exige latência mínima.
  • Solução: Redução para 648 estados discretos distribuídos em 3 setores de distância e 4 zonas de orientação, operados por um servidor socket TCP em Python de alto desempenho.