[Maeumjigi 心语伴侣毕业设计开发日志 #12] 70B 超大模型领域微调与 GPU 显存 (OOM) 极限拉锯战
· 阅读需 3 分钟

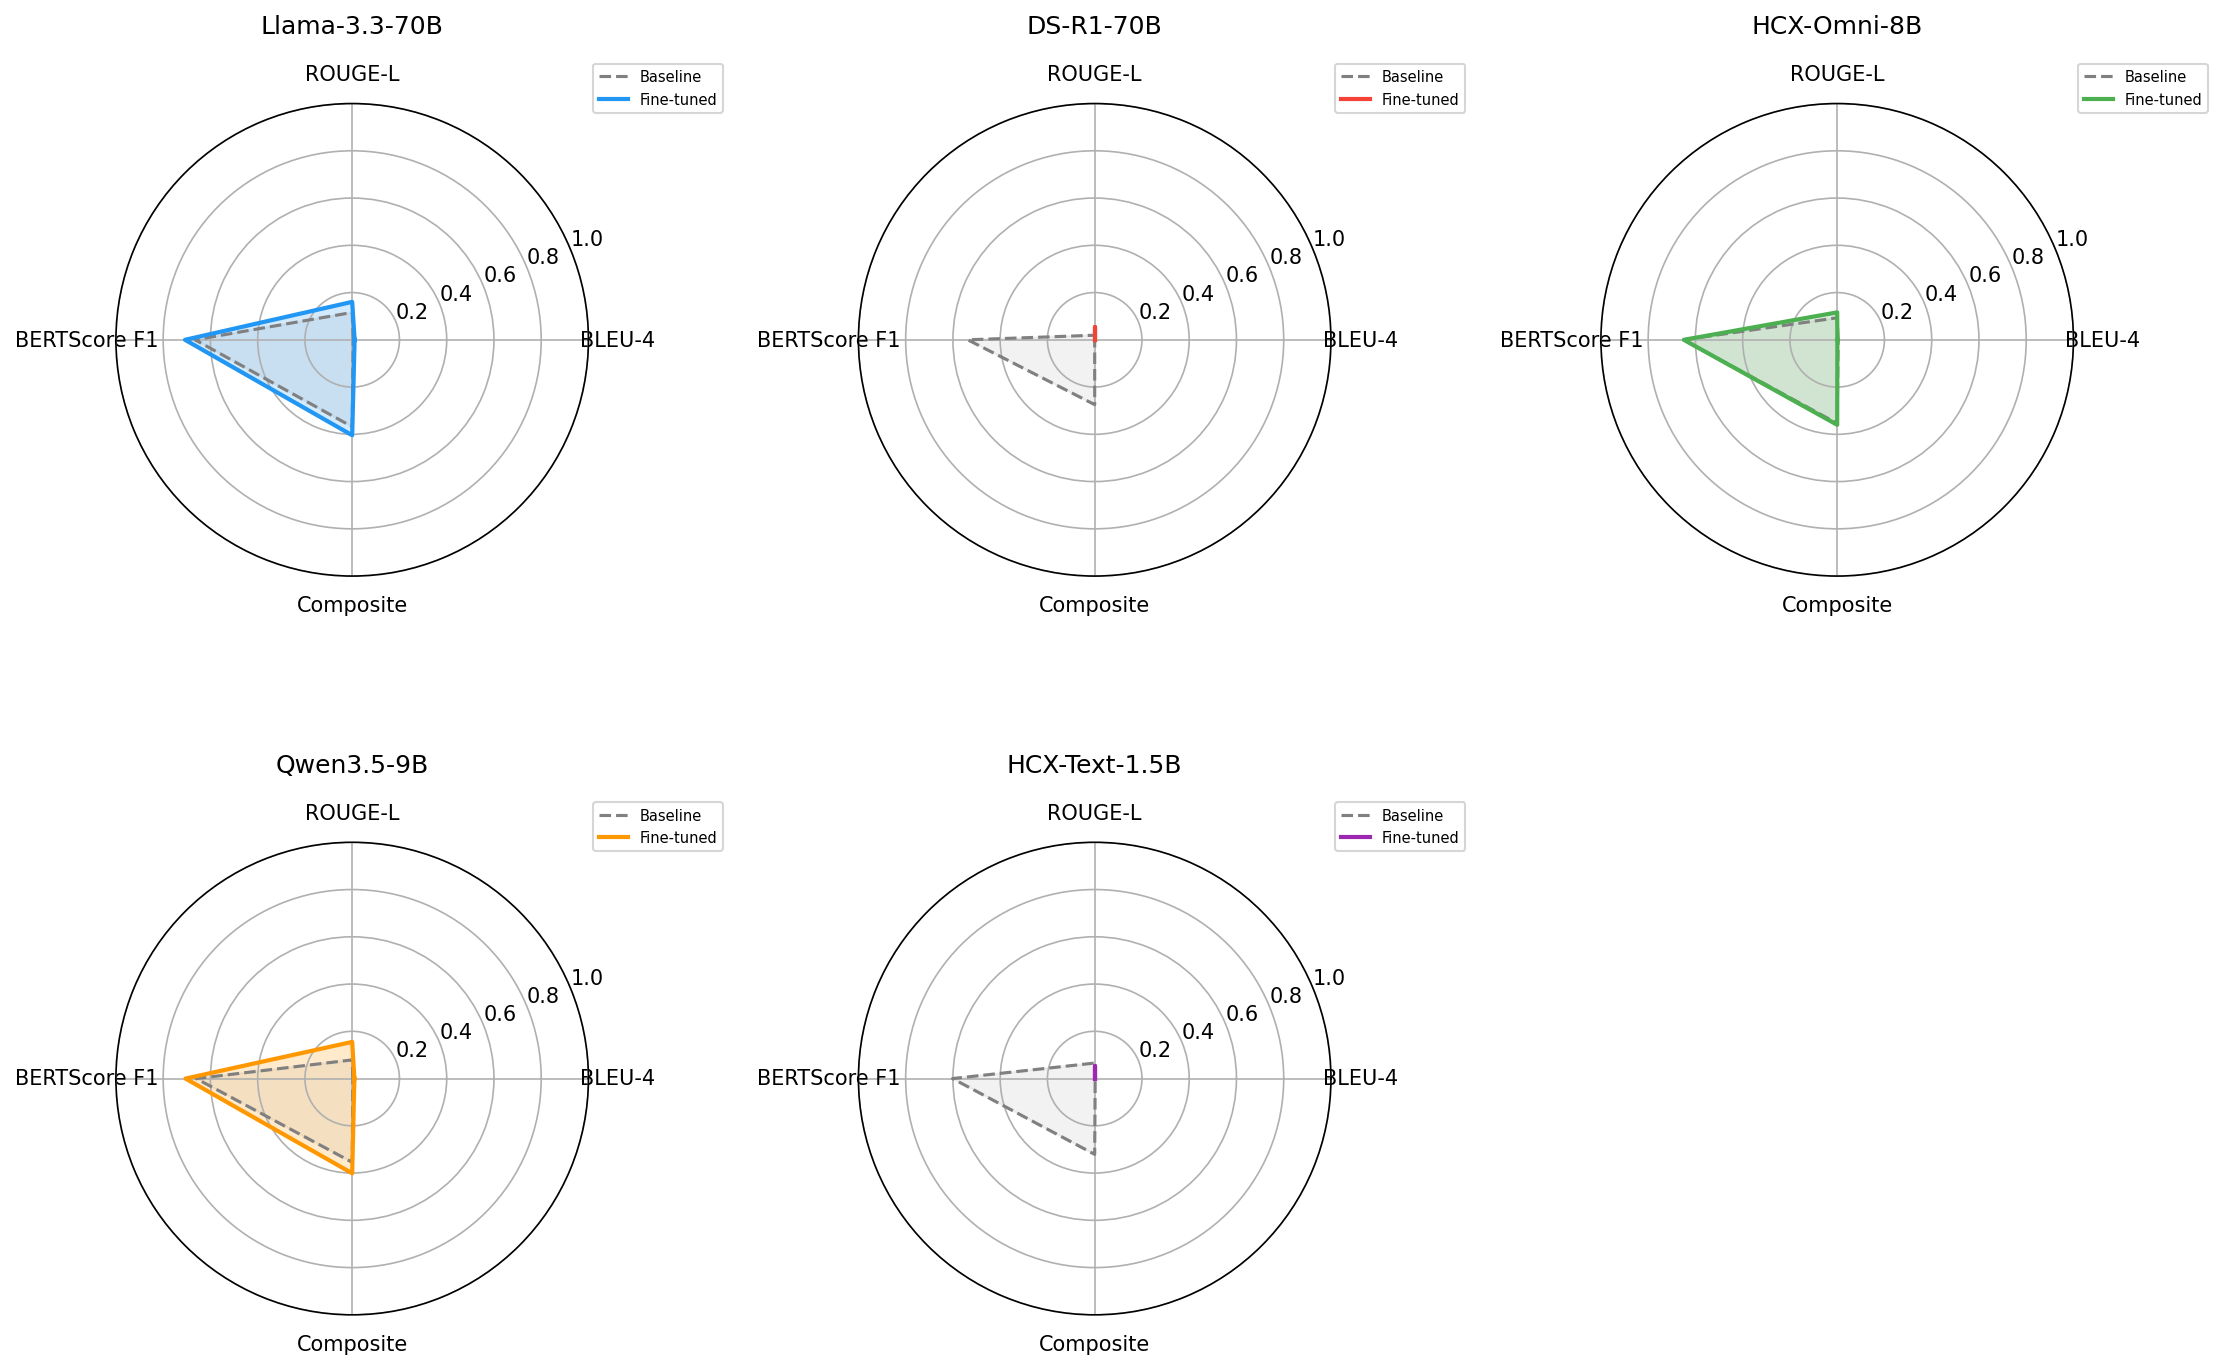
5 月 3 日,在彻底摸透 8B 小参数模型的技术脉络后,我们团队终于向大语言模型的性能天花板发起冲锋——挑战 70B (700 亿超大参数量) 模型的领域微调。 我们同时锁定了 Llama 3.3 70B 与 DeepSeek-R1 70B 两大旗舰底座,但不出所料,瞬间迎面撞上了严苛的物理显存高墙。
70B 庞然大物降临与显存溢出 (OOM) 绝望阴霾
- 问题背景:豪情万丈地将 70B 微调代码部署至 GPU 服务器刚一跑通,各种显存崩溃报错便接踵而至。
- 推进过程:
“我已将服务器上的 fine_tuning 目录及脚本同步拉取至本地。请通读代码并排查导致崩溃的根本死穴。” “针对 DeepSeek-R1 的 70B 模型结构无需调整注意力掩码吗?请评估潜在报错点。”
- 成果沉淀:刚在监控面板中分析
train_log.jsonl并估算收敛耗时没几分钟,70B 参数量庞大的权重与反向传播激活值便瞬间吞噬了整块 GPU 显存,控制台无情抛出CUDA out of memory (OOM)致命异常!
GPU 显存极致瘦身战役:QLoRA 与超参动态压榨
- 问题背景:“服务器显存利用率已死死锁死在 100% MAX!”若不能将显存开销压缩至物理安全线下,训练将被反复强行中止。
- 推进过程:
“调整参数为 save_steps = 50, save_total_limit = 10, eval_steps = 50, patience = 10。” “请对设定的早停 (Early Stopping) 条件进行收敛合理性评估。” “已在 ft_configs.yaml 中将两大 70B 模型的 max_seq_length 砍至 512,为何 nvitop 监控依然显示显存死死顶格满载?”
- 成果沉淀:我们果断将单次注意力序列长度 (
max_seq_length) 腰斩至 512,并大幅精简检查点持久化超参数。然而通过nvitop实况监测发现,显存依然在断崖边缘剧烈颠簸,更在第 100~150 步之间发生训练进程假死冻结。
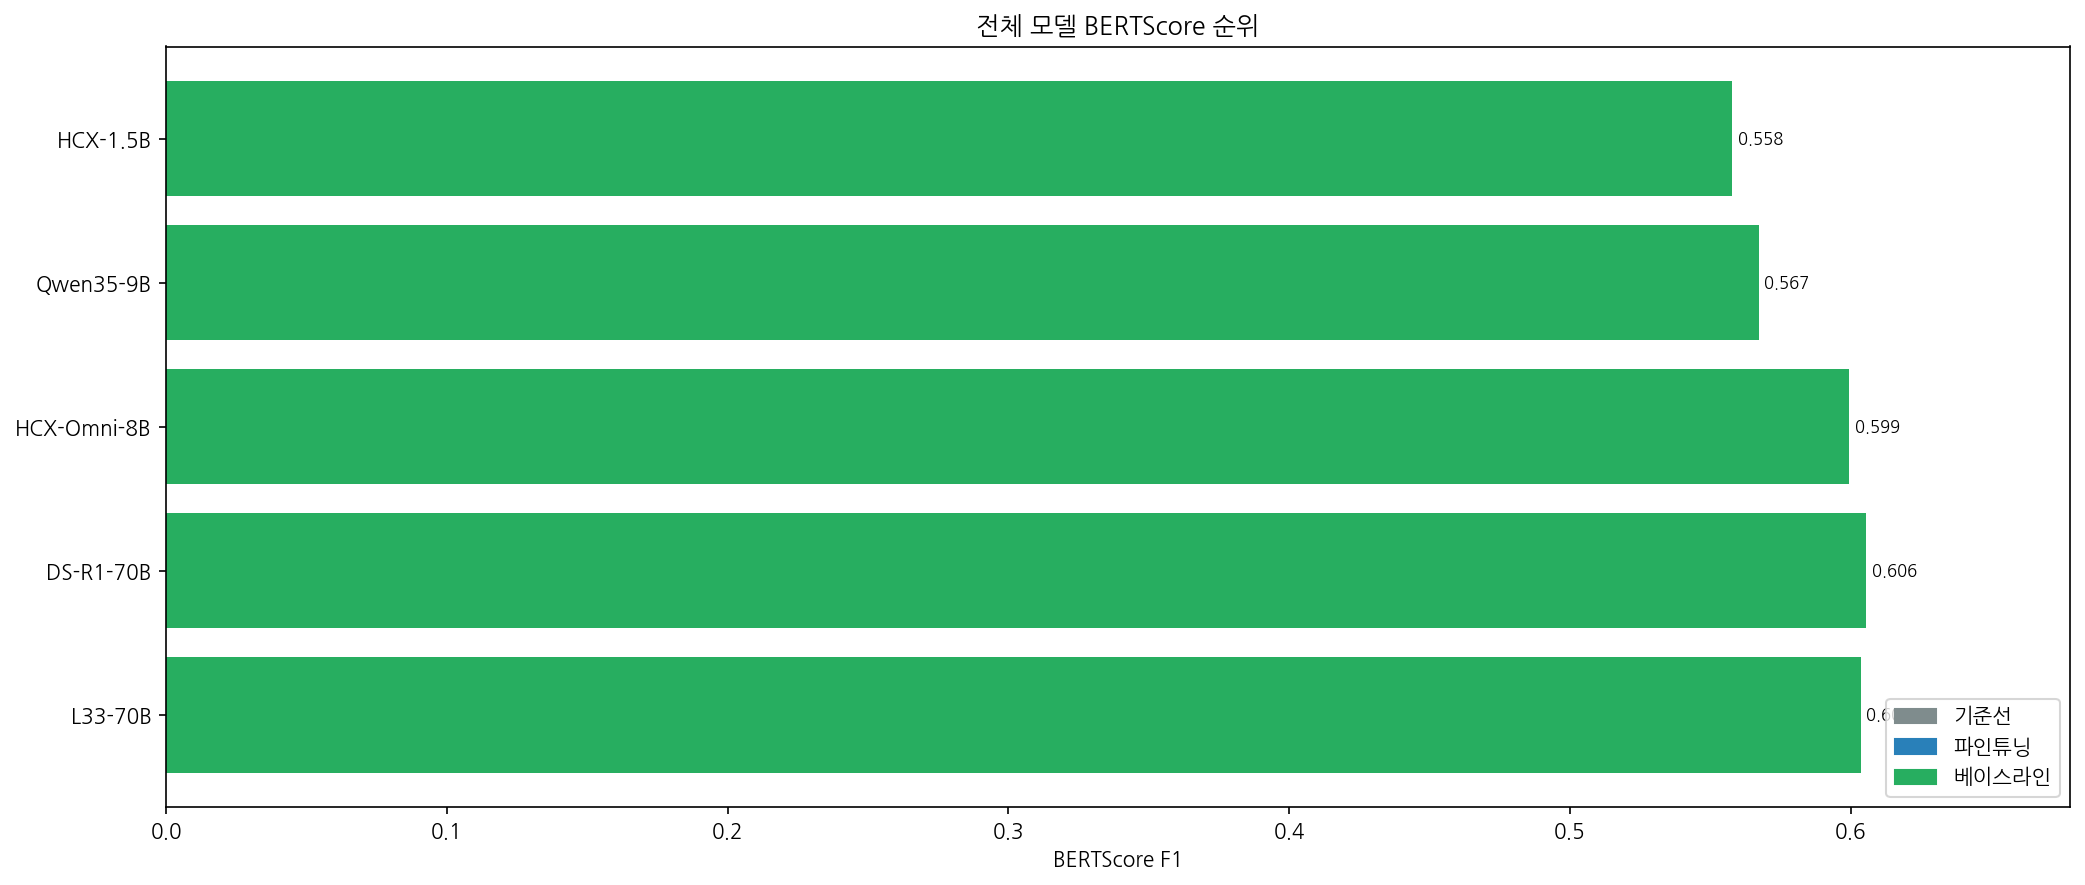
驯服 70B 这种吞金巨兽绝非易事。我们通过 AI 高频投喂堆栈日志寻找优化突破口,反复验证 4-bit NF4 量化、Paged AdamW 优化器与梯度检查点 (Gradient Checkpointing) 等极致降显存黑科技。 我们究竟能否成功跑完 70B 模型的完整微调周期?悬念将在下一篇开发日志全面揭晓!