[Maeumjigi 心语伴侣毕业设计开发日志 #13] 70B 算力瓶颈与中轻量级模型 (HCX, Qwen) 战略迂回

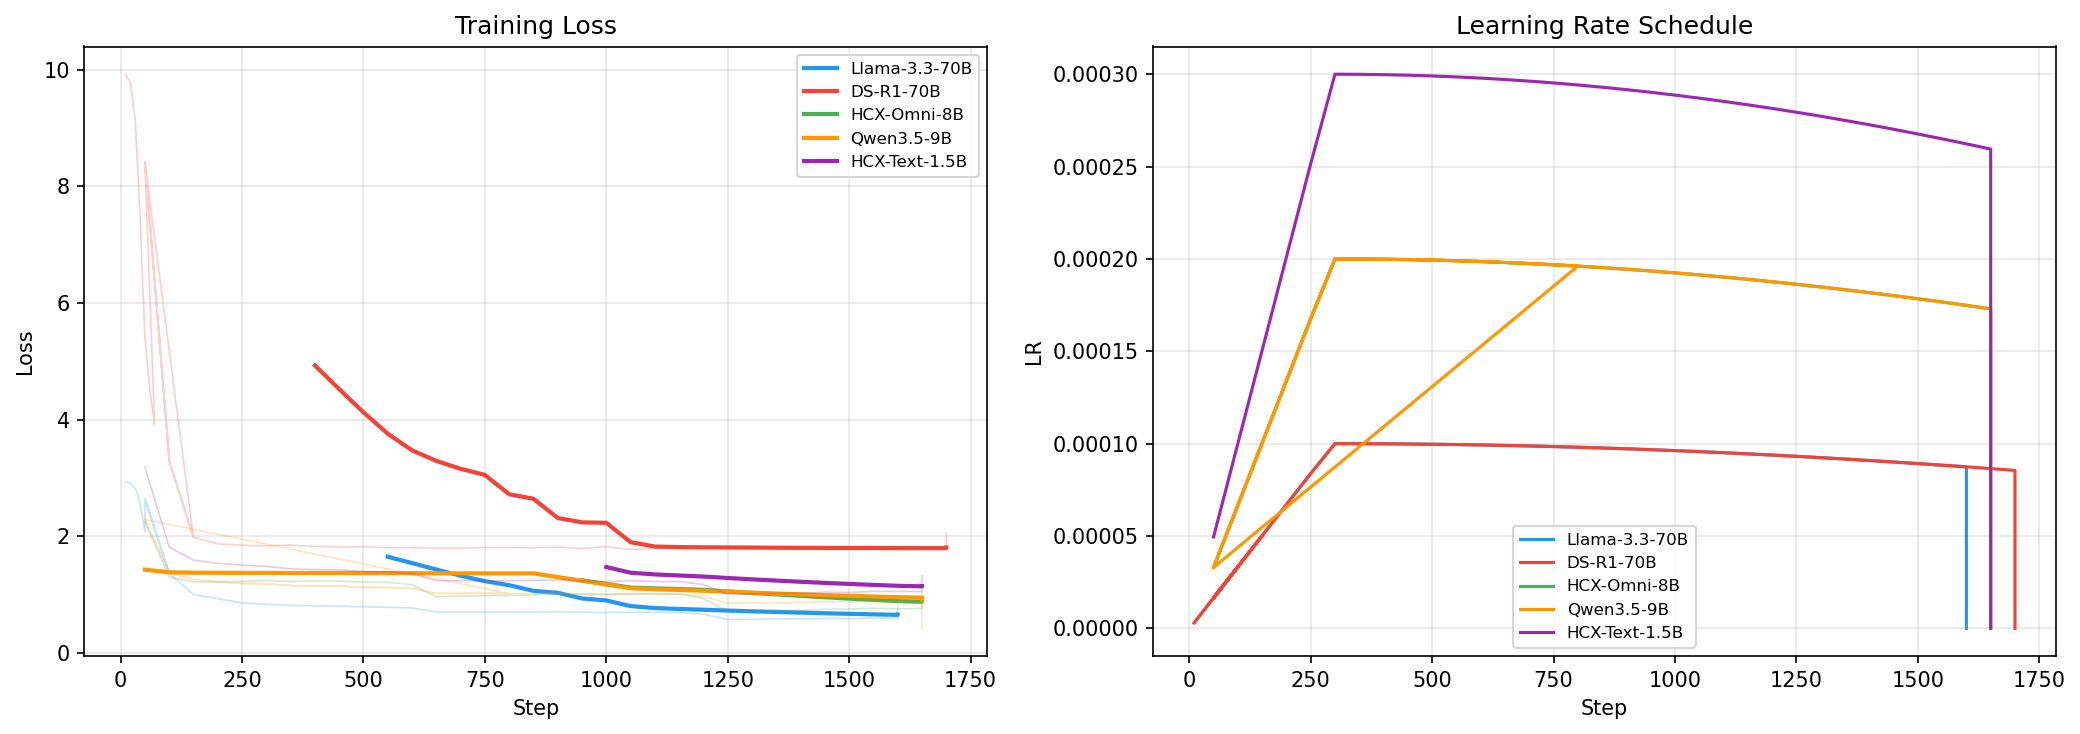
在领教了 70B 庞大参数量在微调过程中的显存地狱后,5 月 4 日,我们果断决定实施战略转向。
尽管我们曾通过将 Batch Size 压榨至极限,勉强将 70B 模型(Llama 3.3, DeepSeek-R1)推到了 checkpoint-1200 与 1300,但极其漫长迟缓的训练周期使得整体科研迭代效率极度低下。
战略迂回:转向中轻量级基座模型(1.5B ~ 9B)
综合考量物理 GPU 服务器算力上限与毕业设计答辩截稿日期,全盘孤注一掷在 70B 巨型模型上显然具有极高的延期风险。 为此,我们果断调转船头,将微调实验重点迁移至性价比极高、推理延迟更低的中轻量级开源模型矩阵:HCX-Omni-8B、Qwen35-9B 以及 HCX-Text-1.5B。
“当前针对 HCX-Omni-8B、Qwen35-9B 与 HCX-Text-1.5B 设定的超参数训练周期依然过长,业内针对该尺寸模型的经典超参分布是怎样的?” “盲目上调 Batch Size 会对心理对话任务的收敛稳定性与泛化能力带来何种冲击?”
参数体量变小并不意味着万事大吉。为了在安全显存下跑出最高吞吐,我们逐步微调 Batch Size 与梯度累加步数,与 AI 展开深度技术辩论以寻觅最佳超参平衡点。我们率先完成了最小尺寸模型 HCX-Text-1.5B 的基线收敛评测,借以校准全盘微调的技术航向。
检查点持久化异常与底层系统内核兼容性暗礁
在推进 HCX-Omni-8B 顺利训练至第 50 步并尝试自动序列化保存检查点时,系统迎面撞上了另一块隐蔽的技术暗礁:
[RANK 0] Detected kernel version 5.4.0, which is below the recommended minimum of 5.5.0; this can cause the process to hang.
...

JSONDecodeError Traceback (most recent call last)
---> 60 trainer.train(resume_from_checkpoint=...)
控制台不仅警告 Linux 操作系统内核版本偏低可能导致分布式进程假死挂起,更抛出了致命的 JSONDecodeError——检查点元数据文件在写盘瞬间发生并发损坏,导致训练无法平滑接续。
“如果模型在云端训练中途意外崩溃中断,能否从最近完好的检查点精准断点续训?”
虽然 Hugging Face Trainer 原生支持断点恢复 (resume_from_checkpoint),但一旦检查点文件本身在断电或并发写盘时损坏,整轮训练便前功尽弃。即使模型尺寸已经大幅缩减,深层框架与底层基础设施的种种兼容性隐患依然让我们鏖战了一整天。
我们究竟能否成功跨过暗礁,将中轻量模型稳稳送入高效收敛轨道?